EviRank: 多模态图像重排序的结构化相关性证据
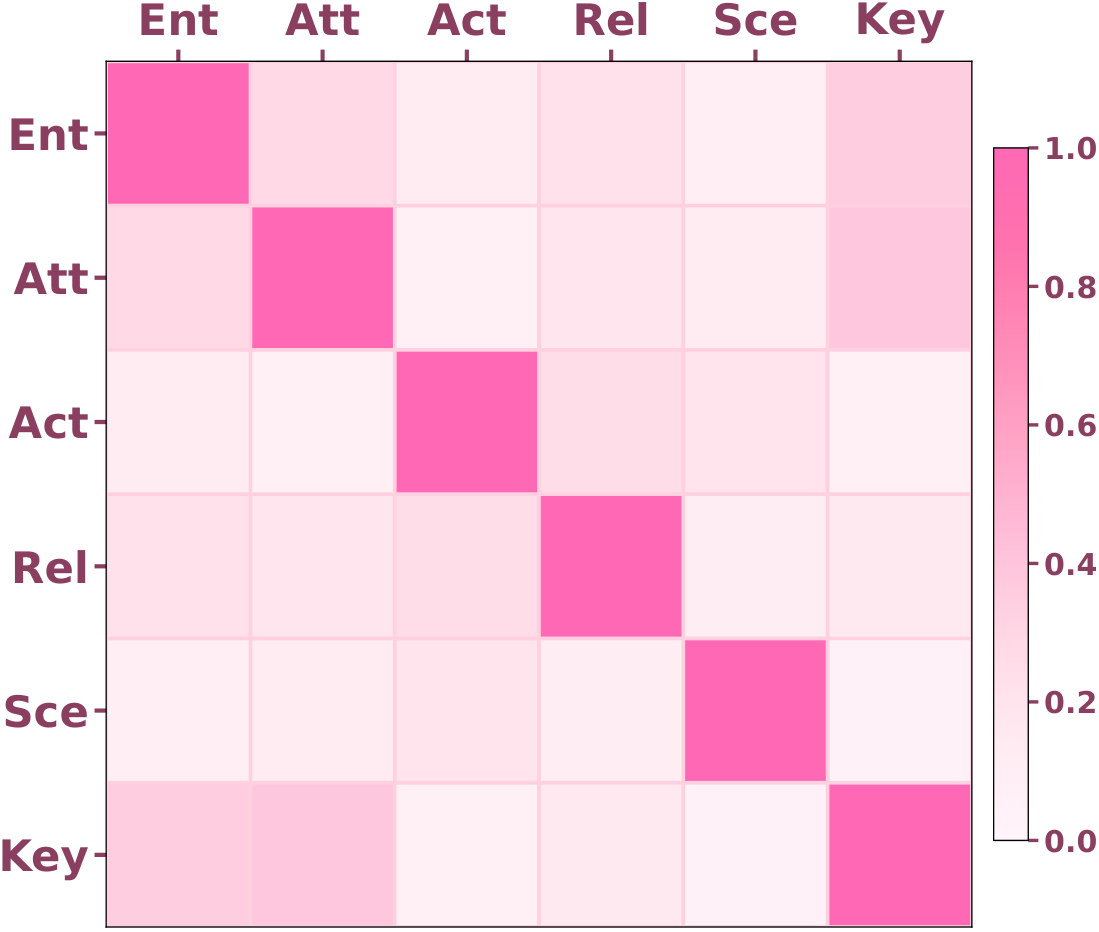
现实世界的图像搜索查询往往是多模态且组合式的:“找这件衬衫的粉色款”既指定了要保留的实体,也指定了要修改的属性,以及需要忽略的背景。然而,现有重排序器要么将这种多面相关性压缩成一个不透明的嵌入,要么依赖自由形式的思维链,容易遗漏或幻觉化细粒度约束。 借鉴 NLP 中基于评分细则(rubric)和检查清单(checklist)的评估方法,我们将多模态图像重排序重新定义为语义约束满足问题,并提出 EviRank。它将任意查询(纯文本、纯图像或组合式)解析为统一的证据包:跨六个语义槽(如实体、属性、关系)的类型化标准,每个标准标记为必需、禁止或可忽略。重排序因此简化为证据条件验证,在无需训练的过程中结合确定性评分细则和基于证据的列表式比较。显式证据还可作为结构化监督,用于可选地蒸馏轻量级学生模型。 在涵盖文本到图像、图像到图像以及组合图像检索的五个基准上,EviRank 取得了最先进性能,且蒸馏出的学生模型在成本大幅降低的同时保留了教师模型 90% 以上的能力。
论文精读
TL;DR EviRank 把多模态图像重排建模为语义约束满足:解析查询为六类带 required / forbidden / ignorable 标签的证据,用确定性 rubric 评分与 listwise 比较做免训练验证,在五个 benchmark 上达到 SOTA,蒸馏学生以低成本保留超 90% 能力。
问题
问题背景
多模态图像检索正从单纯语义相似向组合式查询(composed query)理解演进,例如“保留这件衬衫的款式,改为粉色并去掉 logo”,要求模型同时处理实体、属性、关系等多维约束。
现有方法局限
- 嵌入压缩式重排序器:查询与候选图像被编码为稠密向量,靠相似度排序,但向量空间无法显式表达“必须保留 / 必须修改 / 必须忽略”等独立条件,约束间易混淆或丢失。
- 自由形式思维链:让 LLM 生成自然语言推理再打分,但推理过程缺乏结构化约束,容易遗漏细微的禁止条件(如“领口形状不变”)或产生幻觉,且不可审计。
为什么这个问题难/重要
组合式查询的语义约束是多维、类型化且带优先级(required / forbidden / ignorable)的,必须显式提取并逐条验证,同时保证推理可解释、成本可控。业界对多模态搜索的准确率与可解释性要求持续提升,训练高效、零训练的方法尤为稀缺。EviRank 将其形式化为语义约束满足问题,用六槽证据包 + 确定性 rubric 评分 + 列表对比,无需训练即达 SOTA,还能蒸馏出轻量学生。
行业类比
类比电商视觉搜索:用户上传衬衫图片并要求“粉色、长袖、去掉 logo”,系统需逐条核对每个条件,而非仅推荐整体相似的图片。
核心洞察
- **证据包显式化语义约束**:EviRank 把多模态图像重排序定义为**语义约束满足** 问题,将查询解析为跨六个槽位的类型化证据(实体、属性、关系等),并标注 required / forbidden / ignorable。相比嵌入方法把相关性压缩成不透明向量、或自由式 CoT 容易遗漏细粒度约束,这种结构化表示让验证过程可解释、可审计,且无需训练即可达到 SOTA。
- **证据作为结构化蒸馏监督**:EviRank 的显式证据不仅用于教师模型的无训练重排序,还作为中间监督训练学生模型。学生模型在推理时不依赖证据生成,因此推理成本大幅降低,同时保留 90% 以上教师能力。这提供了一种新的蒸馏范式:利用可解释的符号化中间表示替代传统软标签,使得知识传递更高效且可控。
- **统一异构查询表示**:EviRank 将 text-only、image-only 和 composed 查询统一映射到同一证据包表示,使重排序器可以跨任务复用。现有方法通常为不同查询模态设计独立的重排序模块或特征融合策略,而统一证据抽象简化了系统架构,并提升了跨模态泛化能力。
方法
输入与输出
EviRank 的输入是任意形式的查询(纯文本、纯图像或组合查询)以及一组候选图像;输出为按相关性重排后的图像列表。
关键模块
- 查询到证据挖掘:先将查询归一化(图像查询转为 caption,组合查询融合语义),再通过 LLM 提取结构化证据包。证据包覆盖六个语义槽:
entities、attributes、actions、relations、scene、key details,每个槽内的具体标准标注为required(必须满足)、forbidden(必须不满足)或ignorable(可忽略)。 - 证据条件验证与重排:采用训练-free 的两阶段流程。确定性 rubric 评分 根据证据包对每张候选图像逐条检查并打分;证据增强的 listwise 细化 将证据作为上下文,对候选列表进行成对比较或整列表排序,修正 rubric 的误判。
- 结构化蒸馏:教师模型产生的证据与重排分数作为监督,训练轻量学生模型。学生仅需图像与查询嵌入,训练目标包括分数标准化和困难对加权(按分数差距倒数加权),并添加槽辅助头以保留结构化信息。
差异点
与依赖不透明嵌入或自由形式思维链的现有重排器不同,EviRank 通过显式结构化证据包将多模态重排转化为约束满足问题,既避免细粒度约束丢失,又减少幻觉,且教师重排过程完全无需训练。
实验
实验设计
覆盖三类多模态检索任务(文本到图像、图像到图像、组合图像检索)的五个基准,对比近期 embedding-based re-rankers。EviRank 采用两阶段 training-free 流程:先 deterministic rubric scoring,再 evidence-grounded listwise refinement。证据包包含六类语义槽(entities, attributes, relations, scene, actions, key details),每个槽标记 required / forbidden / ignorable。另外使用结构化证据作为监督,蒸馏轻量学生模型(学生仅在训练时使用证据)。
关键发现
EviRank 在所有基准上达到 SOTA,表明显式语义约束验证优于隐式 embedding 或自由形式 CoT。蒸馏学生保留 >90% 教师能力,推理成本显著降低。消融与组件分析显示 rubric 与 listwise 互补;证据模式稳定性好,收益来自结构化证据而非 prompt 措辞。
对比解读
相比 embedding-based re-rankers,EviRank 无需训练,避免数据分布过拟合和标注成本;相比 CoT 方法,结构化槽位强制覆盖细粒度约束,减少遗漏与幻觉。但 training-free 流程可能因多次验证引入延迟,蒸馏学生解决了部署效率问题,保留大部分能力的同时大幅降低计算开销。
行业影响
落地场景
EviRank 适用于需要精确多模态组合查询的产品,尤其适合语义约束复杂的图像检索场景:
- 电商商品搜索:用户上传参考图并追加文字约束,如“把这件衬衫换成粉色、去掉 logo”,系统需同时满足实体保留、属性修改、关键细节排除。
- 创意素材库 / 数字资产管理平台:设计师检索“有山的风景照,但前景不要有人”,EviRank 的
required / forbidden / ignorable标注能精准执行约束。 - 社交媒体内容审核与推荐:结构化证据包提供可审计的中间表示,便于规则化和人工复核。
商业价值
- 降本:训练免费(training-free)的 teacher 无需标注数据即可部署,大幅降低冷启动成本;同时可蒸馏轻量 student,推理成本下降但保留 teacher 90% 以上能力。
- 增收 / 体验提升:在电商搜索中,更精确的重排直接提升点击率和转化率;在素材库中,减少人工翻页和二次筛选时间。
- 迭代效率:结构化证据抽取与调分逻辑解耦,证据 schema 可独立优化,产品侧能快速调整约束规则而不需重新训练。
与现有产品/工作流的接口
EviRank 可无缝插入现有检索 pipeline 的重排阶段(stage-2 re-ranker):
- 上游粗排(embedding 检索或 BM25)召回候选集。
- Query 经 LLM 解析为六槽证据包(
entities、attributes、relations、actions、scene、key details)。 - EviRank teacher 进行确定性 rubric 评分 + evidence-grounded listwise 比较,输出最终排序。
- 如需降本,可蒸馏出轻量 student 作为在线重排模型直接替换。
电商 use case:用户上传衬衫图片并输入“换粉色、去图案”,EviRank 将
entities(衬衫) 标为 required,attributes(粉色) 标为 required,key details(图案) 标为 forbidden,对候选商品确定性打分,显著提升 CTR。内容平台 use case:设计师检索“有山的风景照,前景不要有人”,EviRank 精确保留场景约束并排除人物,减少无效浏览,提升素材复用率。
局限
- **依赖 LLM 证据提取质量**:EviRank 的核心假设是 LLM 能准确解析查询并生成结构化证据,但论文未系统评估证据提取在低质量或对抗性查询下的鲁棒性。虽然 4.5 节稳定性实验表明模式稳定,但缺少对 LLM 幻觉、模糊查询或非规范语言输入的影响分析。此外,预定义六槽 (entities, attributes, relations, scene, key details, actions) 可能无法覆盖所有语义约束类型(如数量、时态、语用条件),导致对超出 schema 的查询被迫忽略或错误归类。这限制了方法在开放域检索中的泛化能力,实际部署需增加证据校验或人工审核环节。
- **训练免费但推理开销与蒸馏折中**:论文强调 training-free,但证据提取和列表式比较在推理时需要对每个查询调用 LLM 并处理候选集,计算成本可能高于纯 embedding 重排。蒸馏学生模型可降低成本,但实验仅报告在现有基准上保留 90% 能力,未评估在分布外查询或长尾组合上的下降程度。与直接优化 embedding 的模型相比,EviRank 的部署需要额外的 LLM 推理资源,可能不适合低延迟或大规模场景。工程中需权衡证据质量与成本,且学生模型可能继承教师对结构化证据的依赖,无法完全独立处理原始查询。
- **实验覆盖有限,未比较生成式检索**:实验使用五个基准(如 CIRR、FashionIQ 等)虽具代表性,但均为学术规模,缺乏大规模真实网络检索或跨域迁移评估。基线主要与 embedding-based re-rankers 比较,未纳入近期基于生成式检索或端到端多模态大模型直接排序的方法,因此 SOTA 结论可能不全面。此外,论文未报告在无 LLM 可用环境下的表现,而许多生产系统可能无法集成外部 LLM API。这些因素限制了其作为通用重排序方案的普适性,后续需更广泛消融和对比。