FlavourBench:使用可执行烹饪地面真值对前沿语言模型进行排名
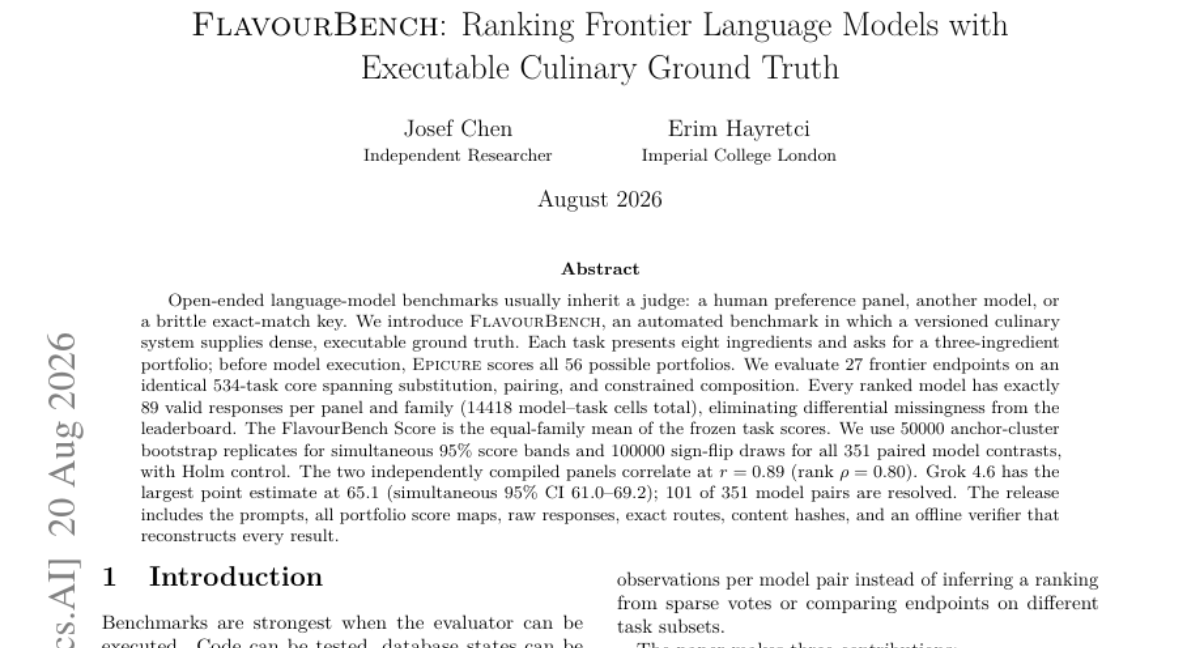
开放式语言模型基准通常继承一个评判者:人类偏好小组、另一个模型或脆弱的精确匹配键。我们引入 FlavourBench,一个自动化基准,其中版本化的烹饪系统 Epicure 提供密集、可执行的地面真值。每个任务给出八种食材,并要求三食材组合;在模型执行前,Epicure 对所有56种可能组合进行评分。 我们评估了27个前沿端点,在相同的534任务核心上,涵盖替换、配对和受限组合。每个排名模型在每组和家族中恰好有89个有效响应(共14,418个模型-任务单元),消除了排行榜上的差异缺失。FlavourBench Score 是冻结任务分数的等家族平均值。 实验使用50,000个锚聚类自助复制进行同时95%分数带,以及100,000次符号翻转抽样用于所有351个配对模型对比,并进行 Holm控制。两个独立编制的小组相关性为 r=0.89(秩 rho=0.80)。Grok 4.6 的点估计最大,为65.1(同时95% CI 61.0-69.2);101/351个模型对已解决。 发布内容包括提示、所有组合分数图、原始响应、精确路线、内容哈希,以及可离线验证所有结果的验证器。
论文精读
TL;DR FlavourBench 用可执行烹饪系统生成 dense 真实标签,对 27 个前沿模型做 534 项原料组合任务排名,并用 5 万次 bootstrap 与 10 万次符号翻转控制误差,得到统计上可解析的榜单。
问题
问题背景
开放型语言模型评测常见范式依赖外部判官:人类偏好面板、LLM-as-judge 或精确匹配。业界关注如何让评测可复现、可执行、不受模型自身影响。
现有方法局限
- LLM-as-judge 存在位置偏置、冗长偏好、自我偏好,且与待测系统同源,会污染评分;其内部决策无法审计。
- 人类偏好面板 成本高、不可扩展,难以覆盖大规模模型×任务矩阵。
- 精确匹配 只接受唯一答案,丢弃部分正确或相近决策,无法区分多解空间中的质量差异。
- 这些方法均缺乏冻结的密集 ground truth,无法计算严格置信区间或多重比较。
为什么难且重要
可执行 ground truth 需要领域专家预先定义规则,使所有可能候选动作都可被评分。FlavourBench 用版本化烹饪系统 Epicure 预计算全部 56 个三食材组合的得分,再让模型执行选择。这使评测具备:
- 完全可重现的验证器;
- 无差分缺失的完全核设计;
- 基于 bootstrap 的同时置信区间和 sign-flip 配对检验。
业界对可信榜单的需求在增加,尤其是有 27 个前沿端点、351 个成对比较时,统计严谨性决定结论是否可采信。
行业类比
如同自动驾驶仿真用预定义碰撞数据库自动评分每条规划轨迹,FlavourBench 用可执行味觉评分函数替代 LLM 评判员,为开放型决策建立可验证的自动化评测。
核心洞察
- FlavourBench 以可执行烹饪系统生成密集、预先计算的评分地图作为 ground truth,避免了开放式基准中模型 judge 或人类偏好带来的评估偏差。传统做法依赖另一个 LLM 或人工评审,成本高且引入评判者偏见。FlavourBench 将任务限定为从 8 种食材选 3 种组合,预先用 Epicure 对所有 56 种可能组合打分,使模型输出获得连续分数而非二元对错,保留部分正确决策的差异。该设计类似代码执行评估,但拓展到开放式决策领域,为复杂组合推理提供可复现、无评判者纠缠的 ground truth。
- FlavourBench 通过强制每个模型在每个任务家族中提供相同数量的有效响应,并使用 bootstrap 与多重比较校正,解决了排行榜中缺失数据偏差和不确定性误导。多数 leaderboard 只报告点估计,忽略置信区间和多重比较,导致微小差异被夸大。FlavourBench 用 50,000 次 anchor-cluster bootstrap 产生同时 95% 置信带,用 100,000 次 sign-flip 检验所有 351 个模型对,以 Holm 校正控制族错误率;每个模型恰好有 89 个有效响应,消除了因拒答或格式错误造成的差分缺失。这种统计严谨性使 101 对模型差异被明确解析,为从业者提供可信的选型依据。
- FlavourBench 发布完整复现材料(提示、评分图、原始响应、哈希和离线验证器),实现端到端可验证性。许多 benchmark 只发布部分数据或代码,难以独立验证。FlavourBench 提供所有 prompt、每个组合的分数映射、原始模型输出、精确执行路由和内容哈希,并附有离线验证器可重建每个结果。这种透明和可复现设计使社区能够审计评估流程、检测偏差,并扩展新任务。工程团队可将其集成到 CI 流程中,持续监控模型在烹饪推理这类封闭但有实际意义任务上的表现。
方法
输入
每个任务提供 8 种食材,要求模型生成一个包含 3 种食材的组合(portfolio)。任务分为三类决策族:substitution、pairing、constrained composition,分别对应替换、搭配和受限组合场景。
关键模块
- Epicure 评分系统:一个版本化的烹饪运行时,在模型执行前对所有 56 种可能的三食材组合计算稠密分数,而非二元对错。这些分数作为可执行 ground truth,保证评分客观且可复现。
- 任务分数冻结:所有任务及其 56 个组合分数在模型评估前固定,确保每个模型面对完全相同的评分标准,消除动态偏差。
- 等家族平均:FlavourBench Score 计算为全部 534 个任务分数的等家族均值,避免不同决策族间任务数量差异造成权重倾斜。
- 统计推断:使用 50,000 次 anchor-cluster bootstrap 构建同时 95% 置信区间,使用 100,000 次 sign-flip 检验模型两两对比差异,并用 Holm 方法控制多重比较错误率。
输出
每个模型在每个 panel 和每个家族中恰有 89 个有效响应,共 14,418 个模型-任务单元,消除差异缺失。最终输出包括排序后的 leaderboard、101 对已解析的模型对比结论、完整响应与分数映射、内容哈希及离线验证器,可离线重建全部结果。
与同类方法的差异:不同于依赖人类偏好、模型裁判或精确匹配的评测,FlavourBench 用可执行烹饪系统提供稠密、可验证且无裁判偏见的 ground truth,并把统计不确定性显式纳入排名。
实验
实验设计
FlavourBench 构建了一个 可执行烹饪 ground truth:每个任务给定 8 种食材,要求模型选择 3 种组合(共 56 种可能),预先使用 Epicure 系统对所有组合评分。核心测试集包含 534 个任务,覆盖 substitution、pairing、constrained composition 三类决策家族。评估 27 个前沿 API 端点,每个模型在每个家族固定获得 89 个有效响应(总 14,418 个模型-任务单元),消除缺失数据偏差。统计推断采用 50,000 次 anchor-cluster bootstrap 生成同时 95% 置信带,100,000 次 sign-flip 抽取 进行 351 对模型对比,并用 Holm 校正 控制多重比较。
关键发现
- 最高点估计来自 Grok 4.6,得分为 65.1(同时 95% CI 61.0–69.2)。
- 所有 351 对模型中,101 对 在统计上可区分,其余排名不确定性较大。
- 两个独立编译的任务面板之间 Pearson 相关 r=0.89,Spearman 秩相关 ρ=0.80,表明排序具有较强的可复制性。
- 聚合分数掩盖了不同模型在 substitution、pairing、constrained composition 上的差异化表现(烹饪画像不同)。
与同类基准对比
传统开放式基准依赖人类偏好、模型评判或脆弱的精确匹配,评估器与被测系统纠缠或丢失合理答案间的细粒度差异。FlavourBench 将评估器替换为 版本化、可执行的烹饪系统,提供稠密、预先计算的组合评分,避免了 judge 偏见和评估时的非确定性。同时,严格的统计框架(bootstrap + sign-flip + Holm)使排名不确定性显式可见,优于仅给出单一点估计的排行榜。所有 prompts、评分映射、原始响应与离线验证器均开源,保证结果可重建。
行业影响
落地场景
FlavourBench 的核心是可执行 ground truth 评估范式,可迁移到任何具有确定性评分函数的开放式决策场景。典型产品包括:
- 电商搭配推荐:给定商品池,模型生成组合(如服饰搭配、食品套装),系统依据利润率、库存、转化率等指标预先计算所有组合得分,直接评估模型输出质量。
- 内容平台素材优化:广告标题、封面图组合生成,通过历史 CTR 预估函数打分,替代人工评审或 LLM-as-judge。
- 教育 / 企业服务:自动评分学生答案、生成候选方案并量化优劣。
商业价值
- 降本:消除人工标注或模型评审成本,一次性构建评分函数即可反复评估任意模型,特别适合多模型选型与快速迭代。
- 提升模型部署质量:在离线基准上排名可信(论文提供 95% 同时置信区间与 Holm 校正),可直接筛选出统计显著更优的模型,降低上线风险。
- 体验优化:可执行评分确保模型输出与业务 KPI 对齐,且 dense ground truth 比 exact match 更能捕捉部分正确决策,指导 fine-tuning。
与现有工作流集成
- 评估层替换:可将 FlavourBench 的 offline verifier 与 score maps 集成到 MLOps 流水线中,作为回归测试门禁,每次模型更新自动跑分并对比基线。
- 训练信号来源:任务得分可作为 reward model 的弱监督信号,或直接用于 DPO 正负样本构建。
- 统计报告标准化:bootstrap + 多重比较校正的流程可复制到内部基准,提升实验结论可信度。
具体 use case:某电商平台使用该框架评估 10 个 LLM 的“商品组合推荐”能力,构建一个可计算函数(如组合预期毛利),对每个任务预计算所有可能组合的得分,模型输出后直接查表评分;同时按论文方法生成 95% 置信区间,选择显著优于基线的模型部署,预计减少 50% 以上的人工评估工时。
局限
- **领域局限性强**:FlavourBench 聚焦烹饪组合任务,评测的是模型在特定知识领域内的决策能力,而非通用推理。尽管作者强调“可执行 ground truth”,但烹饪问题高度依赖文化背景与食材知识,模型在此类任务上的表现可能无法迁移到编程、数学、科学推理等更核心的 AI 能力评估。对希望了解模型整体实力的从业者而言,单一领域排名可能产生误导,需配合多领域综合基准使用。
- **评分系统本身存在偏差风险**:Epicure 系统的评分规则虽可执行,但规则由人类设计,量化“风味搭配”本身具有主观性。不同饮食文化对食材组合的接受度差异大,当前规则可能反映特定偏好,无法覆盖全球口味多样性。此外,规则静态,若未来烹饪科学更新,系统需重新版本化,模型得分可比性会受影响。
- **任务难度与区分度有限**:每个任务仅 8 种食材选 3 种,搜索空间为 C(8,3)=56 种组合,相对较小。模型可能通过记忆常见搭配模式或简单启发式获得高分,无法有效区分高水平推理能力。534 个任务虽覆盖三类子任务,但整体规模仍偏小,统计上只能识别较大差异(仅 101/351 对模型显著),对细微差距的检测力不足。