PolicyGuide: 从守护单一操作到为策略合规 LLM 智能体引导整个工作流
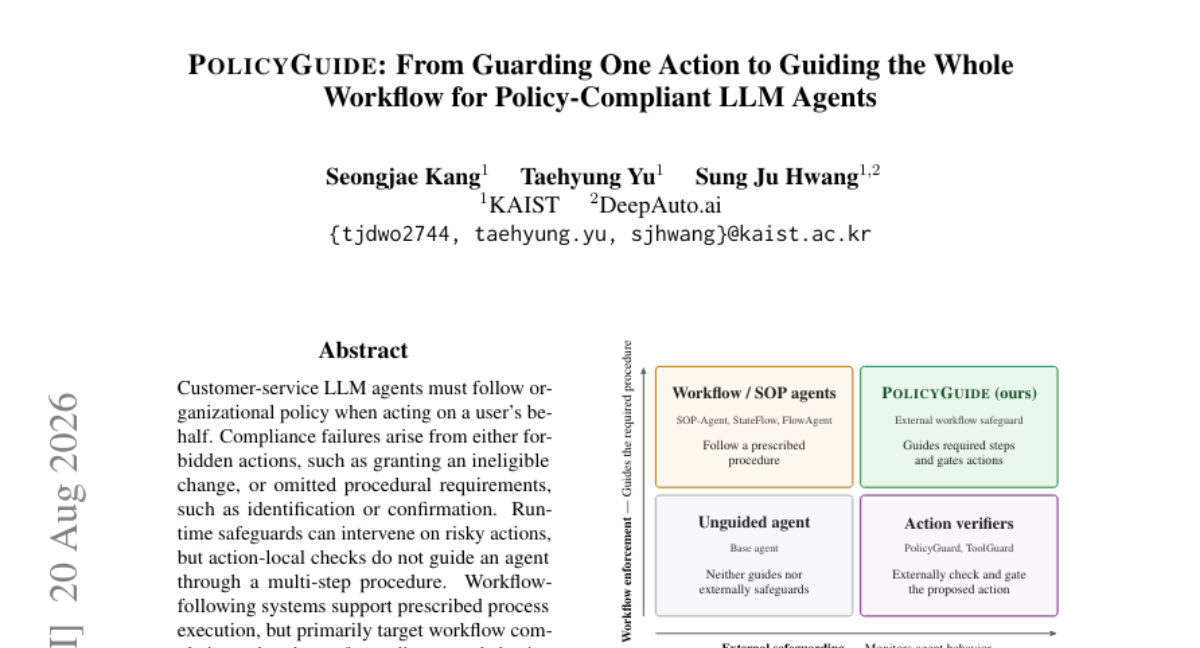
客服场景中的 LLM 智能体在代表用户执行操作时,必须遵循组织政策。合规失败源于两类问题:禁止操作(如给予不合规的变更)或遗漏程序要求(如身份验证、确认)。运行时防护可对风险操作进行干预,但基于单步的检查无法引导智能体完成多步流程;而现有的工作流遵循系统主要面向流程完成,而非守护智能体的安全行为。 为此,PolicyGuide 将每条领域策略编译为工作流图,并在用户回合边界调用主动验证器。验证器基于持久化的图状态,协调未决请求,并沿合规路径返回逐步补救建议。在 τ^2-bench 的航空、零售和电信三个领域,配合 GPT-5.4 智能体与验证器,PolicyGuide 将平均 Pass^4 从 0.42 提升到 0.62,其中工作流结构化程度最高的电信领域提升最大(0.19 至 0.61)。相同工作流可迁移至 Claude Sonnet 4.6 与 Gemini 2.5 Pro 智能体。补充评估显示,该方案在对抗性用户下取得最低的攻击成功率,并在作者设计的工作流级验证中展现最强的程序合规性。
论文精读
TL;DR PolicyGuide 将政策编译为工作流图,在用户轮次边界调用验证器,按图状态返回补救步骤,使 GPT-5.4 在 τ²-bench 平均 Pass⁴ 从 0.42 升至 0.62,telecom 域提升 3 倍。
问题
问题背景
基于 LLM 的客服 agent 正被用于代表用户执行订单变更、退款、账户管理等操作。这类场景要求 agent 严格遵守组织政策:既不能执行禁止动作(例如给不符合条件的用户退款),也不能省略程序性步骤(例如身份验证、用户确认)。
现有方法局限
- 运行时动作守护(runtime safeguard)在风险动作前做局部校验,只判断单个动作是否违规,无法引导 agent 走完整个多步流程;
- 工作流执行系统 关注
workflow completion,主要提供步骤序列,但缺少对策略违规的主动检测和干预,不能保证行为级合规。
两类方法之间存在裂缝:动作级校验解决不了流程遗漏,流程系统解决不了策略越界。
为什么这个问题难 / 重要
政策合规本质是全局约束:某个动作是否合规,常取决于之前的验证步骤是否完成、用户请求是否冲突。这要求系统维护跨轮次状态,并在每个用户回合边界主动检查开放请求,给出步骤级补救路径。技术上,把非结构化政策编译成可执行的 workflow graph 并保证忠实性,以及在不显著增加延迟和成本的前提下实现主动 verifier,都具挑战。业界对客服 agent 的合规风险高度敏感:一次错误授权或数据泄露,影响远大于单次任务失败。
行业类比
这类似于自动驾驶安全系统不能只做“防碰撞急刹”,而需要端到端路线合规导航:持续判断车辆是否处于合法、安全的行驶路径上,并在偏离时引导回正确路线。
核心洞察
- PolicyGuide 的核心创新是将策略合规从动作级审核推进到工作流级引导,通过在用户轮次边界主动验证整个流程状态,覆盖多步骤程序性要求。与现有运行时安全措施仅做 action-local 检查、无法发现程序性遗漏相比,PolicyGuide 将策略编译为图结构并利用持久化状态进行逐步补救,恰好填补了工作流遵循系统只关注完成度、不保证行为合规的空白。
- PolicyGuide 的策略工作流表示与代理模型解耦,实验证明相同工作流图在 GPT-5.4、Claude Sonnet 4.6、Gemini 2.5 Pro 上均提升 Pass^4,且对抗鲁棒性优于基线,说明策略合规可作为独立于基础模型能力的可复用层。这为生产环境构建“策略即代码”提供了工程范式:将组织规则外置为结构化、可验证的流程,而非仅依赖代理内部提示或事后检查。
方法
方法概览
PolicyGuide 将每条领域政策编译为一个 workflow graph,并在对话的每个 user-turn 边界调用主动校验器,把政策执行从“守住单一动作”扩展为“引导完整工作流”。
输入:领域政策文本 + 当前对话状态(历史轮次、已执行动作、待处理请求)。
关键模块:
- 离线工作流生成:用 LLM 将政策文本解析为图结构,节点代表必要合规步骤(如身份验证、资格检查、用户确认),边代表满足前提条件后的状态转移。
- 持久化图状态:在线对话中维护当前所处节点、已完成/未完成的程序性要求,以及尚未关闭的用户请求(
open requests),跨轮次保持一致性。 - 主动校验器:每个 user-turn 边界触发,读取图状态与
open requests,执行 reconcile 和 traverse:比对当前节点与下一步必须满足的前置条件,判断 agent 是否遗漏程序性要求或将执行 forbidden action。 - 补救指令生成:若发现偏差,返回 step-specific remediation,即沿着 policy-compliant path 的具体下一步操作(例如“补充确认住址”“拒绝修改但提供替代方案”),作为附加指令注入 agent 上下文,不强制改写底层 agent 的决策逻辑,而是引导其回到合规轨迹。
输出:每轮对话的合规状态 + 针对当前节点的补救/推进指令。
与仅做动作级拦截的 runtime safeguard 或只关心流程完成的 workflow-following 系统不同,PolicyGuide 在 user-turn 边界主动协调整条合规路径,同时覆盖 forbidden actions 和 omitted procedural requirements。
实验
实验设计
在 τ²-bench 的 airline、retail、telecom 三个领域上评估 PolicyGuide。主实验使用 GPT-5.4 同时作为 agent 与 verifier,对比基线为无 PolicyGuide 的同一 agent。主要指标是 Pass^4,即连续 4 轮交互全部符合策略的比例。此外还测试了:
- 跨模型泛化:将同一 workflow 转移到 Claude Sonnet 4.6 和 Gemini 2.5 Pro 上运行
- 对抗鲁棒性:在对抗性用户交互下评估攻击成功率
- 程序合规性:通过作者设计的 workflow-level 验证检查行为是否符合流程要求
关键发现
- 引入 PolicyGuide 后,三个领域的 mean Pass^4 从 0.42 提升至 0.62
- 提升最大的是 telecom(0.19 → 0.61),该领域流程结构最明显
- PolicyGuide 的 workflow 可以无缝迁移到不同模型家族,无需重新训练
- 在对抗性用户场景下,PolicyGuide 获得最低的攻击成功率;在程序合规性验证中表现最强
与基线对比解读
PolicyGuide 的核心贡献在于将策略编译为 workflow graph,并在 user-turn 边界调用 proactive verifier,基于持久化图状态给出 step-specific 的修复路径。这同时克服了两种既有方法的局限:
- action-local safeguard 只检查单个动作,无法引导多步骤流程;
- workflow-following system 侧重流程完成度,但缺少对策略违规的主动防护。
PolicyGuide 在流程结构越强的领域(如 telecom)收益越大,说明其价值正体现在对复杂 SOP 的策略对齐上。
行业影响
落地场景
PolicyGuide 适用于任何需遵循 组织政策 的多步骤代理工作流,不限于客服。典型场景包括:
- 金融交易代理:处理账户变更、贷款申请时,必须执行身份验证、资格检查、用户确认等步骤,PolicyGuide 可防止跳步或违规授予。
- 医疗预约与保险理赔代理:核对患者身份、保险覆盖、授权流程,减少错误批准风险。
- 企业服务工单系统:IT 支持或 HR 流程中,代理需按 SOP 执行,PolicyGuide 可引导每一步合规并提示遗漏。
商业价值
核心价值在于 减少合规失败与人工干预成本。论文结果显示,在 τ²-bench 三个域上,Pass⁴ 从 0.42 升至 0.62,其中 telecom(最结构化的域)增益最大。这意味着:
- 降低风险:减少因违规操作(如给不合格用户改套餐)导致的损失与审计成本。
- 提升自动化覆盖率:代理可更可靠地处理长尾或复杂请求,减少转人工比例。
- 客户体验改善:避免因遗漏确认步骤导致的重复交互,缩短用户等待时间。
与现有产品/工作流的接口
PolicyGuide 可作为轻量级 运行时中间件 集成到现有 agent 栈:
- 状态图框架兼容:与 LangGraph、CrewAI 等状态机驱动框架天然适配,编译的 workflow graph 可作为外部知识注入。
- Guardrail 层:类似 NeMo Guardrails 或独立 verifier,在 user-turn 边界触发,不侵入主代理逻辑。
- 持久化状态:利用数据库保存 graph state,便于审计、回放与调试。
如需进一步代码级集成,参见 PolicyGuide GitHub。
局限
- PolicyGuide 的核心假设是能将领域政策可靠地编译为工作流图,但论文中工作流生成过程可能依赖人工设计或 LLM 辅助,缺乏自动化验证图与政策完全一致的机制。在政策频繁更新或存在模糊条款时,工作流的维护成本较高,且错误或遗漏的节点会直接导致引导偏差。与纯动作级运行时保障相比,PolicyGuide 需要额外的前期建模投入,限制了其在新领域快速部署的可扩展性。
- 评估集中在 τ²-bench 的航空、零售、电信三个结构化客服领域,其中电信因工作流结构化程度最高而收益最大(0.19→0.61),但该结论可能无法泛化到更开放、非流程化的政策场景,例如金融咨询或医疗建议,这些场景缺少明确的标准操作流程可编译。此外,对抗用户测试虽显示最低攻击成功率,但基准中的用户模拟可能仍未覆盖所有现实攻击策略,实际鲁棒性有待更大规模验证。
- PolicyGuide 在用户轮次边界触发验证器,提供的是回合级补救而非步骤内实时拦截,因此无法阻止 agent 在同一回合内连续执行多个违规子步骤。验证器输出的补救建议本质上是提示性而非强制性的,agent 可能忽略或误解,概率性合规仍然存在风险。每次用户轮次都调用 LLM 验证器并维护图状态,增加了推理延迟和 token 成本,在与用户实时交互的低时延客服系统中可能难以接受。