训练用于单步逆合成的化学合理性感知大语言模型
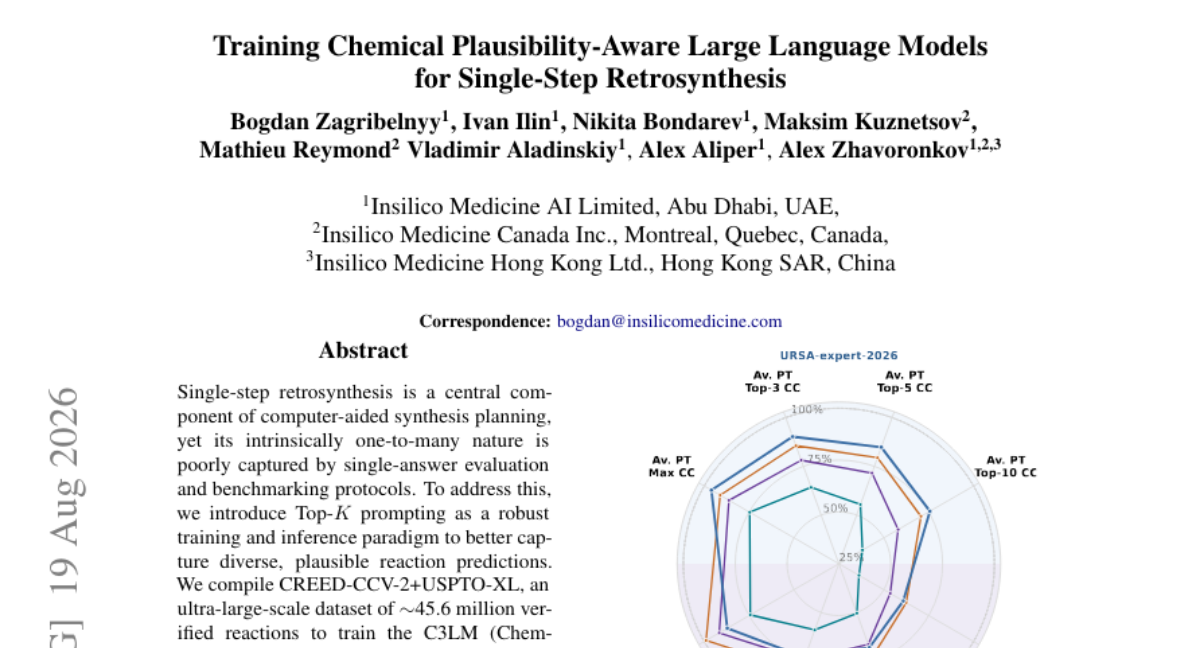
单步逆合成是计算机辅助合成规划的核心组成部分,但其内在的一对多特性难以被单答案评估和基准测试协议充分捕获。为此,我们引入Top-K 提示 作为一种稳健的训练和推理范式,以更好地预测多样且合理的反应。 我们构建了CREED-CCV-2+USPTO-XL,一个包含约4560万条已验证反应的超大规模数据集,用于训练C3LM(化学约束一致性语言模型)。通过结合基于ChemCensor 的奖励和面向新颖性的奖励进行微调,我们的模型在OOD URSA-expert-2026 基准上取得了最先进的性能。 进一步的反应唯一性分析表明,大语言模型与传统模型探索了互补的反应空间,这启发我们构建基于集成的逆合成系统。总体而言,我们的工作确立了Top-K 与合理性感知训练 作为未来基于大语言模型的稳健合成规划的实用新方向。
论文精读
TL;DR 论文提出 Top-K 提示与化学合理性感知训练,用 45.6M 反应数据集训练 C3LM,在单步逆合成中生成多样且合理的候选,并在 OOD 基准上达到 SOTA。
问题
问题背景
单步逆合成是计算机辅助合成规划的核心任务,给定产物分子预测可能的反应物集合。当前领域关注如何利用 LLM 提升预测的准确性与多样性。
现有方法局限
传统逆合成模型(基于模板、图神经网络或序列模型)通常输出单一答案,评估协议也以 top-1 准确率为主,忽略了一对多本质。这导致模型倾向于记忆高频反应,对稀有或新颖反应覆盖不足,泛化能力受限。基于 LLM 的方法虽能生成多个候选,但训练信号单一,缺乏化学可行性约束,容易产生不合理或重复的预测;同时现有数据规模有限,未能充分利用大规模验证反应库。
为什么这个问题难/重要
- 组合爆炸:一个产物分子可能对应数十条可行合成路线,模型需在巨大化学空间中搜索。
- 可行性判断成本高:化学可行性依赖专家知识与实验验证,数据标注昂贵且噪声多。
- 工业需求迫切:在药物发现中,合成可及性直接决定化合物能否被实际制备,因此模型不仅要给出答案,还需提供多样化的可行候选供化学家权衡选择。现有基准与真实需求脱节,业界亟需新的训练与评估范式。
行业类比
类似代码生成中从单一补全到提供多个候选方案供开发者选择,逆合成也需要从单一最优转向多样化候选生成,以适应实际决策场景。
核心洞察
- Top-K prompting 将单步逆合成训练与推理从单答案预测转变为多答案生成与化学合理性评分,直接建模反应的一对多本质。这一范式不同于主流单答案 SOTA 模型(如 MHNreact)仅优化 top-1 精确匹配,而是显式采样 K 个候选并用 ChemCensor 奖励过滤,从而在 OOD URSA-expert-2026 上避免因参考反应缺失而低估模型性能。工程启示:评估协议应从 top-1 完全匹配转向 top-k 化学可行性判断,否则无法公平比较生成式模型。
- 反应空间互补性分析揭示 LLM 与传统模型(如 MHNreact)并非替代关系,而是探索不同的化学推理路径。论文定量展示两者生成结果的低重叠率,并据此提出 ensemble-based retrosynthesis 系统,利用多样性提升整体 top-k 命中率。这一发现打破了“单一模型达到 SOTA 即可”的惯性思维,为实际合成规划工具设计提供指导:将基于模板/图的方法与生成式 LLM 并行运行并聚合输出,比继续压榨单个模型更有效;同时需要新的多样性度量来指导集成决策。
方法
输入为单步逆合成任务中的目标产物分子(SMILES 表示)。方法的核心流程如下:
关键模块
- Top-K 提示策略:训练与推理阶段均要求模型一次生成 K 个候选反应物集合,而非单一答案。这一设计显式应对逆合成的一对多特性,避免传统单答案评估低估模型能力。
- C3LM 模型与两阶段训练:
- 监督微调(SFT)在 CREED-CCV-2+USPTO-XL(约 45.6M 核实反应)上进行,学习产物到多种反应物的映射。
- 强化学习微调(RLFT)引入两类奖励:ChemCensor 生成的化学合理性评分(过滤不合理反应),以及新颖性奖励(鼓励探索训练集中不常见的反应路径)。
- 输出:对每个输入产物给出 Top-K 个按合理性排序的反应物集合,每个集合包含完整反应物(可能含试剂、催化剂等)。
与同类方法差异:传统序列到序列或图神经网络通常只输出单一预测,并以 top-1 准确率为优化目标;本方法通过 Top-K 提示 + plausibility-aware 奖励 直接建模逆合成的一对多分布,并利用大规模验证数据与 RL 优化化学合理性,而非仅提高检索式命中率。
实验
实验设计
C3LM 在超大规模数据集 CREED-CCV-2+USPTO-XL(~45.6M 验证反应)上进行两阶段训练:先 监督微调 (SFT),再结合 ChemCensor-based 与 novelty-oriented 奖励做 强化学习微调 (RLFT)。评估采用 Top-K prompting 协议,在 OOD 基准 URSA-expert-2026 上测试,并与传统模型及 LLM baselines 对比。
关键发现
- Top-K prompting 能有效捕获逆合成中一对多的多样 plausible 产物,突破单答案评估的局限。
- C3LM 在 URSA-expert-2026 上取得 SOTA 表现,验证了 plausibility-aware 训练的有效性。
- 反应唯一性分析显示 LLM 与传统模型探索互补的反应空间,为集成系统提供依据。
与基线对比解读
传统单答案评估协议会系统性地低估模型真实能力,尤其忽略生成多条合理路线的场景。Top-K 评估更贴近实际合成规划需求,应成为未来基准的标准配置。LLM 擅长利用大规模语料中的模式泛化,而传统模型在特定模板或高频反应上更精确;集成两者可显著提升覆盖率与鲁棒性。
行业影响
落地场景
该论文方法可直接嵌入计算机辅助合成规划(CASP)产品,服务于制药、农化、新材料企业的分子设计流程。典型场景:药物化学家设计新化合物后,需要快速判断合成可行性,单步逆合成预测提供起始原料建议。Top-K prompting 输出多条候选路线,比单一答案更贴合真实化学探索需求。
商业价值
- 降本:减少湿实验试错,每条失败合成路线可节省数千至数万美元原料与人力成本。
- 加速:从小时级人工查询到秒级生成候选路线,压缩 hit-to-lead 周期。
- 增收:CRO/CDMO 公司可提供 AI 辅助路线设计增值服务,或按 API 调用计费。
与现有产品/工作流的接口
- 模型输出为 SMILES 字符串列表,便于对接现有反应数据库、逆合成树搜索(MCTS)或 ELN 系统。
- 可作为微服务集成到分子设计平台(如 Schrödinger LiveDesign、Dotmatics),对生成分子进行实时可合成性过滤。
具体 use case
- 制药企业 AI 辅助药物设计:生成模型提出新分子后,调用该模型预测多条逆合成路线,排除合成难候选,优先湿实验高可行性分子。
- CRO/CDMO 客户提案:服务商在询单阶段快速生成多种合成方案与预估成本,提高响应速度和中标率。
局限
- 数据集 CREED-CCV-2+USPTO-XL 规模庞大但存在潜在偏置:其反应主要源自专利文献,可能过度代表工业常见反应类型,且“已验证反应”的过滤标准可能仍包含噪声或非典型条件,导致模型学到的分布不完全符合真实合成化学空间。此外,单一来源数据可能限制模型对罕见反应或全新反应类型的泛化能力。
- Top-K 评估协议虽更符合一对多本质,但缺乏统一标准:K 值的选择、候选排序、以及如何平衡多样性与精确匹配率仍需进一步探索。文中使用的 ChemCensor 和 novelty 奖励函数虽有效,但可能过度偏向新颖性而牺牲对经典可靠路线的预测,且评估指标(如 plausibility-based Top-K)的计算成本较高,难以在大型基准上快速迭代。
- 模型推理效率与集成系统复杂度:C3LM 作为 LLM 在单步逆合成推理时可能比传统图神经网络或模板方法慢,限制在高通量筛选场景中的应用。此外,论文虽然提出 LLM 与传统模型互补,但集成系统的具体实现、加权策略和计算开销未深入讨论,可能阻碍实际部署。