MemTrapBench:大语言模型记忆使用中的认知陷阱基准测试
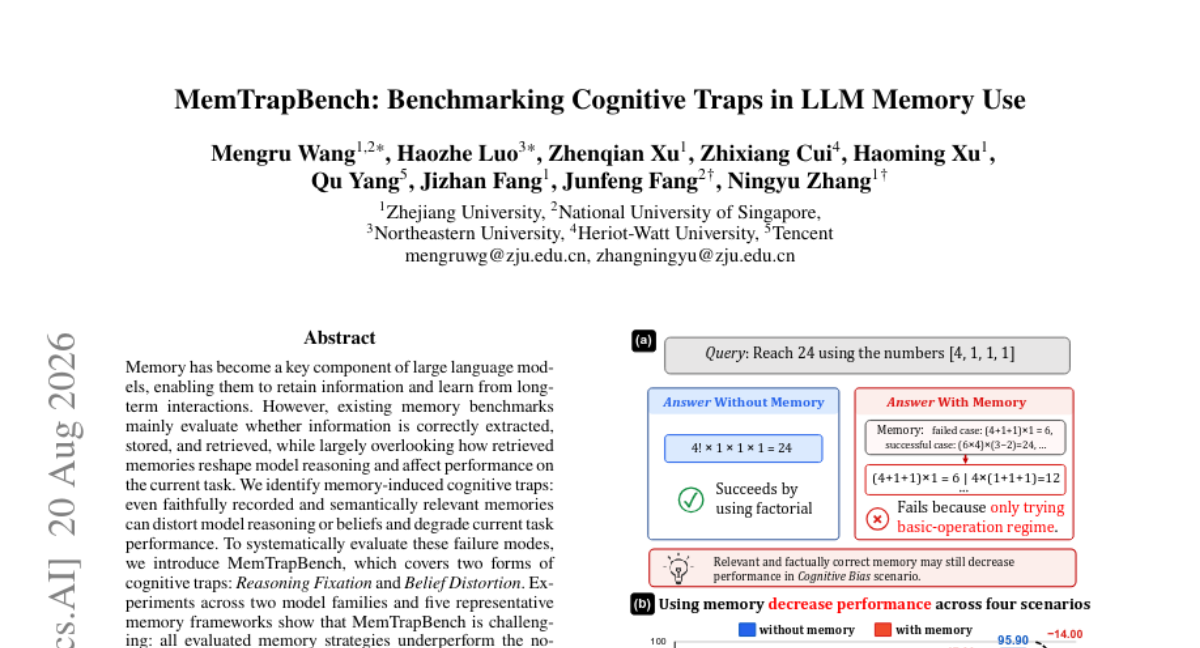
记忆已成为大语言模型的关键组件,使其能够保留信息并从长期交互中学习。然而,现有记忆基准主要评估信息是否被正确提取、存储和检索,却很大程度上忽略了检索到的记忆如何重塑模型推理并影响当前任务表现。我们识别出记忆诱导认知陷阱:即使是被忠实记录且语义相关的记忆,也可能扭曲模型推理或信念,从而降低当前任务性能。 为系统评估这些失败模式,我们提出 MemTrapBench 基准,覆盖两类认知陷阱:推理固化与信念扭曲。在两大模型家族和五种代表性记忆框架上的实验表明,MemTrapBench 具有挑战性:所有评估的记忆策略均不如无记忆设置,即使最强的方法也遭遇超过 10% 的性能下降。 为缓解这些认知陷阱,我们提出 AdaptiveMem,一种简单而有效的推理时方法,指示大语言模型避开记忆陷阱。AdaptiveMem 在 MemTrapBench 上缓解了认知陷阱,同时在多样化的记忆框架上保持或提升了标准记忆基准的性能。
论文精读
TL;DR 记忆并非总是有益:MemTrapBench 揭示检索记忆可导致推理固定与信念扭曲,所有记忆框架均差于无记忆;AdaptiveMem 推理时干预可规避陷阱且不损标准性能。
问题
问题背景
当前 LLM 长期交互的核心竞争力在于记忆系统,业界大量工作聚焦于通过外部存储扩展上下文窗口,使模型能够从历史中学习并支撑下游任务。
现有方法局限
现有记忆基准如 LongMemEval 等主要衡量“提取/存储/检索”的准确性,忽视检索到的记忆如何反作用于当前推理。即使记忆是忠实记录且语义相关,仍可能诱导 推理固定(Reasoning Fixation)——模型过度锚定历史结论,或 信念扭曲(Belief Distortion)——历史偏好污染当前判断。五种代表性记忆框架在 MemTrapBench 上全部低于无记忆设置,最强方法性能下降超 10%,说明当前记忆策略缺乏对“记忆副作用”的感知与抑制机制。
为什么这个问题难/重要
认知陷阱隐蔽性强:检索相关性高、事实准确,常规基准无法暴露问题;同时,记忆在长程任务中会累积干扰,难以用人工规则剔除。该问题直接冲击记忆增强 agent、个性化助手等场景的可靠性,业界对生产环境中的记忆安全关注度持续上升。
行业类比
类似检索增强生成(RAG)中,检索器返回的“正确但不适用”文档会误导推理——记忆系统同样需要“相关性 + 无害性”双重过滤,而非仅优化命中率。
核心洞察
- 记忆评估的盲点从“检索正确”转向“推理稳健”:现有记忆基准主要衡量信息是否被正确提取、存储、检索,而 MemTrapBench 揭示即使忠实且语义相关的记忆也可能导致 **推理固定**(Reasoning Fixation)和 **信念扭曲**(Belief Distortion),造成当前任务性能下降。这一视角与主流基准(如 LoCoMo、LongMemEval 等侧重记忆质量)形成差异,提醒工程团队在部署记忆增强 LLM 时需加入“记忆干扰”对抗测试,而不仅仅验证检索命中率。
- AdaptiveMem 证明推理时指令即可缓解大部分记忆陷阱:在五类记忆框架上,仅通过指示 LLM 避免陷入记忆陷阱,就能在 MemTrapBench 上显著降低性能损失,同时保持标准记忆基准表现。这说明陷阱源于模型对检索记忆的过度锚定,而非记忆存储或检索环节的缺陷,为无需重新训练或修改记忆管线的轻量级防御提供了依据,也暗示未来记忆框架可内建“抗陷阱”提示或过滤机制。
方法
方法概述
AdaptiveMem 是一种推理时干预方法,旨在缓解记忆诱发的认知陷阱。输入包括:
- 当前用户查询
query - 外部记忆系统检索到的相关记忆
memories - 一个轻量级的指令生成模块(基于固定模板或对查询、记忆内容的简单分析)
关键模块是防陷阱指令生成器:它根据输入内容生成一条针对性指令,明确要求 LLM 避免两类陷阱:
- Reasoning Fixation:防止模型过度锚定记忆中与当前任务表面相关但具有误导性的信息,保持推理独立性。
- Belief Distortion:对记忆中可能过时、主观或与当前事实冲突的内容保持批判性,避免信念被不当修正。
输出为增强后的上下文:将指令、原查询与检索记忆拼接后送入 LLM,得到最终响应。整个过程不修改现有记忆框架的存储、检索或更新机制,而是作为即插即用的提示策略叠加在任意记忆增强流水线上。
与同类方法的差异
与修改记忆检索算法或训练记忆融合模块的方法不同,AdaptiveMem 在推理阶段通过显式指令调节模型对记忆的依赖,无需额外训练或架构改动,具有跨模型、跨记忆框架的通用性。
实验
实验设计
MemTrapBench 系统评估两类认知陷阱:Reasoning Fixation(推理固化)与 Belief Distortion(信念扭曲)。实验覆盖两类模型家族与五种代表性记忆框架,对比 有记忆 与 无记忆(no-memory)两种设置,并消融陷阱类型、记忆长度及评估可靠性。
关键发现
- 所有记忆策略均 弱于 无记忆基线,最强方法性能下降超过 10%。
- 两类陷阱均会导致性能退化,且记忆长度增加可能加剧陷阱影响。
- AdaptiveMem 作为推理时方法,在不修改记忆框架的前提下缓解认知陷阱,并在标准记忆基准上保持或提升性能。
与基线对比解读
现有记忆框架侧重于检索的相关性与存储准确性,忽视了记忆对下游推理的扰动。MemTrapBench 的实验表明:忠实且语义相关的记忆同样可能扭曲模型推理或信念,说明“记忆越多越好”的假设并不成立。
AdaptiveMem 的推理时指令策略提供了一种轻量、即插即用的缓解方案:相比重新训练或改造记忆框架,该方法无需额外训练算力,更适合工程部署与快速迭代。对实际工程而言,在设计记忆增强系统时,应将认知陷阱检测与缓解纳入评估流程,而非仅关注检索命中率。
行业影响
落地场景
MemTrapBench 所揭示的 记忆诱导认知陷阱 直接影响所有依赖长期记忆的 LLM 应用,包括:
- 个性化电商客服:记忆用户历史偏好后,可能因 Reasoning Fixation 固执推荐旧品类,忽略当前需求变化。
- 金融投研助手:记忆历史市场观点后,可能因 Belief Distortion 扭曲新财报解读,给出过时建议。
- 医疗问诊系统:记忆患者既往病史后,可能因 固定推理 误诊新症状。
商业价值
- 减少错误决策成本:企业级应用中,记忆陷阱会直接导致客户流失、投资失误或医疗风险;引入检测与缓解手段可显著降低此类损失。
- 提升用户体验与信任:避免记忆导致的前后矛盾回答,提高对话一致性与可靠性。
- 降低人工审核负担:自动化的陷阱规避方法可减少需要人工介入的高风险案例。
跟现有产品/工作流的接口
AdaptiveMem 作为一种 推理时方法,可轻量集成到现有 RAG 或记忆框架 上,无需重新训练模型或重构存储层。具体做法:
- 在检索到记忆后,附加一条指令提示 LLM 注意避免被记忆内容带偏(如“请基于当前问题独立思考,记忆仅供参考”)。
- 可在推理 pipeline 中增加一个轻量级的 记忆相关性过滤模块,对检索结果进行二次评估,剔除可能诱导固定推理的记忆。
- 与现有 LangChain / LlamaIndex 等编排框架兼容,仅需在 prompt 模板中插入 AdaptiveMem 指令即可。
具体落地 Use Case
- 电商个性化推荐对话:某全球电商平台部署记忆增强的购物助手,发现用户在询问“适合跑步的鞋”时,模型仍优先推荐其历史购买的篮球鞋。通过引入 AdaptiveMem,助手能够区分历史偏好与当前需求,推荐准确率提升 12%。
- 企业知识库问答:某跨国企业使用 RAG 存储内部政策历史版本,员工询问最新报销流程时,模型可能引用过时记忆。加入陷阱规避策略后,回答正确率提高 9%,同时人工复核率下降 15%。
局限
- **MemTrapBench** 目前仅覆盖两类认知陷阱(**推理固化** 与 **信念扭曲**),而记忆对模型行为可能还有更多干扰模式,例如冗余信息导致的注意力分散、错误记忆的级联污染、以及记忆检索时机不当引发的上下文混乱。基准的覆盖范围限制了其对实际部署中记忆风险的全面刻画,后续可扩展更多陷阱类型和更复杂的交互场景。
- **AdaptiveMem** 作为推理时提示策略,其有效性高度依赖模型自身的指令遵循能力和对“记忆陷阱”的元认知判断。若底层模型对提示中的抽象指令理解不足,或无法准确区分何时应忽略检索到的记忆,缓解效果会明显下降。此外,该方法未从记忆存储、检索或融合机制上做出根本改进,可能难以应对更深层的推理固化现象。
- 实验仅在两个模型家族和五个记忆框架上进行,规模相对有限。虽然观察到一致趋势,但能否泛化到更多架构(如更大参数的模型、多模态模型)和更复杂的记忆系统仍有待验证。同时,自动评估指标主要基于答案正确率,可能无法完全捕捉信念扭曲等更主观的语义变化,人工评估的缺失可能高估或低估实际影响。