H2R-Bench: 世界模型中人类到机器人操控视频生成的基准测试
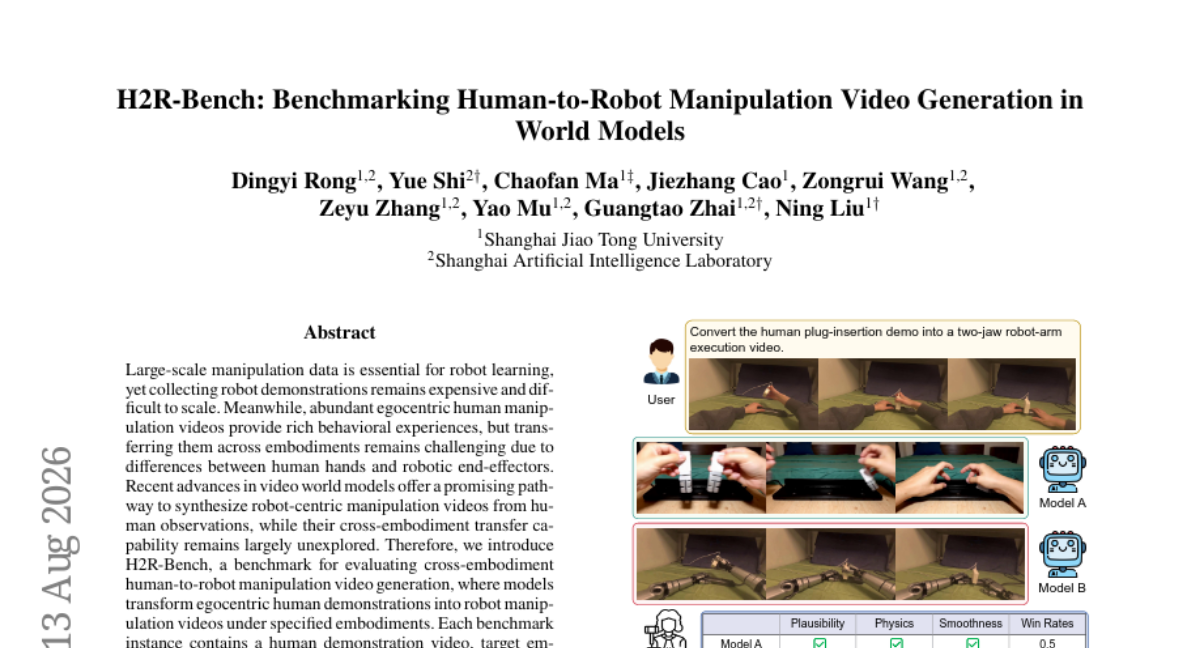
大规模操控数据对机器人学习至关重要,但采集机器人演示数据成本高昂且难以规模化。与此同时,丰富的以自我为中心的人类操控视频提供了大量行为经验,但由于人类手部与机器人末端执行器之间的差异,跨本体迁移仍然充满挑战。近期视频世界模型的进展为从人类观察中合成以机器人视角为中心的操控视频提供了可行路径,但其跨本体迁移能力仍未得到充分探索。 为此,我们提出 H2R-Bench——一个用于评估跨本体人类到机器人操控视频生成的基准。该基准要求模型在指定本体约束下,将人类演示视频转化为机器人操控视频。每个基准实例包含一段人类演示视频、目标本体约束,以及涵盖任务目标、动作事件、功能性接触和物体响应的源接地标注。H2R-Bench 通过五个维度评估生成视频:目标状态完成度、动作事件完成度、功能性接触迁移、本体正确性和通用视频质量。 我们针对六个操控类别和两种机器人本体,对十一个最新视频生成模型进行了基准测试。评估结果显示,当前视频世界模型在人类到机器人操控迁移方面仍存在明显局限:即使是领先模型,也常在本体一致性、功能性交互和任务执行上失败。H2R-Bench 提供了一个系统性的诊断框架,用于评测视频世界模型能否弥合人类与机器人之间的本体鸿沟,并将人类操控观察转化为机器人中心的训练资源。
论文精读
TL;DR H2R-Bench 是首个系统评估人-机器人操作视频生成的跨实体迁移基准,用五个维度揭示现有视频世界模型在实体一致性、功能交互和任务执行上的关键短板。
问题
问题背景
机器人操作学习依赖大规模操控数据,但机器人演示采集昂贵且难以扩展;海量人类自我中心视频蕴含丰富操作经验,却因人类手与机器人末端执行器的形态差异无法直接使用。
现有方法局限
近期视频世界模型可以合成机器人视角视频,但其跨具身迁移能力缺乏系统评估。此前基准要么只关注通用视频质量(如 VBench),要么只评估单一机器人具身下的生成,未覆盖从人类视频到指定机器人形态的转换约束。具体表现为:模型难以保持末端执行器形态正确性(例如将人类手直接描绘为机器人夹爪但关节数错误),无法迁移功能性接触(如抓取点上出现穿透或错位),且动作事件完成度低(人类演示中的关键操作步骤在生成视频中缺失)。现有评估指标无法定位失败发生在语义理解、具身映射还是时序生成环节。
为什么这个问题难/重要
难点在于需要同时理解人类操作语义、建立跨形态映射(手指自由度→夹爪/灵巧手)、保持物理交互合理性与时序一致性。若成功,将能利用互联网规模的人类视频自动扩充机器人训练数据,显著降低数据收集门槛。业界对机器人数据扩展投入巨大,跨具身视频生成是其中关键路径;但若生成视频不可靠,反而污染训练集。H2R-Bench 提供诊断式五维评估(目标完成、动作事件、功能接触、具身正确性、视频质量),能定位具体失败维度。
行业类比
类似用海量人类驾驶视频训练自动驾驶时,必须将人类操作映射到方向盘/踏板等执行器上,且保持交通规则和物理约束;跨具身视频迁移同样需要保证可执行性而非单纯视觉相似。
核心洞察
- H2R-Bench 提出了一种多维、任务导向的跨具身视频生成评估框架,专门检验功能接触传递与具身一致性。它不同于仅依赖像素级相似度或通用视频生成指标(如 FVD、CLIP score)的基准,而是将评估分解为目标状态完成、动作事件完成、功能接触传递、具身正确性和视频质量五个维度,直接验证生成视频是否保留了源人类演示中的操作语义、物理交互和末端执行器形态,从而更贴近机器人学习对训练数据的真实需求。
- H2R-Bench 引入了 native-interface generation protocol,直接调用各模型的默认公开接口或推理配置进行评测,不对模型做内部微调或额外条件注入。这一设计模拟了从业者在实际部署中直接使用现成视频世界模型进行跨具身合成的条件,能够揭示模型在零样本设置下的真实表现,避免因针对特定模型定制后处理而掩盖其跨具身迁移的固有缺陷,为跨模型比较提供了公平且统一的基准。
方法
H2R-Bench 将 human-to-robot manipulation video generation 形式化为条件视频生成任务:输入为一段第一人称人类操作视频 和目标机器人末端执行器约束(如平行夹爪或灵巧手),输出为保留源任务语义、但由指定机器人执行的合成视频。
基准实例构建
每个实例包含:
- 源视频:筛选自大规模第一人称人类操作数据,按任务族分层采样,确保覆盖不同动作与物体交互;
- 结构化标注:人工对源视频进行 clip grounding 与逐帧语义标记,涵盖 task goal、action event、functional contact、object response 四类 source-grounded annotations;
- embodiment 约束:明确机器人类型、参考图像等 embodiment specification。
生成协议
采用 Native-Interface Generation Protocol:不强迫模型适配统一输入格式,而是通过其原生 API/推理接口输入视觉条件和文本提示,生成机器人视频。这避免引入额外提示工程偏差,更贴近实际部署时模型使用方式,也便于不同架构模型直接对比。
迁移感知评估
评估包含五个维度,分为任务完成度与迁移保真度两类:
- Goal-State Completion (M1):目标状态是否实现;
- Action-Event Completion (M2):关键动作事件是否出现;
- Functional Contact Transfer (M3):功能接触语义是否从人手迁移到机器人末端;
- Embodiment Correctness (M4):生成视频中的机器人形态是否与目标实施例一致;
- Video Quality (M5):通用视频质量(如时序一致性、清晰度)。
对每个维度使用 VLM judge 与定量指标结合,并按维度加权聚合。同时提供 human evaluation 与 automatic judge 的一致性校验。该框架可直接用于筛选合成数据、指导机器人策略训练前的数据质量控制。
与 VBench 等通用视频生成基准不同,H2R-Bench 专攻跨实施例迁移,强调 functional contact 与 embodiment consistency,而非仅画面质量;且采用 source-grounded annotations 支撑可解释的失败诊断。
实验
实验设计
H2R-Bench 构建了 跨 embodiment 的人类到机器人操作视频生成评测 实例,每个实例包含人类演示视频、目标 embodiment 约束(如 gripper 或 dexterous hand)以及 source-grounded 标注(任务目标、动作事件、功能接触、物体响应)。基准覆盖 六个操作家族 和 两种机器人末端,使用 native-interface generation protocol 调用 11 个 SOTA 视频生成模型。评估分为五个维度:M1 目标状态完成、M2 动作事件完成、M3 功能接触转移、M4 embodiment 正确性、M5 视频质量,结合自动 judge 与人类评估。
关键发现
当前视频世界模型在 human-to-robot 转移上仍很有限:即使领先模型也常在 embodiment 一致性、功能交互 和 任务执行 上失败。诊断实验显示 gripper 与 dexterous hand 之间存在明显的 embodiment 效应,且提供 robot reference image 会影响生成质量。VBench 与 H2RCore 的对比表明通用视频指标无法捕捉跨 embodiment 的功能保真度。
与基线对比的深度解读
与仅关注视觉质量的 VBench 等基准不同,H2R-Bench 通过 任务导向的 grounded annotations 显式检验 embodiment 转移是否正确,不单看视频是否“像”。其系统诊断框架回答的核心问题是:视频世界模型能否真正桥接 human-to-robot embodiment gap,将人类操作观察转化为 robot-centric 训练资源。11 个模型的整体表现显示这一转化目前尚未成熟,但该基准为后续模型迭代提供了精确的失败归因维度。
行业影响
落地场景
H2R-Bench 直接服务 机器人操作数据生成 与 世界模型评测。典型业务包括:
- 电商仓储拣选:将仓库工人的拣选操作视频转为机械臂抓取视频,快速覆盖长尾商品与货架布局,降低对遥操作采集的依赖。
- 机器人学习平台:如 Physical Intelligence、Skild AI 等,用该基准评估视频生成引擎,决定是否将其纳入数据闭环。
- 机器人数据服务商:利用人工演示视频批量产出多实施例机器人轨迹,形成可销售的数据产品。
商业价值
核心降本:传统遥操作采集单条轨迹成本高,H2R-Bench 能筛选出可部分替代真实采集的视频生成模型,减少数据采集与人工标注开销。同时提升训练数据多样性,加速策略泛化,缩短技能迭代周期。对提供机器人基础模型或数据服务的厂商,该基准可作为质量门槛,支撑 数据即服务 的商业模式。
与现有产品/工作流集成
H2R-Bench 可作为 离线评测环节 嵌入现有机器人数据管道:
- 在数据合成前,用 H2R-Bench 对候选视频生成模型做快速基准测试,输出五维得分。
- 在持续集成中,定期运行 benchmark 监控模型升级对跨实施例转换能力的影响。
- 与数据管理平台(如 HuggingFace Datasets、Scale Nucleus)对接,将评测结果作为数据质量标签。
该基准帮助团队在采用生成式机器人数据前建立明确的质量评估门槛,避免劣质合成数据污染下游策略训练。
局限
- **覆盖范围有限**:H2R-Bench 目前仅覆盖 6 个 manipulation families 和 2 种机器人 embodiment(gripper 与 dexterous hand),数据来源以 egocentric 人类视频为主,对真实场景中更丰富的任务类型、物体属性、相机视角以及多指灵巧手以外的 embodiment(如移动机械臂、软体手)泛化不足。与 **VBench** 等已有视频生成评测相比,H2R-Bench 在任务多样性和硬件覆盖上仍较窄,限制了跨 embodiment 迁移能力评估的普适性。 **可推断弱点**:由于标注依赖人工对 source-grounded annotations 进行结构化整理,规模扩展成本较高,且可能存在标注主观性。
- **评测机制依赖大模型**:H2R-Bench 采用多模态大模型作为自动 judge,虽然论文报告了与人类评估的一定一致性,但这类 judge 本身可能存在模型偏差(如对特定 embodiment 或视觉风格的偏好),影响评分的稳健性。此外,基准仅评估生成视频的视觉质量和语义完成度,并未验证生成视频作为下游机器人策略学习的训练数据时的实际效用,即真实机器人演示能否被有效替代仍未可知。
- **缺乏模型适配与深度诊断**:论文仅评测了 11 个现有通用视频生成模型,其中多数未针对机器人操作视频进行专项优化或微调,因此结果可能低估了专门模型的潜力。同时,论文未提供针对 human-to-robot 迁移的模型架构改进或训练策略分析,诊断维度集中在结果表现,对失败原因(如 embodiment 混淆、物理交互错误)的归因深度有限。