该引注是否切中要点?
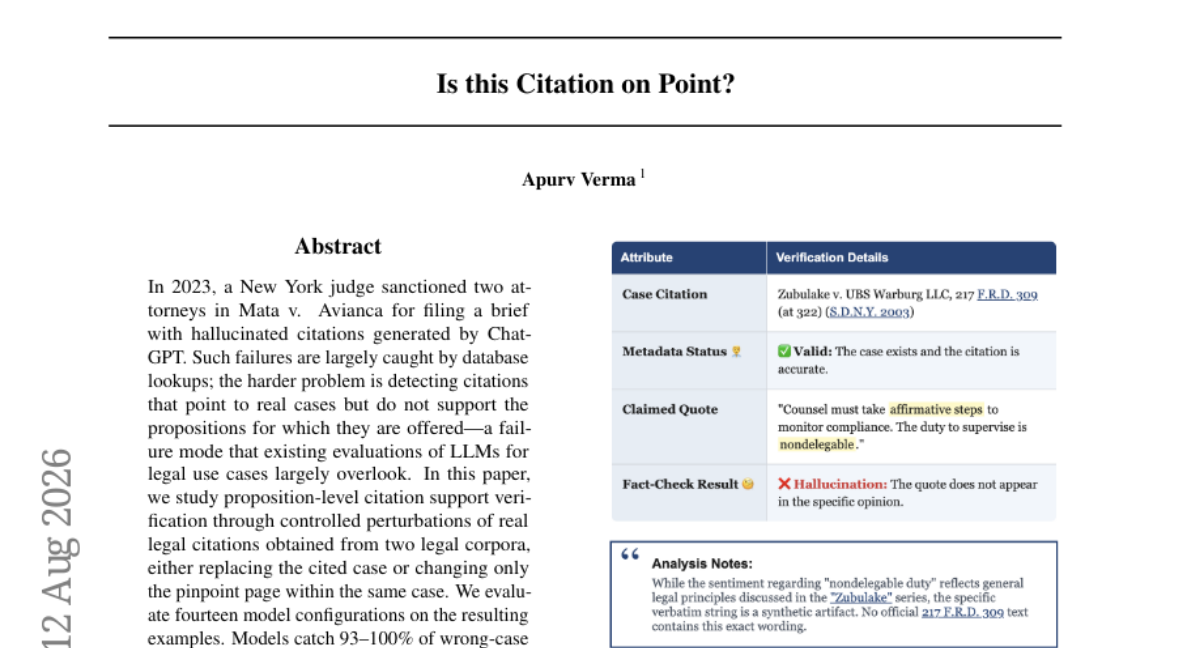
2023 年,纽约法官在 Mata v. Avianca 案中制裁了两名律师,因其提交的状纸包含 ChatGPT 生成的幻觉引注。这类失败大多可被数据库查询捕获;更难的是检测引注指向真实案例但不支持所引命题的情况——现有面向法律场景的大模型评估对此严重忽略。 我们通过受控扰动研究命题级引注支持验证:从两个法律语料库获取真实引注,要么替换所引案例,要么仅改动同一案例内的定位页。我们评估了十四个模型配置。 结果显示,模型能捕获 93-100% 的错误案例扰动;但对法院意见中的错误定位页仅捕获 37-61%,对法律简报捕获 52-83%。当模型漏查错误定位页时,它们基于主题重叠而非页面级支持接受引注。模型规模与扩展推理缩小了差距但未消除:GPT-5.4 高推理努力下仍漏掉法院意见中 40% 的定位页不匹配,简报上漏 18%。提示模型验证所引用页面的支持可提升召回率,但也提高了误报率。 综上,识别正确法律主题与验证所引命题的支持是两种不同能力,当前模型将二者混为一谈。
论文精读
TL;DR 受控扰动真实法律引文发现:LLM 能高精度识别错引案例,却大量漏检仅页码错误的引文,将主题相关误判为命题级支持,揭示法律 AI 验证的关键盲点。
问题
法律 AI 引文验证 当前关注 LLM 生成引文的幻觉问题,错误引文可通过数据库查重快速发现,但引文与命题的支持关系成为新的评估盲区。
现有方法主要评估 wrong-case 级别的错误(引文指向不存在的案例),而 wrong-pinpoint 级错误(引文指向真实案例但页码不支持命题)缺乏系统基准。模型趋向于将 主题相关性(topical overlap)误判为 命题支持(propositional support),而非验证引用页具体内容。实验显示:GPT-5.4 高推理配置仍错过法院意见中 40%、辩护状中 18% 的 pinpoint 不匹配;页面接地提示虽提升召回率,却推高误报率。
技术挑战 在于需要细粒度跨文档语义对齐:准确判断引用页是否包含支撑当前命题的推理依据,而非仅话题相关。法律文书对引文精确性要求极高,Mata v. Avianca 案中律师因虚假引文受制裁即为例证。该问题也反映 LLM 在知识密集型任务中“源-陈述”一致性验证的通用短板。
行业类比:类似代码补全工具引用一个真实存在的库函数,但参数或用法与当前上下文不匹配,仅凭函数名相似就判定为正确。
核心洞察
- 法律引文验证的真正难点不是检测虚构案例,而是验证真实案例是否在页码层面支持命题。以往基准主要关注引文是否存在或案例是否正确,本文通过受控扰动(将正确案例替换为另一案例,或仅改变页码)揭示模型能够识别错误案例(93-100%),但对错误页码仅能捕获37-61%(法院意见)和52-83%(法律简报)。模型倾向于根据主题重叠(topical overlap)接受引用,而非检查引用页是否实际支持命题,这一区分将研究焦点从引文存在性推进到命题级支持验证。
- 增大模型规模与推理努力无法完全解决页码级验证,因为问题本质需要外部元数据而非纯语义推理。实验显示GPT-5.4在高推理努力下仍漏检40%的法院意见页码错误,且page-grounded提示虽能提高召回,却同时推高误报率。这挑战了“更大模型+更强推理即可减少幻觉”的假设,并提示需要结构化引文数据库或专用检索验证器,而非仅依赖模型内生知识。该结论对设计生产级法律AI系统有直接工程启示:应将页码验证作为独立组件,与生成模型解耦。
方法
方法框架
本文提出受控扰动评估框架,用于分离并评测 LLM 对法律引用“命题级支持”的验证能力。
输入:从 CLERC(法院意见)和 BriefMe(法律简报)两个语料库提取真实引用,每条数据包含被引案例、pinpoint page 及待验证的法律命题。
关键模块 分三步:
扰动生成:对原始引用施加三种受控腐败(corruption),难度递增:
Random Document Corruption(简单):将引用替换为随机无关案例;Same-Document Corruption(中等):替换为同一文档中出现的其他案例;Wrong Page Number Corruption(困难):保留原案例,仅改动 pinpoint page,使新页码内容不支持该命题。 所有扰动均经人类验证,确保标签正确。
模型评估:14 个模型配置接收(命题,引用)对,输出二元判断“是否支持”。基线 prompt 仅要求验证引用是否支持命题。记录 recall(正确拒绝腐败引用)与 false positive rate。
诊断与干预:对失败案例进行定性分析,发现模型常用主题重叠代替页面级验证,并编造支持理由。据此提出
page-grounded prompting,强制模型在指定页码上检查支持证据。
输出:各难度级别上的检测性能与错误模式。
与同类方法差异:区别于仅检测完全虚构引用的工作,本方法通过受控改动 pinpoint page,将评测重心移至“引用是否真正支撑当前命题”,更贴合真实法律检索中的核心难点。
实验
实验设计
研究构建 受控扰动评估,从两个美国法律语料库 CLERC(法院意见)与 BriefMe(法律简报)中抽取真实引用,然后注入两类破坏:替换为错误案例(wrong-case)或仅更改同一案例内的 pinpoint 页码(wrong-pinpoint)。共评估 14 个模型配置,包括不同规模与推理努力级别。人类标注验证确保扰动后引用确实不再支持原命题。
关键发现
- 模型对 wrong-case 破坏 检测率高达 93-100%,说明案例级幻觉引用不再是主要瓶颈。
- 但面对 wrong-pinpoint 破坏,性能急剧下降:在法院意见上仅 37-61%,在法律简报上 52-83%。即使 GPT-5.4 启用高推理努力,仍错失法院意见中 40%、法律简报中 18% 的 pinpoint 不匹配。
- 失败模式分析显示:模型混淆 主题相关性 与 命题支持,往往因话题相似而接受错误页码;部分输出生成虚构的支持理由,或仅检查引用中的逐字引文而忽略实际命题契合。
- 页面接地提示 能提升召回率,但同时提高误报率,在精确率与召回率之间留下权衡。
对比解读与工程启示
现有法律 LLM 评测大多只关注案例级幻觉(例如伪造案例),而本研究揭示更隐蔽的失败:引用真实案例但页码不支持命题。这种失败更难被数据库查重捕获,对法律检索、RAG 和引用验证系统构成实际风险。
实际工程上,应将 引用支持验证 拆分为两个独立模块:先判断案例与命题的主题相关性,再精确核对 pinpoint 页面内容是否包含支持该命题的具体陈述。仅依赖缩放模型规模或增加推理步数无法关闭差距,需要引入 页面级检索增强 或结构化引用知识库,并在提示中显式要求模型核对页面文本而非仅看摘要。
行业影响
落地场景
法律科技与 企业法务 平台可将本研究的 命题级引用支持验证(proposition-level citation support verification)嵌入文书辅助工具。例如,合同审查与法律备忘录生成产品中,模型在输出引用案例后自动检查该案例的 pinpoint page 是否真正支持陈述;电商平台合规团队用 LLM 生成隐私政策解释时,验证引用的判例页码与所主张的法律论点是否一致。
商业价值
直接降低法律从业者的人工核对成本:当前 LLM 漏检 wrong-pinpoint 错误率最高达 40%(法院意见书),人工逐页核对耗时且昂贵。引入针对性验证层可减少法律风险与潜在 sanction(制裁),避免因错误引用导致失职诉讼,提升客户信任。
与现有工作流的接口
可作为 RAG pipeline 的后置校验器:在法律文献检索结果与生成文本之间加入一个 页面级支持分类器,对 LLM 输出的每个 citation 调用验证 API,若置信度低则触发人工复核或重新检索。也可集成到法律研究数据库(如 LexisNexis / Westlaw 类产品)的写作插件中,提示用户“该引用不精确”。建议采用 page-grounded prompting 变体并在低风险场景逐步放量,监控误报率。
局限
- **受控扰动与数据覆盖有限**:论文通过将真实 `citations` 中的案例替换为随机文档或仅改变 pinpoint 页码构造负例,但真实法律写作中的引用错误形式更多样,例如错误引用规则、断章取义或错误 paraphrase。实验仅用 `CLERC` 与 `BriefMe` 两个英文美国法律语料,且人类验证只覆盖子集,结论未必能推广到其他法律体系或文档类型。扰动策略本身也可能引入人工痕迹,模型可能依赖表面模式而非真正理解引用支撑。
- **评价指标与任务设定单一**:研究聚焦二元检测,即 `citation` 是否 on point,未评估模型主动生成正确 pinpoint 引用或判断多命题复合支撑的能力,也未覆盖法律引用分类中的区分性引用(如 distinguishing / criticizing authorities)。对实际工作流来说,识别引用不当只是第一步,模型还需能够定位具体不支持页码或给出修正建议,这些能力尚未纳入评估,限制了对系统可用性的全面判断。
- **缓解方案效果有限且未深入优化**:page-grounded prompting 虽然提高 Hard 样本召回,但同时提高误报率,且未探索检索增强、精细对齐或多步验证等降低 false positive 的策略;即使高推理预算的 `GPT-5.4` 仍漏检 40% court opinions 和 18% briefs 的 pinpoint 错配,说明仅靠 prompt 与 scale 不足,缺少针对模型架构或训练目标的系统性改进。