离散扩散的Simplex松弛
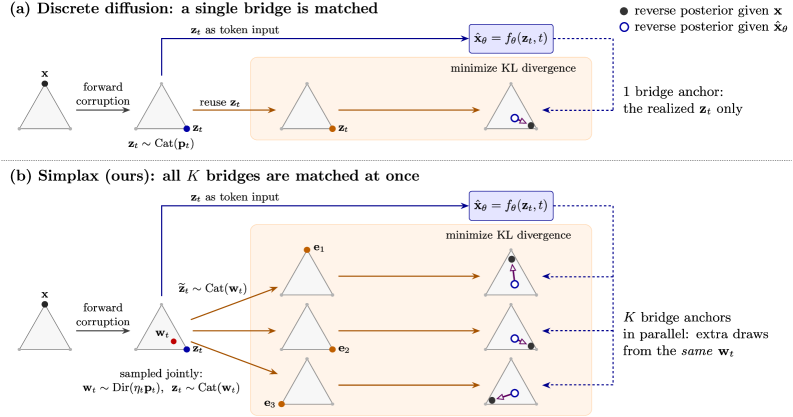
离散扩散模型 是一类用于类别数据生成的方法,其行为由损坏核决定。针对 均匀离散扩散,本文提出 Simplax,一种精确的 Dirichlet-类别增强 方法:将每个损坏的类别状态与一个辅助的单纯形值变量耦合,同时保持原始均匀扩散过程作为其类别边际。该方法在不改变底层类别损坏过程的前提下,丰富了训练目标与反向转移。 基于该增强,我们推导出 Rao-Blackwellized反向桥目标 和对应的 随机反向采样器。值得注意的是,去噪器的输入仍是损坏的类别状态,无需访问辅助变量,因此训练与采样过程保持简洁。 实验方面,Simplax 在无条件 OpenWebText 生成上改善了生成困惑度-熵权衡。在 数独 任务中,仅使用 30-clue 谜题训练的模型,在所有评估线索密度(含最小唯一可解的 17-clue 区域)上取得了最高准确率;在无条件生成中也达到了最高有效性。
论文精读
TL;DR Simplax 通过 Dirichlet-categorical 增广将均匀离散扩散状态松弛到单纯形,在不改变原 categorical 边缘过程的前提下,用 Rao-Blackwellized 反向桥目标改进训练与采样,显著提升文本生成质量与数独求解准确率。
问题
问题背景
离散扩散模型通过定义 corruption kernel 逐步将离散数据(如 token 序列)加噪为简单分布,再学习逆向去噪。该框架在文本、分子生成、约束求解等任务中展现出潜力,但如何设计更优的训练目标与反向采样器仍是活跃方向。
现有方法局限
- 主流 uniform discrete diffusion 将中间状态限定在离散类别空间,反向预测问题仅依赖离散 token 标签,缺少连续几何/概率结构,限制了 denoiser 的表达能力。
- 训练目标通常为 cross-entropy 或类似分类损失,只能利用 corruption 过程的边缘分布,无法访问更丰富的统计信息,导致生成质量与熵之间的权衡难以精细调节。
- 反向采样常采用 greedy 或温度缩放,缺乏基于辅助连续变量的随机化机制,容易陷入低熵重复或高熵噪声。
- 若试图增强目标或采样器,往往需要修改底层 categorical corruption process,破坏训练与推理的一致性;在保持原离散边际不变的前提下丰富模型,一直缺少系统方法。
为什么这个问题难/重要
技术上,离散空间没有自然梯度或欧氏结构,直接引入连续松弛需要精确的概率分解,且必须保证原 uniform diffusion 作为 categorical marginal 被完全保留——这是一个严格的统计约束。从工程角度看,文本生成、代码补全、分子设计等任务需要同时提高生成质量和多样性(如 generative perplexity-entropy tradeoff),而现有方法常在这一权衡上表现不足。此外,Sudoku 这类约束求解任务要求模型在不同 clue density 下保持高准确率,对离散扩散模型的推理效率与泛化能力提出更高要求。因此,能在不改变 corruption 过程的前提下丰富训练与采样,具有重要实用价值。
行业类比
类似在自回归 token 生成中,仅使用 token ID 进行预测会丢失 embedding 空间的连续几何信息;Simplax 为离散扩散引入的辅助 simplex 变量,可类比为给离散状态增加了一个连续正则化通道,在保持采样一致性的同时提升生成多样性。
核心洞察
- Simplax 的 **Dirichlet-categorical augmentation** 在不改变底层 uniform discrete diffusion 过程的前提下,引入了精确耦合的 simplex 辅助变量,实现了对中间状态空间的无损扩展。 区别于直接修改 corruption kernel 的方法,该增强严格保持 categorical marginal 等于原均匀扩散,因此可以复用现有离散扩散的训练框架与评估协议。同时新增的辅助变量为反向过程提供连续信号,避免了连续松弛方法中边际分布失配的问题。
- Simplax 利用 Dirichlet 分布的共轭性质,推导出 **Rao-Blackwellized reverse-bridge objective**,对辅助变量进行解析边际化,消除了离散状态采样带来的 Monte Carlo 噪声。 与常见的 auxiliary-variable 扩散模型相比,该目标具有闭式形式,训练方差更低、收敛更稳定。尤为关键的是,denoiser 仍只接收 corrupted categorical state,推理时无需额外输入或更改模型结构,工程落地成本极低。
- 在 Sudoku 任务上,Simplax 仅在 30-clue 谜题上训练,却在全部 clue 密度(含 17-clue 最小唯一可解区域)取得最高准确率,并在无条件生成中达到最高 validity。 这表明增强的表示学习不仅改善文本生成的 perplexity–entropy tradeoff,还提升了模型在组合约束推理任务上的泛化能力。与基线相比,该方法未增加推理时计算或修改 corruption kernel,即在更稀疏、更困难的推理场景中表现更优,验证了表示增强对下游任务的实际价值。
方法
输入与问题定义
- 输入:离散序列(如文本 token 或 Sudoku 棋盘),通过均匀离散扩散过程逐步损坏,得到损坏状态
x_t与噪声时间步t。 - 前向损坏过程保持不变:每个时间步以均匀概率替换 token 为其他类别,对应均匀离散扩散的 corruption kernel。
关键模块:Dirichlet-categorical 增强与 Rao-Blackwellized 目标
- 辅助变量引入:为每个损坏状态耦合一个辅助 simplex 变量(服从 Dirichlet 分布),该变量携带类别概率信息,并与原始状态构成精确的层次结构,边缘分布仍为原分类分布。
- Rao-Blackwellized 反向桥目标:利用辅助变量将原始交叉熵目标替换为基于 Dirichlet 参数的条件期望,降低训练方差,提高梯度信噪比。
- 随机反向采样器:采样时从增强联合分布中采样辅助变量再映射回离散 token,实现更细腻的探索。
- 保留原始 denoiser 输入:模型仍以损坏状态
x_t作为输入,预测 Dirichlet 参数而非直接预测干净 token,保持架构兼容。
输出与生成
- 输出:训练后的模型可进行无条件生成(如 OpenWebText)或约束生成(如 Sudoku),通过迭代反向采样从噪声恢复出有效样本。
- 效果:在 OpenWebText 上改善困惑度-熵权衡;在 Sudoku 上仅用 30 线索训练即可达到最高准确率。
跟同类方法的差异点:Simplax 在不改变原始离散扩散前向过程的前提下,通过精确的 Dirichlet-categorical 增强实现目标函数和采样器的改进,避免了直接在 simplex 上定义扩散或混合模型带来的兼容性问题。
实验
实验设计
- 数据集:
OpenWebText(无条件文本生成)、Sudoku(受限类别生成) - 任务: 无条件生成与条件约束生成;诊断实验覆盖 self-conditioning、denoiser input 选择、UDLM 初始化
- 评估指标: 生成 perplexity 与 entropy 的权衡、Sudoku 求解准确率与生成有效性
关键发现
- 在
OpenWebText上,Simplax 改善了 generative perplexity–entropy tradeoff,同等熵下获得更低困惑度。 - 在
Sudoku上,模型仅用 30-clue 谜题训练,在所有 clue density(含最小唯一可解的 17-clue)下取得最高准确率;无条件生成也取得最高有效性。 - 消融表明保留 corrupted categorical state 作为 denoiser 输入对性能有益。
基线对比解读
- 相较于标准离散扩散及 auxiliary-variable 类方法,Simplax 的核心差异在于不改变底层 categorical corruption process,而是通过 exact Dirichlet–categorical augmentation 引入辅助 simplex 变量。
- 这使得 reverse-bridge objective 可做 Rao-Blackwellization,降低方差,同时保持 reverse sampler 可 tractable 随机采样。
- 结果说明在不增加 forward corruption 复杂度的情况下,仅改进训练目标与 reverse transitions 即可带来生成质量提升。
行业影响
落地场景
Simplax 适用于所有离散 token 生成类业务,例如 对话式 AI 与内容创作平台、代码助手、分子生成(药物发现)、推荐系统(物品 ID 序列生成)以及 约束满足类结构化生成(如排程、表单校验)。在电商场景中,可生成更连贯的商品描述与客服回复;在代码生成中,可降低语法 / 逻辑错误率;在药物分子生成的离散空间(如 SMILES 字符串)中,可提升候选分子有效性。
商业价值
核心收益来自 降本与体验提升。更优的困惑度 - 熵权衡意味着生成内容更准确、少歧义,减少人工校对与二次修正成本;对于代码生成,提高一次通过率直接节省开发者时间;在药物设计中提高有效候选比例可缩短早期筛选周期。对于内容平台,更好的生成质量可提升用户留存、互动率与广告转化。约束生成的能力还能支撑自动化合规、规则严密的业务表单,降低错误风险。
跟现有产品 / 工作流的接口
Simplax 可作为 离散扩散训练框架的插件式升级:保留原始 corrupted categorical state 作为 denoiser 输入,允许在现有 UDLM、D3PM 等模型中直接 替换训练目标 与 替换采样器,无需大幅改动架构。工程上可先在小规模任务上验证困惑度 - 熵曲线,再逐步推广到生产模型;兼容主流 GPU 训练栈与推理部署,也可与自回归解码、分类器引导等方法结合使用。
局限
- **适用范围局限于 uniform discrete diffusion**:论文方法针对 uniform corruption kernel 设计,其 Dirichlet-categorical augmentation 与 Rao-Blackwellized objective 是否可迁移至 absorbing、masked 等其他常见离散扩散核尚不明确。在实际生成任务中,masked/absorbing diffusion 往往更高效、更常用,如果 Simplax 无法覆盖这些变体,其工程影响力会受到限制。
- **实验规模与任务多样性有限**:评估仅覆盖 OpenWebText(无条件文本生成)与 Sudoku(约束生成)两个任务,且 Sudoku 的序列长度和状态空间较小、结构特殊(强规则约束),可能无法充分反映方法在大规模文本建模、代码生成或多模态离散潜变量上的表现。此外,论文未报告采样速度、内存开销与参数效率等系统级指标,对实际部署的指导不足。
- **对初始化与预训练权重依赖较强**:论文在 OpenWebText 上使用了 UDLM initialization 进行诊断,且最终 Simplax checkpoint 可能基于预训练模型微调。这暗示方法在冷启动训练下的收益可能不显著,甚至需要额外的 pretraining 阶段才能达到报告的效果。若缺乏大规模预训练资源,该方法在实际应用中的可复现性存疑。