多模态模型 Diffing 用于特征发现与控制
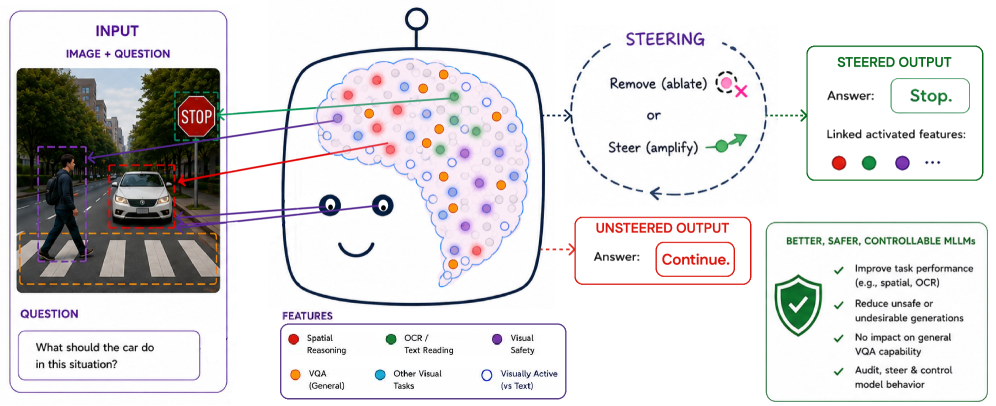
问题:多模态大语言模型(MLLMs)虽具备强大视觉理解,但内部特征难以识别、审计或控制。稀疏自编码器(SAEs)虽能分解隐藏状态为可解释特征方向,却难以隔离多模态训练引发的特定特征,也不利于定向操控。 方法:本文提出 MMDiff 框架,训练多模态 SAEs,提供三种功能: 1. 特征隔离:对比基础语言模型 SAE 与其多模态适配版本,定位被多模态训练改变的特征。 2. 特征检测:通过逐 token 对比激活分析,识别因果相关的任务特定特征。 3. 特征控制:因果移除或引导已发现的特征方向。 实验:在 LLaVA-MORE、PaliGemma 2、InternVL3.5 三个 MLLM 家族上训练多模态 SAE,评估视觉空间理解、多模态安全与 OCR。结果显示,移除稀疏因果特征可使空间任务性能平均下降 12%、OCR 下降 17%,多模态安全攻击成功率降低 24%,且对 VQA 性能无影响。特征引导能在标准单层 baseline 基础上,将空间与 OCR 准确率平均提升 +3.6% 和 +1.8%。 结论:多模态 SAEs 不仅可作为解释工具,还能对 MLLM 行为进行审计、引导与操控,助力更安全、更强大的生成。
论文精读
TL;DR MMDiff 通过对比基础语言模型与多模态模型的 SAE 特征,定位视觉/安全/OCR 相关特征;因果移除可选择性削弱目标行为(OCR 降 17%),操控带来 +3.6%/+1.8% 精度提升且不影响 VQA。
问题
问题背景:当前多模态大语言模型(MLLM)在视觉理解上表现优异,但内部表征如何驱动特定行为仍不透明,可解释性、审计与可控性需求日益迫切。
现有方法局限:稀疏自编码器(SAE)可将隐状态分解为可解释特征方向,但存在两方面不足。其一,训练于基础语言模型的 SAE 无法直接识别多模态训练具体改变了哪些特征,模型 diffing 的缺失使得审计无从下手。其二,直接对 MLLM 激活训练 SAE 得到的特征字典虽可解释,却往往夹杂大量与任务无关或高度纠缠的方向,难以直接用于因果干预。
为什么难/重要:MLLM 的跨模态表征空间高度纠缠,视觉与语言信息在中间层混合,导致特征隔离和因果验证需要严格的反事实分析;同时,安全与能力对齐需求要求干预手段不仅可解释,还需能选择性改变目标行为而不影响整体性能。业界对模型审计和特征级操控的关注度持续上升,尤其当模型被部署到高风险场景时。
行业类比:如同在自动驾驶感知栈中需要定位并修正车道线误判的中间表征,而非重训整个网络,MLLM 的可控性同样依赖精细的特征级接口。
核心洞察
- **模型 diffing** 作为一种特征发现新范式,通过对比 base LM SAE 与多模态 SAE 的字典,MMDiff 能隔离出多模态训练引入或改变的特征方向,而非仅对最终 MLLM 做事后解释。与直接在 MLLM 激活上训练 SAE 的工作相比,这种差分视角将特征定义锚定于从文本到多模态的功能转变,天然关联因果行为变化,提供了一种审计模型能力新增来源的通用方法。
- **任务特定特征检测** 无需外部监督。MMDiff 采用逐 token 对比 firing 分析,比较正负样本(如空间正确 vs 错误响应、安全攻击 vs 正常输入)在同一特征上的激活差异,直接定位因果特征。这比基于梯度归因或 probing 的方法更贴近 SAE 特征空间本身,避免额外训练分类器或假设线性可分离,使得特征发现过程可扩展到多种行为和层。
- **特征级操控** 比单层 steering 更精准。因果移除或操控被发现的特征方向,可选择性降低空间和 OCR 能力(12%/17%),减少安全攻击成功率 24%,但不影响 VQA 整体性能。与标准单层 steering 相比,操控这些稀疏特征在空间和 OCR 上分别提升 3.6% 和 1.8% 精度。这证明 SAE 特征可作为细粒度、可组合的控制接口,适合安全审计与定向能力调整。
方法
输入
- 基础 LM 与 MLLM 隐状态:MMDiff 接收一个未多模态适配的语言模型(base LM)与其多模态适配版本(MLLM),以及用于任务刺激的图像-文本 prompt 产生的 token 级隐藏激活。
关键模块
多模态 SAE 训练
以 base LM 已训练的 SAE 字典作为 warm-start,在多模态激活上继续训练稀疏自编码器,得到与基础字典可比较的多模态 SAE;这避免直接随机初始化导致字典不对齐,使后续 diffing 有意义。
特征隔离(model diffing)
对比 base-LM SAE 与多模态 SAE 的特征方向,结合 visual-energy(特征对视觉 token 的激活量)与余弦相似度等指标,筛选出被多模态训练显著改变的特征。
任务特定特征检测
采用 per-token contrastive firing analysis,对目标行为构建正样本(如成功空间推理的 token)与负样本(视觉反事实或词汇不变 prompt),比较特征激活频率差异,过滤出高度任务相关的因果特征。
输出与控制
输出为稀疏、因果敏感的特征方向,可直接用于 移除(ablation) 或 steering,从而选择性抑制或增强目标行为(如空间推理、OCR、多模态安全),且不显著影响无关能力(如 VQA)。
与直接在 MLLM 激活上训练标准 SAE 并仅做事后解释不同,MMDiff 通过 base LM 与多模态模型字典的显式 diffing 隔离多模态训练引入的特征,并将字典转化为可操作的特征级控制接口。
实验
实验设计
MMDiff 在 LLaVA-MORE、PaliGemma 2、InternVL3.5 三个 MLLM 家族上训练多模态 SAE,通过模型 diffing(base-LM SAE 与多模态 SAE 对比)隔离适配特征;采用逐 token 对比激发分析定位任务特定特征;应用因果移除与特征引导进行评估。测试覆盖视觉空间理解、多模态安全、OCR 三类任务,并对比单层激活引导基线。
关键发现
因果移除特征导致目标行为选择性下降:空间任务平均下降 12%,OCR 下降 17%,多模态安全攻击成功率降低 24%,且 VQA 性能无显著影响。引导特征使空间准确率提升 +3.6%、OCR +1.8%(对比单层引导基线)。消融实验证实模型 diffing 的必要性;随机特征移除不产生类似效果,验证了被发现特征的因果特异性。
基线对比解读
与标准单层激活引导相比,MMDiff 的多特征联合引导带来约 +3.6% / +1.8% 的提升,说明跨层 SAE 特征空间具有更好的可操控性和语义对齐性。特征移除的选择性退化(不损害 VQA)证明特征方向对应特定行为而非全局扰动,表明 SAE 可同时作为审计与控制接口。
行业影响
落地场景
MMDiff 提供面向多模态大模型 (MLLM) 的特征发现与操控接口,可直接落地于以下业务:
- 电商内容审核:对商品图文描述进行幻觉检测与不安全内容过滤,利用特征消融降低攻击成功率 24%。
- 医疗影像辅助诊断:在放射报告生成中定位并控制空间推理与 OCR 错误,提升报告可靠性。
- 自动驾驶感知验证:审计视觉问答模型中的空间理解特征,用于回归测试与安全审计。
商业价值
核心价值在于将模型可解释性转化为产品能力:
- 降本:通过针对性特征消融替代全量重训,快速修补已知缺陷,节省算力与数据成本。
- 增收:提升 OCR 与空间任务准确率,可直接改善文档自动化、商品属性抽取等服务的 SLA。
- 体验提升:在生成式 AI 助手中嵌入安全 steering,减少违规输出,降低合规风险。
与现有工作流接口
MMDiff 的训练产出一组 多模态 SAE 字典 与 特征方向,可作为:
- SAE 模型库 接入
SAELens等现有 SAE 工具链; - 特征监控面板 集成至 MLflow / Weights & Biases,用于生产环境异常检测;
- 推理时 steering 插件 通过修改隐藏状态注入特征方向,无需重新训练模型。
项目开源: MMDiff GitHub
局限
- - **训练成本与可扩展性受限**:MMDiff 需要为每个 MLLM 的基座 LM 和视觉适配后模型分别训练 SAE,计算开销显著;且针对不同层和不同模型需重复训练,难以扩展到更大规模模型或更细粒度分析。论文在 limitations 中也承认 SAE 训练本身引入的超参数(如稀疏度、字典大小)会影响特征质量,当前消融虽覆盖一部分配置,但仍缺乏系统性指导。
- - **特征操控的副作用与泛化性未充分评估**:论文展示了特征移除/操控对目标任务的因果影响,但未深入考察对模型其他能力(如通用推理、生成流畅性)的副作用。移除特征可能破坏模型内部表征的连贯性,导致不可预见的行为降级。此外,steering 提升仅在空间和 OCR 任务上验证,对于分布外样本或跨域场景,操控效果是否稳定存疑。
- - **与直接对 MLLM 训练 SAE 相比,diffing 的必要性未完全证明**:论文附录 D.8 中对比了直接对 MLLM 激活训练 SAE 的效果,结果表明 diffing 仅在部分任务上有明显优势。此外,任务特定特征发现依赖对比激活分析,需要手工构建正负 prompt 对,这引入主观偏差且难以自动化。该方法目前聚焦于静态图像-文本任务,对视频、音频等多模态流的扩展性尚不明确。