基于变分学习的 RLVR 参数探索
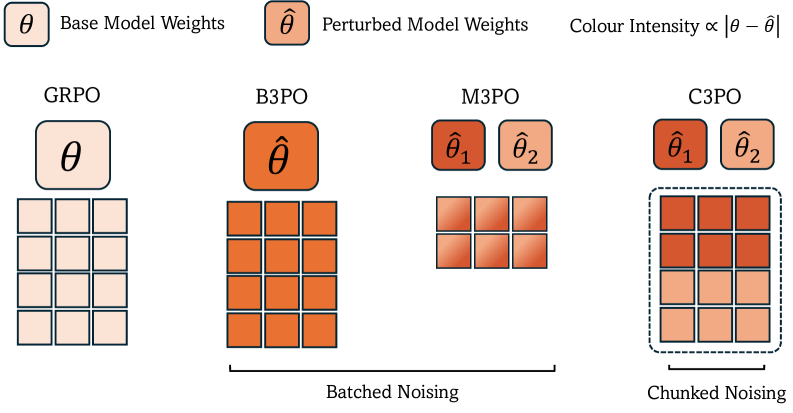
探索一直是强化学习研究的重点。近期,越来越多的证据表明,它在 LLM 强化学习流程中也是重要组成,能显著影响下游性能。许多现有方法在动作空间中控制探索,例如使用温度缩放,但这些方法无法对 token 重新排序,只能影响输出分布的方差,限制了探索,可能导致发散或训练停滞。 本文研究参数空间探索,即通过从后验中采样不同策略来生成 rollouts。多样化的策略采样可作为探索的互补控制手段。我们提出一类名为 Perturbed Parameter Policy Optimization (3PO) 的方法,采用不同的采样策略和 rollout 分组进行奖励估计。 在 OLMo-3-1025-7B 和 Qwen2.5-Math-7B 上的数学推理与代码生成任务实验中,该方法在几乎相同的 FLOPs 成本下,平均下游性能持续优于标准 GRPO。此外,使用多个参数样本在训练中比 GRPO 和动作空间基线产生更少的零优势组和畸形/错误 rollouts。 总体上,我们的工作证明参数空间探索可以改善 LLM 的强化学习。
论文精读
TL;DR 提出 Perturbed Parameter Policy Optimization (3PO),对策略参数施加扰动采样生成多样化 rollout,提升 LLM 强化学习探索效率,在数学推理与代码生成上优于 GRPO 且计算成本相近。
问题
问题背景:RLVR 已成为提升 LLM 推理能力的核心后训练范式,探索策略的多样性直接影响最终性能。
现有方法局限:主流方法在动作空间控制探索,如温度缩放,仅能改变同一策略输出分布的方差,无法重新排序 token 或改变策略本身。这限制了探索的维度,尤其在长程推理任务中,奖励信号稀疏,容易产生大量零优势组和 malformed rollouts,导致训练停滞或发散。GRPO 依赖组内相对优势,当组内输出同质化时,梯度更新方向噪声大,难以跳出局部最优。
为什么这个问题难/重要:参数空间探索通过从后验分布采样不同策略参数,可生成本质上不同的 rollouts,但引入多个策略样本会显著增加计算与内存开销,且需要重新设计奖励分组与优势估计以控制方差。如何在近似 FLOPs 成本下稳定地融合参数扰动,同时避免过探索导致训练崩溃,是业界关注的关键挑战。该方向有望在不增加推理成本的前提下,提升后训练模型的泛化与鲁棒性。
行业类比:如同代码生成 Agent 中,通过随机扰动模型参数使同一提示产生不同解码路径,从而发现更多可执行代码片段,参数空间探索为 LLM 后训练提供了类似的多策略试错机制。
核心洞察
- - 参数空间探索是对动作空间探索(如温度缩放)的正交补充:通过从参数后验采样不同策略,它能生成结构性不同的 rollout,而非仅改变输出分布方差,从而突破温度缩放无法重排 token 的限制。现有 RLVR 方法普遍依赖动作空间噪声,容易陷入局部策略或训练停滞;而 3PO 将探索融入权重空间,利用变分学习维持参数不确定性,为在线策略优化提供了全新的控制维度。这一角度独特之处在于将“探索什么”从输出 token 扩展到生成策略本身,与 GRPO 等基线相比,能在不增加 FLOPs 的情况下持续提升推理与代码任务的最终性能。
- - 采样多个参数并重新分组 rollout 计算优势(如 M3PO/C3PO)能显著减少零优势组和错误 rollout,这是 RLVR 训练稳定性的关键机制。GRPO 在组内归一化时,若 rollout 奖励相同或质量低下,会产生零优势梯度,导致更新无效甚至发散;而通过参数扰动生成多样化 rollout 后,组内奖励差异增大,有效梯度比例上升。该方法利用变分后验的采样自然实现探索,不需要额外奖励塑形或策略正则,并且 FLOPs 开销几乎不变。这种“用采样多样性替代显式探索奖励”的思路为 LLM 强化学习提供了一种简单且可复用的工程实践,尤其适合数学推理与代码生成等奖励稀疏任务。
方法
方法概述
输入:一组 prompt 和由 IVON 变分优化器维护的当前模型参数后验(包含均值与方差)。
关键模块:
- 参数扰动采样:从后验分布采样多个参数样本(例如
M个),每个样本代表一个略有差异的策略。采样策略分为 Batched Noising(在 batch 维度一次性扰动,对应 B3PO / M3PO)和 Chunked Noising(按 token chunk 独立扰动,对应 C3PO)。 - Rollout 生成与分组:对每个 prompt,用不同参数样本生成多条响应,并根据参数样本进行分组(或混合)用于后续优势估计。分组策略旨在减少零优势组(组内所有响应得分相同)的出现。
- 奖励估计与优势计算:基于 verifiable rewards 计算组内相对优势,类似 GRPO 但利用了跨参数样本的多样性;可结合 Seq-MIS 修正降低方差。
- 变分学习更新:根据优势信号和采样噪声,用变分推断更新后验参数(均值和方差),通过调节
λ(scaling ESS)控制探索强度。
输出:更新后的模型参数后验,以及对应的探索行为(rollout 多样性)。
与 GRPO 或 温度缩放 等 action-space 方法不同,3PO 直接在参数空间施加扰动,使策略能够改变 token 序列的排序结构,而不仅是输出概率的方差,因此提供了互补的探索杠杆,可缓解训练停滞和发散。
实验
实验设计
论文在 OLMo-3-1025-7B 和 Qwen2.5-Math-7B 两个 7B 级模型上进行 RLVR 实验,覆盖数学推理与代码生成任务。提出 3PO 方法家族(包括 B3PO、M3PO、C3PO),对比标准 GRPO 以及基于动作空间探索的基线(如温度缩放)。所有方法在几乎相同的 FLOPs 成本下评估,主要关注平均下游性能、零优势组比例、格式错误/不正确 rollout 比例。
关键发现
- 3PO 一致提升平均下游性能:在数学推理和代码生成任务上,不同 3PO 变体均优于 GRPO 基线。
- 减少训练失败样本:3PO 生成的零优势组和格式错误/不正确 rollout 明显少于 GRPO 与动作空间基线。
- 参数空间探索更有效:通过从后验分布采样不同策略,3PO 能探索不同 rollout,而不仅影响输出分布方差,因此缓解了训练发散或停滞问题。
- 多参数采样优势:使用多个参数样本(
M)比单样本更能稳定训练过程,且与组大小G存在权衡关系。
与基线对比解读
与 GRPO 相比,3PO 在相同算力下获得了更稳定的训练动态和更好的最终策略,说明参数空间探索是动作空间探索的有效补充而非替代。温度缩放只能控制输出分布方差,无法改变 token 顺序,而 3PO 通过扰动策略参数能够重新排序候选 token,从而提供更丰富的探索路径。这一差异直接反映在更低的零优势组比例和更少的格式错误输出上,表明参数空间探索有助于避免探索坍缩,提升 RLVR 的鲁棒性。
行业影响
落地场景
- 3PO 适用于所有采用 RLVR 后训练的大语言模型,覆盖数学推理、代码生成、工具调用等可验证奖励任务。
- 典型产品:AI 编程助手、智能解题应用、企业级客服的知识推理模块、自动化代码审计工具。
- 由于 3PO 与 GRPO 计算成本几乎相同,可在现有 RLVR 管线中直接替换,无需额外 GPU 预算。
商业价值
- 训练稳定性提升:减少 zero-advantage groups 和 malformed rollouts,降低训练发散与停滞风险,节省重复训练的算力和时间成本。
- 同等算力下性能增益:在近相同 FLOPs 下提升下游平均性能,直接带来模型质量升级,对下游用户可感知的准确率、生成质量有正面影响。
- 减少人工调参(如温度、熵正则等探索超参)的投入,降低工程维护成本。
与现有产品/工作流的接口
- 现有 RLVR 流程多基于 GRPO 或 PPO,3PO 可作为替代或增强模块,在 rollout 生成阶段引入参数后验采样(如 IVON 或简单高斯噪声),并调整奖励分组方式(batched / chunked)。
- 集成点清晰:不改变数据 pipeline 和奖励函数,仅需修改训练循环中的策略采样逻辑。可参考 C3PO 仓库实现。
- 对于已部署动作空间探索(温度缩放)的团队,3PO 提供互补的控制维度,可同时使用。
具体落地 use case
- 教育科技:数学解题 AI 助手,用 RLVR 训练逐步推理,奖励基于最终答案匹配。3PO 通过参数空间探索帮助模型跳出局部策略,找到更优推理路径,提升复杂题目的首次解答率。
- 代码生成平台:内部使用 RLVR 训练代码模型,奖励来自单元测试通过率。3PO 可减少生成的语法错误和无效代码,提高有效样本比例,降低奖励方差,加速模型收敛。
局限
- - **模型规模验证有限**:论文实验主要在 7B 参数级别(OLMo-3-1025-7B 和 Qwen2.5-Math-7B)进行,未覆盖更大规模模型(如 30B/70B+)。参数空间探索的收益可能随模型规模显著变化:大模型本身具有更强的泛化与多样性,额外噪声可能带来收益递减或加剧不稳定。这限制了该方法在产业级大模型 RL 管线中的直接迁移,工程团队需在小规模模型上验证噪声尺度后再考虑扩展到超大模型。 - **超参数敏感且依赖特定优化框架**:3PO 引入多个新超参数(MC 样本数 `M`、chunk size `N`、噪声缩放 λ 等),且不同采样策略(B3PO/M3PO/C3PO)的选择需要额外调优。论文虽提供消融,但未给出跨任务一致的调参指南,实际部署时超参搜索成本可能高于标准 GRPO。此外,方法依赖 IVON 变分学习框架,与广泛使用的 AdamW 等优化器集成需要额外工程适配。 - **任务覆盖和因果分析不足**:评估集中在数学推理和代码生成等具有明确验证奖励的任务,对于奖励信号更嘈杂的开放性任务(如创意写作、对话)未做测试,参数空间探索的收益与稳定性未知。同时,论文报告了 fewer zero-advantage groups 和 malformed rollouts,但未深入分析这些改进与下游性能提升的因果关系。