Learning How the World Evolves: 通过潜在动力学推理进行外推的视频世界模型
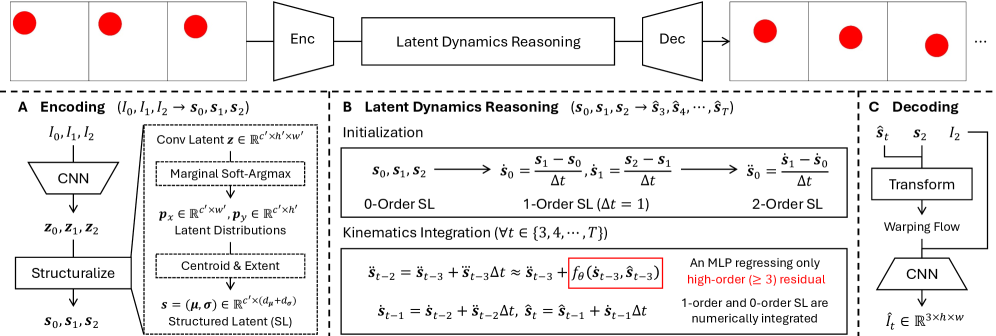
世界沿其动力学(即运动定律)演化。然而,主流视频扩散模型主要拟合像素,并未建模像素随时间如何转移,因此能渲染视觉上合理的帧,但可能无法准确遵循物理定律。为纯粹从像素中捕获动力学,我们提出 Latent Dynamics Reasoning (LDR)。该方法将潜在状态转移显式建模为运动学积分:低阶动力学通过数值积分获得,而模型仅回归驱动推演的三阶及以上残差。为提升外推能力,LDR 在结构化潜在空间(而非稠密卷积特征)上执行该积分。 我们遵循 PhyWorld 基准,在涵盖五个任务(匀速运动、抛物线、碰撞、反弹、逼近)的可控白盒物理测试集上验证 LDR,重点关注分布外场景,以揭示模型是否真正学到底层动力学。实验表明,LDR 能大幅外推所学动力学:在 256² 分辨率下,无论单任务还是多任务训练,其分布内/分布外误差差距比视频扩散基线小 20 倍以上,同时参数量少 26 倍、推理快 143 倍。LDR 甚至能应对严重分布偏移——例如,仅用红色球从左向右运动的训练数据,就能正确预测蓝色方块从右向左的运动。据我们所知,这是首个能将其学到的动力学外推到训练分布之外视频世界模型。项目主页:https://lat-dyn-reason.github.io/
论文精读
TL;DR LDR 将视频世界模型的潜在状态转移建模为显式运动学积分,仅回归三阶以上残差,首次在物理基准上实现超越训练分布的运动规律外推,参数少 26 倍、速度快 143 倍。
问题
问题背景
视频世界模型旨在从视觉观测中学习环境演化规律,用于预测未来帧并支持决策。业界关注其是否真正捕获了物理动力学,而非仅拟合像素外观。
现有方法局限
主流的 视频扩散模型 通过逐步去噪生成未来帧,本质上学习像素的条件分布,并未显式建模像素随时间过渡的动力学。这导致:
- 生成的帧视觉上可能合理,但违反物理约束,例如物体穿模或运动轨迹偏离运动学方程;
- 面对 分布外 (OOD) 场景(如不同速度、物体形状或颜色)时,外推能力迅速退化,难以泛化到训练分布之外;
- 模型参数规模大、推理速度慢,难以用于需要高频闭环交互的系统。
一些工作尝试引入物理先验或结构化表示,但大多在 dense convolutional features 上建模动态,未有效分离低阶运动(匀速、匀加速)与高阶残差,导致数值积分过程不稳定,限制了外推能力。
为什么这个问题难且重要
从纯像素中学习可外推的动力学存在根本挑战:模型必须解耦外观与运动规律,并提取出适合数值积分的状态表示。低阶动力学(位置、速度)可通过显式积分精确求解,但高阶残差(碰撞、形变等)需由网络回归。若表示空间选择不当,误差会在长时 rollout 中累积放大。业界高度关注该问题,因为物理一致的视频世界模型是 机器人操作、自动驾驶仿真、具身智能 等应用的基础组件,任何预测偏差都可能导致下游策略失败。
行业类比
类似工业仿真中需要基于物理引擎的数字孪生,视频世界模型若仅“画得像”而“动得不对”,就像训练自动驾驶规划器时使用不遵守运动学约束的模拟器,最终策略无法迁移到真实世界。
核心洞察
- 显式运动学积分与残差学习解耦了可解析规律与需学习的复杂项。LDR 将潜在转移建模为对低阶运动学项的数值积分,模型仅回归三阶及更高阶残差,而不是像视频扩散模型那样直接拟合整个像素过渡。这种设计让动力学中可积分的线性/二次部分由数值积分器精确处理,网络只负责修正无法解析的高阶非线性,从而在 OOD 场景下不会因端到端拟合而记忆训练分布,外推能力大幅提升。
- 结构化潜在空间是运动学积分得以精确外推的关键。与在密集卷积特征图上做积分不同,LDR 将对象状态编码为结构化潜在变量,使位置、速度等运动学量被显式分离,数值积分可以在这些量上无歧义地执行,避免卷积特征中空间缠绕带来的误差累积。这解释了为何许多基于 latent dynamics 的世界模型虽然声称学到了过渡规律,却无法在分布外泛化:它们的潜在表示不够结构化,积分算子作用在语义不明确的特征上,外推时误差迅速放大。
方法
输入与结构化潜在编码
输入视频帧经结构化潜在编码器映射为低维结构化潜在状态(而非 dense convolutional feature map)。结构化表示使后续动力学积分在低维、解耦空间中进行,避免像素空间冗余。
核心模块:Latent Dynamics Reasoning (LDR) 运动学积分
LDR 将潜在状态的时间转移建模为显式运动学积分:
- 低阶动力学数值积分 对位置、速度等低阶状态量采用固定步长数值积分(如 Euler 或 Verlet)推进,这部分不依赖学习参数,保证长期 rollout 的稳定性。
- 高阶残差回归 模型仅回归三阶及以上的残差项(如 jerk 或更高阶变化),作为驱动积分的外力/加速度修正。残差由轻量网络根据当前潜在状态预测。
- 结构化潜在上的积分 积分运算在结构化潜在空间执行,而不是 dense feature 上,避免卷积特征的空间耦合干扰外推。
解码与优化
积分得到的潜在状态序列经解码器映射回像素空间,输出未来视频帧。训练时以真实未来帧为监督,重建损失约束解码,同时动力学残差网络与编码器、解码器联合优化;初始化策略保证低阶积分从合理的初始状态开始。
输出
最终输出为长时程预测视频,可覆盖训练分布外场景(如新物体形状、颜色、运动方向)。
该设计将物理先验显式注入模型:大部分动力学由数值积分承担,网络只补偿剩余高阶项,因此看到少样本即可稳定外推。
与同类方法的差异:LDR 不同于主流视频扩散模型直接学习像素到像素的映射,而是把潜在转移的绝大部分交给基于运动学先验的数值积分,网络仅回归三阶以上残差,并在结构化潜在空间执行,从而以更少参数实现更强外推。
实验
实验设计
- 在 PhyWorld 基准的 5 个任务(
uniform motion/parabola/collision/bouncing/looming)上做受控白盒测试。 - 训练协议:单任务与多任务联合训练,分辨率 256²,重点评估 OOD 场景。
- 指标侧重 in- vs out-of-distribution error gap,以及参数量 / 推理速度。
关键发现
- LDR 的 in/out-of-distribution error gap 比视频扩散基线小 20 倍以上。
- 在同样条件下,参数少 26 倍,推理快 143 倍。
- 极端泛化:仅训练红球从左到右运动,能正确预测蓝方块从右到左的运动。
- 首次证明纯像素视频世界模型可在训练分布外外推动力学规律。
与基线对比解读
- 基线视频扩散模型拟合像素静态分布,未显式建模像素随时间的转移规律,因此在 OOD 下误差剧增。
- LDR 将潜在状态转移形式化为运动学积分,只回归三阶及以上残差,低阶动力学由数值积分驱动,天然具备外推性。
- 使用结构化潜在空间(而非稠密卷积特征)进一步提升积分稳定性与泛化能力。
行业影响
落地场景
LDR 的核心能力是从像素中学习可外推的物理动力学,适合需要物理一致性的视频生成与预测任务:
- 机器人/自动驾驶仿真:生成符合运动规律的场景视频,用于训练感知或规划模型,特别覆盖分布外(OOD)场景。
- 电商内容生成:自动生成商品动画,如衣物飘动、物体碰撞,减少 3D 物理模拟成本。
- 游戏/影视预演:快速生成符合物理规律的动态预览,辅助创意迭代。
商业价值
- 降本:LDR 参数比视频扩散基线少 26 倍,推理快 143 倍,大幅降低 GPU 成本与延迟。
- 体验提升:物理合理性减少“视觉假象”,提升生成内容的可信度,适用于需要精确运动预测的行业应用。
- 增收机会:可打包为物理引擎增强模块,集成到现有视频生成 API 中,提供差异化功能(如定制动力学)。
与现有工作流接口
LDR 可作为即插即用模块嵌入主流 latent diffusion 视频生成 pipeline:
- 替代或辅助 latent 空间中的噪声预测器,提供显式动力学先验。
- 作为轻量级 post-hoc refiner,对生成视频进行物理一致性校正。
- 支持单任务/多任务训练协议,可与现有 VAE / DiT 架构兼容,微调成本低。
具体 use case:某电商平台利用 LDR 生成“商品跌落展示”视频,用户上传图片即可得到符合物理规律的动画,无需 3D 建模;某自动驾驶公司用 LDR 生成罕见碰撞场景,用于扩充感知模型训练集,提升 OOD 鲁棒性。
局限
- **验证范围有限**:仅在 PhyWorld 合成物理基准的 5 个任务(匀速运动、抛物线、碰撞、弹跳、逼近)上评估,这些场景由简单几何物体和低维动态构成,与真实世界视频的复杂度差距显著。方法对高维观测、遮挡、多物体交互、纹理丰富场景的适用性尚不明确,**泛化到自然视频或具身智能环境仍需进一步验证**。
- **动力学先验限制**:LDR 将 latent 转移建模为显式运动学积分,假设底层动态可由低阶(零阶/一阶/二阶)数值积分近似,且仅回归三阶以上残差。这一假设对刚体运动等物理过程有效,但**对流体、变形体、非物理动态或涉及长期依赖离散事件的复杂系统可能失效**,其适用范围受限于可积分的运动学模型。
- **对比基线与实验规模有限**:实验主要与 video diffusion baseline 对比,未系统比较其他世界模型或物理推理方法(如神经 ODE 世界模型、符号回归等)。此外,论文未报告在更高分辨率(如 512 或真实视频)或更大规模数据集上的表现,**训练数据均为合成渲染,可能掩盖了对真实噪声和外观变化的鲁棒性问题**。