从不可听输入到模型故障:LALMs 中的低频安全风险
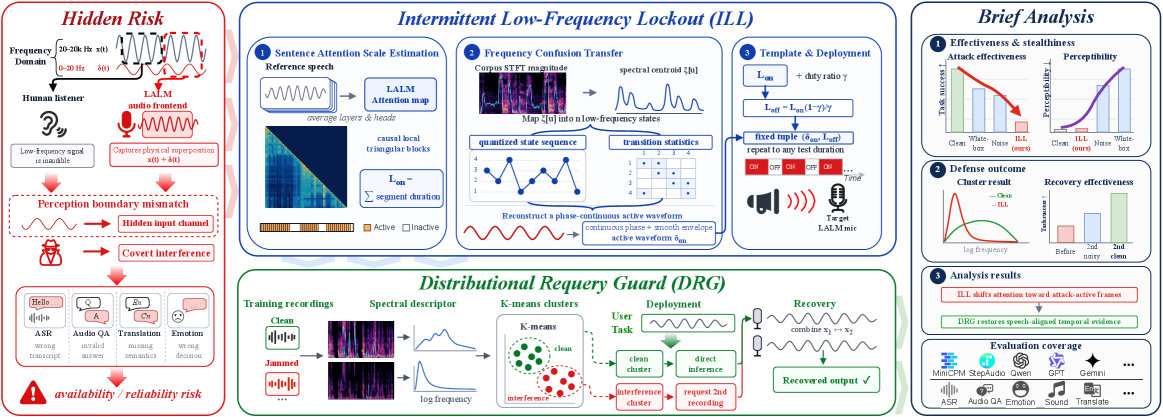
大规模音频语言模型(LALMs)在理解多样音频输入方面展现了强大能力,但这些输入包括人耳不可闻的低频信号,仍可进入模型并影响其生成。然而,此类低频输入的实际影响仍未得到充分探索。为此,本文提出 Intermittent Low-Frequency Lockout(ILL),一种基于通用波形模板的黑盒不可闻红队方法,用于评估这一风险。ILL 通过 Sentence Attention Scale Estimation 确定活跃区间,并利用 Frequency Confusion Transfer 从语料频谱变化中构造具有连续相位的低频波形。为缓解该风险,本文提出 Distributional Requery Guard(DRG),用于检测低频分布偏移,并有条件地请求二次录音以恢复语义。 在 6 个 LALMs 和多项音频理解任务上,ILL 使准确率最高下降 67 个百分点,同时平均人类可听性评分仅为 1.33,接近干净音频的 1.17。DRG 在重新获取干净音频后,将平均受攻击准确率从 28.5% 提升至 46.1%。这些发现揭示了 LALMs 此前被忽视的安全风险,并为鲁棒音频理解的未来研究奠定了基础。
论文精读
TL;DR 提出人耳听不见的低频攻击 ILL,可让六种音频语言模型准确率暴跌 67 个百分点,并配套防御 DRG 通过重查询恢复语义,揭示此前被忽视的低频安全风险。
问题
问题背景
大型音频语言模型(LALM)在语音助手、多媒体内容理解与交互式 AI 中快速落地,其安全性评估正成为部署前不可或缺的环节。不同于传统语音识别,LALM 直接生成语义响应,攻击面更广。
现有方法局限
已有的音频对抗攻击主要面临三点不足:
- 可听性限制:多数方法注入的扰动落在人耳敏感频段,容易被察觉,降低攻击隐蔽性。
- 白盒假设:常见方案需要模型梯度或架构信息,而在实际黑盒服务场景中不可行。
- 任务侧重单一:研究多针对 ASR 的转录错误,对 LALM 的开放域问答、推理等生成任务缺乏有效评估。
针对低频率不可听区域注入方式的研究几乎空白,更缺少黑盒条件下可复用的波形模板与防御机制。
为什么这个问题难/重要
低频信号的物理特性使其天然穿透人耳感知,却仍能被麦克风与模型特征提取捕获。然而,黑盒场景下无法获取梯度,攻击者必须从语料统计或频率分布中构造扰动,且要保证跨样本、跨任务的通用性。此外,LALM 生成语义的微小偏移难以用简单指标检测,传统滤波或对抗训练对低频分布偏移不敏感。
业界对多模态模型的安全性愈发重视,攻击者可利用此类不可听注入绕过内容审核或干扰语音交互决策,风险等级不亚于视觉对抗样本。
行业类比
类似视觉语言模型中的对抗补丁(adversarial patch),低频注入可视为音频域的“隐身扰动”——在不影响人类感知的前提下操纵模型输出。
核心洞察
- 低频不可听信号构成新型黑盒通用攻击面。传统音频对抗样本常依赖可听扰动或白盒梯度,而 ILL 利用人耳听觉阈值以下的低频波形,以通用模板在黑盒条件下实施攻击。这种攻击无需针对单个样本迭代优化,信号完全不可听,大幅降低攻击门槛与暴露风险,揭示 LALM 对低频成分的过度敏感可能成为通用漏洞。
- 防御策略从“滤除噪声”转向“分布检测+重采样恢复”。DRG 不直接消除低频扰动,而是检测输入的低频分布偏移,并条件性请求二次录音以恢复语义。相比对抗训练或输入净化,该方法更贴近物理世界部署:当环境或传输引入不可预测的低频干扰时,模型可主动交互重查询提升可靠性,为音频理解安全提供轻量、实用的新范式。
方法
输入与威胁模型
攻击方仅通过黑盒查询访问 LALM,输入为目标音频样本与对应的任务提示;不依赖模型梯度或架构细节,使用一个通用的波形模板(universal waveform template)作用于不同样本。
关键模块
- Sentence Attention Scale Estimation(SASE) 用于定位音频中对语义贡献最大的时间区间(active intervals)。它通过估计模型对句子的注意力或响应强度,筛选出需要注入干扰的片段,实现间歇式触发而非全段扰动。
- Frequency Confusion Transfer(FCT) 从语料库频谱变化中提取连续相位信息,构造低频波形。该波形落在人类听觉阈值以下但可被麦克风与模型接收,并保持相位连续以增强注入后的自然度与鲁棒性。
- 将低频模板按 active intervals 注入原始音频,生成对抗样本;输出使 LALM 在音频理解任务上产生错误语义。
针对此风险,Distributional Requery Guard(DRG) 作为防御侧,通过检测输入的低频分布偏移,条件触发重新采集第二段录音,用于恢复干净语义。
方法差异点
与常见高频或全段对抗扰动不同,ILL 结合注意力估计与不可听低频的间歇注入,在黑盒条件下用通用模板实现高隐蔽性攻击;DRG 则从分布偏移与重采集角度缓解,而非滤波或对抗训练。
实验
实验设计
研究在六个 LALM 和多个音频理解任务上评估 ILL 攻击与 DRG 防御。攻击采用黑盒设置,使用通用波形模板,通过 Sentence Attention Scale Estimation 确定活动区间,Frequency Confusion Transfer 构建连续相位低频波形。防御端 DRG 检测低频分布偏移,并在必要时请求二次录音以恢复语义。
关键发现
- ILL 最高使准确率下降 67 个百分点,平均可将模型准确率压至 28.5%。
- 人耳可听度评分为 1.33,接近干净音频的 1.17,说明攻击几乎不可感知。
- 应用 DRG 后,平均攻击后准确率从 28.5% 回升至 46.1%,但仍低于原始性能,存在残余风险。
- 对实际工程的启示:现有 LALM 对低频扰动缺乏鲁棒性,部署时需增加输入分布监测层,而 DRG 的重录机制在用户配合下能缓解部分攻击,但无法彻底消除。
与基线对比
相比常见白盒或样本特定攻击,ILL 的通用波形模板在黑盒条件下即可生效,且具备跨模型迁移潜力。DRG 无需重新训练模型,以检测和重录的轻量方式介入,在保持模型参数不变的前提下恢复近半数被攻击样本的准确率。这种防御思路更贴近实际产品迭代,但准确率未完全恢复也说明低频扰动会改变深层语义表征,后续需探索更强的输入净化或对抗训练。
行业影响
落地场景
LALM 已用于语音助手、智能客服、音频内容审核、远程医疗听诊、工业声学监测等。本论文揭示的低频不可听攻击可使模型准确率最多下降 67 个百分点,且人耳几乎无感(audibility rating 1.33 vs 干净音频 1.17)。高可靠场景如金融声纹验证、自动驾驶环境感知尤其需要部署防御。
商业价值
- 降本:DRG 通过检测低频分布偏移并请求二次录音,将被攻击后的准确率从 28.5% 恢复到 46.1%,减少错误决策导致的人工复核与客服资源消耗。
- 增收/体验:自动重录机制避免用户无感知的失败交互,提升服务可用性与用户信任,降低因音频对抗攻击引发的品牌损失。
- 安全合规:提供对音频侧对抗攻击的检测能力,满足安全审计与鲁棒性要求。
与现有 stack 的接口
DRG 可作为音频输入预处理守护模块,部署在 LALM 推理流水线前端或 API 网关。集成步骤:
- 对输入音频计算低频能量分布特征,与干净语料拟合的分布模型比对;
- 若检测到低频分布偏移,触发重录请求或告警;
- 实时性要求高的场景可部署在边缘设备,离线拟合分布参数,推理开销低(论文附录 B 给出复杂度分析)。 无需重新训练 LALM,可兼容现有音频前端。
具体用例
- 智能语音客服:攻击者播放不可听低频干扰,使客服机器人误解用户请求或执行错误操作;DRG 检测后请求用户重复,保障对话成功率。
- 远程医疗听诊:患者端环境存在低频机械振动(如空调、交通),干扰心肺音分析模型;DRG 触发二次录音或提示调整环境,降低误诊风险。
局限
- 论文在数字域验证了攻击与防御,但未在真实声学传播链路上进行端到端物理实验。附录仅给出低频波形经扬声器、空气、麦克风的理论可行性分析,实际硬件非线性、麦克风频率响应不平坦、环境噪声等因素可能严重衰减或扭曲低频成分,导致攻击成功率显著降低。此外,攻击效果依赖特定波形模板,在不同录音设备或距离下的鲁棒性未有实证支撑。
- DRG 防御依赖对低频能量分布偏移的统计检测,对自适应攻击者而言,可针对性调整波形使扰动分布贴近正常音频,或迁移到其他不可听频段实现绕过。二次录音机制引入了额外交互延迟和用户负担,在实时语音助手、会议转录等低延迟场景中部署成本较高。DRG 仅在六种 LALM 上验证,其在不同架构、不同预训练策略模型上的泛化能力仍待考察。
- 与已有的针对 ASR 或音频分类的对抗样本攻击相比,本文方法侧重 LALM 的多模态理解任务,但在攻击优化效率、跨任务迁移性和黑盒查询次数上没有表现出对现有基于遗传算法或梯度估计方法的显著优势。实验主要使用固定提示模板和多项选择题评测,对开放式生成任务、复杂推理场景下的攻击效果缺乏充分评估,限制了其在真实对话系统中的威胁评估代表性。