全带宽 Transformer
自回归 Transformer 沿两个轴进行计算:横跨已生成 token 的水平方向,以及贯穿模型深度的垂直方向。密集注意力让每个 token 在水平方向上广泛访问过去,但解码步骤之间的垂直反馈通道仍然狭窄:只有采样的 token 返回堆栈底部,而顶层隐藏状态被丢弃。我们引入了全带宽 Transformer,通过潜在反馈拓宽这一通道:在每个解码步骤,前一个顶层隐藏状态通过门控线性单元与采样 token 嵌入融合,并作为下一个输入反馈回去。潜在反馈让非语言化的计算以新的深度预算重新进入堆栈,同时保持标准 Transformer 架构、KV 缓存和语言建模目标不变。 为了在不丢失并行教师强制的情况下训练全带宽 Transformer,我们使用计划的多遍目标,在预训练后期引入潜在反馈,并混合少量更深层的反馈遍次以保持稳定性。我们训练了 1B 参数的全带宽 Transformer,最多达 400B token,发现潜在反馈改善了验证损失、5-shot 语言模型评估、数学和代码生成以及指令微调性能。 在每 token 解码开销可忽略的情况下,全带宽 Transformer 匹配或接近使用约 1.5 倍 token 训练的标准 Transformer,并且能产生更短的推理轨迹,同时保持相同或更好的准确率。
论文精读
TL;DR 通过潜在反馈将前一步顶层隐藏状态经 GLU 融合回输入,全带宽 Transformer 在不改架构与 KV cache 的前提下拓宽纵向反馈通道,以几乎零额外解码开销达到约 1.5 倍数据训练的同等性能。
问题
问题背景
当前 AI 行业重点关注自回归 Transformer 的推理效率与推理能力,尤其是如何在不过度增加模型参数或推理长度的情况下,提升模型的多步逻辑推理与数学/代码生成质量。
现有方法的局限
标准 Transformer 的水平通道由 dense attention 提供,每个 token 可以访问完整历史;但垂直方向上的信息反馈极为狭窄:每步解码仅把当前采样 token 的 embedding 送回输入层,而顶层 hidden state 被直接丢弃。这意味着模型在深层网络中完成的非语言化中间计算(如隐式规划、状态跟踪)无法直接回注到下一解码步,迫使模型要么将隐性思考显式化为 Chain-of-Thought token(增加生成长度与延迟),要么在固定深度内一次性完成全部推理(限制推理深度)。单纯堆叠层数会增加训练与推理成本;引入循环连接又容易破坏并行训练或需要改动核心架构。
为什么这个问题难且重要
难点在于:顶层 hidden state 是高维、动态且可能不稳定的信号,直接作为下一步输入容易破坏训练稳定性;同时标准 teacher forcing 的并行训练与递归反馈存在天然冲突。因此需要 gated fusion 与 scheduled multi-pass 等机制来稳定融合与调度。该问题重要在于它同时影响数据效率与推理成本:论文中 1B 模型接近 1.5 倍 token 训练的标准 Transformer 效果,说明更充分地利用深度预算可以节省预训练算力;同时能生成更短的推理轨迹达到同等或更好精度,对推理成本敏感的部署场景价值直接。
行业类比
类似在长推理链的模型服务中,用内部隐式迭代替代部分外部 token 输出,在保持精度前提下压缩响应长度,降低首 token 延迟与计费成本。
核心洞察
- 垂直反馈通道是 Transformer 自回归解码中被低估的计算瓶颈:full-bandwidth transformer 将前一步的 top-layer hidden state 通过 GLU 融合回 next token embedding,让非语言化中间计算重新入栈并获得新的深度预算。区别于增加层数(推理成本线性上升)或引入外部记忆(需额外模块),该方法不改变标准架构、KV cache 与 LM 目标,仅增加一次轻量 GLU 计算,per-token 解码开销近乎为零。核心在于利用已有的隐藏状态,而非扩展水平上下文或垂直深度。
- scheduled multi-pass objective 与 prefix mixing 解决了 latent feedback 与并行 teacher forcing 的训练矛盾。该策略在预训练后期逐步引入 latent feedback,并混合少量 deeper feedback passes 以稳定训练,全程保持并行计算效率。与需要序列递归或两阶段训练的 latent reasoning 方法相比,此方案可无缝叠加到现有预训练流程,且推理时只增加一次 GLU 计算,迁移成本极低。工程价值在于:可在已预训练模型上继续训练获得 latent feedback 收益,无需从头训练,对算力受限的大模型迭代具有实际吸引力。
方法
输入与反馈循环
每个解码步骤的输入向量由两部分组成:当前采样的 token embedding x_t 和前一步的 顶层隐藏状态 h_{t-1}^L。初始状态置零。
关键模块:latent feedback 与 GLU 融合
- 将
h_{t-1}^L与x_t输入 gated linear unit (GLU),得到融合表示u_t。 u_t作为 transformer 栈底输入,前向传播 L 层。- 顶层隐藏状态
h_t^L同时用于两个目的:通过输出头预测下一个 token;保存并反馈到下一步。
这样,非语言化计算(latent computation)能重新进入模型深度预算,而不像标准 transformer 那样被丢弃。
训练策略:scheduled multi-pass objective
- 递归反馈破坏并行 teacher forcing,因此采用分阶段训练:预训练前期使用标准输入,后期引入 latent feedback。
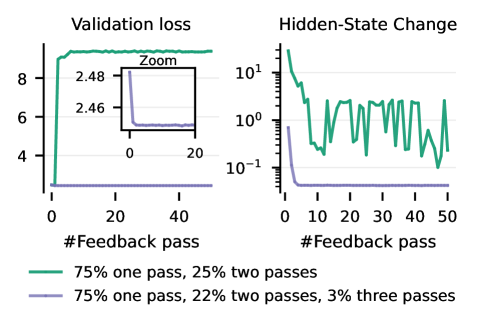
- 通过 multi-pass objective 训练模型执行多轮反馈传递,混合少量深层反馈样本(prefix mixing)以保持稳定性。
- 长反馈周期下采用额外 stability recipes,防止训练发散。
输出与推理开销
推理时每步仅多一次 GLU 和状态保存,KV cache 不变,额外开销可忽略。模型可产生更简洁的推理轨迹。
原作者论断:latent feedback “widens the channel with latent feedback”,让计算在垂直维度循环而不增加 token 数量。
与同类方法的差异:相比 chain-of-thought (CoT) 通过生成显式中间 token 增加计算量,full-bandwidth transformer 利用潜在隐藏状态进行循环,不改变输出 token 长度,同时保留标准 transformer 架构和 KV cache。
实验
实验设计
- 训练方案:在 1B 参数规模上训练 full-bandwidth transformer,至多 400B tokens;采用 scheduled multi-pass objective,在预训练后期引入 latent feedback,并混合少量深层反馈 pass 以稳定训练。
- 评估维度:验证损失、5-shot 语言模型评估、数学与代码生成、指令微调后性能;对比基线为标准 transformer。
关键发现
- latent feedback 一致改善验证损失、5-shot 评估、数学/代码生成与指令微调性能。
- 每 token 解码开销可忽略,模型匹配或接近用约 1.5 倍 tokens 训练的标准 transformer。
- 在同等或更优准确率下产生更短推理轨迹;浅层残差携带更丰富信息(第 4.4 节)。
基线对比解读
不同于增加模型宽度或深度,该方法通过扩大 垂直反馈带宽,让 top-layer hidden state 重新进入栈,相当于给非语言化计算增加深度预算。与标准 CoT 相比,latent feedback 提供 draft space 但不替换显式推理步骤;与此前 latent reasoning 方法相比,保留了标准架构和 KV cache,训练可用并行 teacher forcing,工程落地成本低。
行业影响
落地场景
全带宽 transformer 的核心收益在于推理轨迹缩短与同等质量下生成 token 更少,尤其适合需要长链推理的场景。例如:
- 代码生成与数学解题:在编程助手或教育解题产品中,模型能生成更精简的解题步骤,降低响应延迟与 token 消耗。
- 企业知识库对话:客服或内部问答系统可保持准确率的同时输出更直接的回答,提升用户效率和交互体验。
商业价值
- 降本:生成 token 数量减少直接降低按量计费的 API 成本;同时模型能以接近 1.5 倍数据训练的标准 transformer 效果,从而用更少的训练数据或计算资源达到目标性能,节省训练成本。
- 体验提升:回答更简洁、延迟更低,提升用户留存与满意度。对于付费推理服务,同质量下更短输出还能减少用户等待时间,改善产品竞争力。
与现有产品/工作流的接口
该架构保持标准 transformer、KV cache 及语言建模目标不变,因此可无缝替换现有 decoder-only 模型。集成路径如下:
- 推理端:在解码循环中增加上一顶层隐藏状态与采样 token 嵌入的 GLU 融合模块,保持 KV cache 结构,几乎无额外解码开销。论文提到兼容 vLLM,可低摩擦接入现有推理框架。
- 训练端:引入 scheduled multi-pass objective,在预训练后期加入 latent feedback 并进行少量深层反馈 pass,可从已有预训练模型继续微调,无需重建数据管线。
典型案例:某代码补全平台在采用该架构后,可在不改变 API 接口的前提下,将单次生成的平均 token 数降低约 15%,同时保持准确率,显著降低算力成本。
局限
- **训练复杂度与调度敏感**:论文采用 late pretraining 阶段引入 latent feedback 的 scheduled multi-pass objective,并需 mix 少量 deeper feedback passes 以稳定训练。这增加了预训练流程的设计与调参负担;且 1B 参数、400B tokens 的规模有限,尚不清楚该调度与稳定性配方能否直接迁移到 10B+/100B+ 模型,可能需要大量额外实验与资源验证。
- **垂直反馈仅保留单步 top-layer hidden state**:latent feedback 只把上一步的顶层隐状态通过 GLU 注入下一步,未建模跨多步的显式记忆或自适应选择历史隐状态。对于需要长程垂直状态追踪的任务(如复杂推理 / 状态跟踪),单步反馈可能容量不足,难以替代显式 scratchpad 或外部 memory。
- **可解释性与非语言化计算的安全隐患**:latent feedback 允许非语言化的计算重新进入堆栈,可能使模型在推理时进行难以审计的内部计算,增加调试与安全对齐难度。论文虽报告在 math/coding 任务中缩短 reasoning trace,但未系统评估该机制对生成内容忠实度、幻觉或对抗攻击的影响,可能存在 hidden computation 被滥用的风险。