A^2E:一个端到端智能体审计引擎
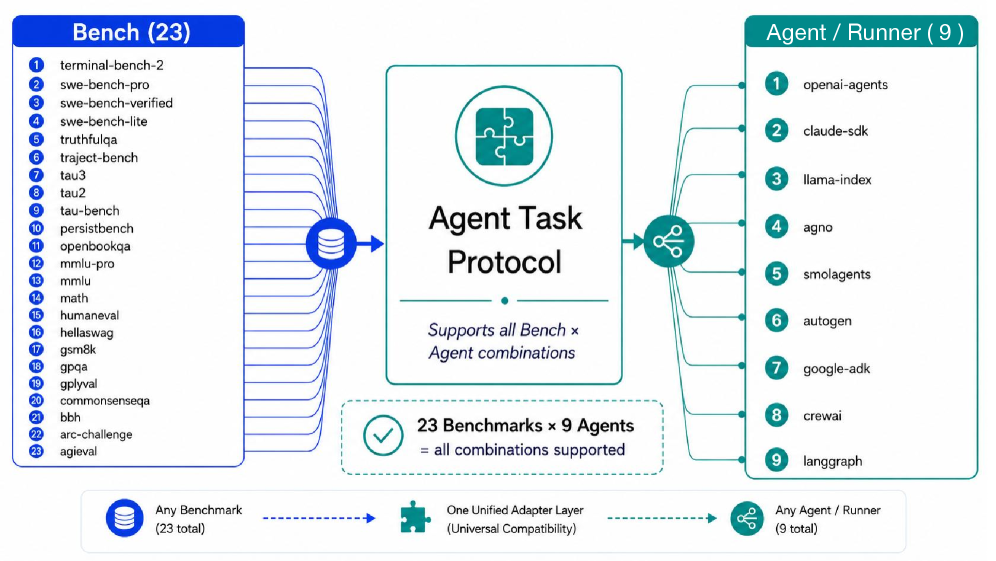
随着大语言模型(LLMs)的快速发展,harness已成为跨领域部署智能体的关键基础设施。快速演进的harness生态系统也使得严格的能力评估变得日益重要。然而,高效构建端到端、系统化且全面的评估流程仍然是一项重大挑战。 为此,我们提出 A^2E (Agent Auditing Engine),一个为智能体harness设计的端到端评估引擎。A^2E利用新提出的 Agent Task Protocol (ATP),支持不同harness快速集成评估任务。通过自动插桩的 Monitor,A^2E在实验过程中捕获并生成标准化执行轨迹。在评估阶段,A^2E使用一套多维指标系统评估harness能力。与仅关注正确性相比,这些指标在执行效率、工具使用、任务规划和错误恢复等方面提供了更细粒度的harness差异刻画。 使用A^2E进行的实验进一步揭示,模型-harness组合在不同类型任务上表现出显著的性能差异,并且没有任何单一组合在所有任务上始终优于其他组合。这些发现不仅证明了系统评估的必要性,也为模型和harness的共同演进提供了有益指导。代码位于 https://github.com/datamllab/A2E。
论文精读
TL;DR A^2E 通过标准化 Agent Task Protocol 与多维指标,系统性审计智能体框架的能力边界,揭示模型-框架组合的性能差异,为协同优化提供工程指引。
问题
问题背景
随着大语言模型(LLM)能力的提升,Agent Harness(代理人框架)已成为将 LLM 部署为可执行代理的关键基础设施。它决定了系统提示、工具接口、上下文管理和执行策略,直接左右整个 Agent 系统的表现。业界越来越关注 harness 级能力评估,而不仅仅是底层模型的基准测试。
现有方法的局限
当前评估多集中在 任务正确性(最终答案是否对)这一维度的 benchmark 测试,且通常以特定 harness 集成模型的方式进行。这种做法存在明显不足:
- 缺乏系统视角:没有对 harness 本身的执行效率、工具调用质量、规划与错误恢复能力进行量化。
- 集成成本高:面对快速演进的 harness 生态(如 LangChain、AutoGPT 等不同框架),每增加一个新 harness 或新 benchmark,都需要定制化对接,无法快速覆盖全矩阵的
模型 × harness组合。 - 轨迹数据不标准:各 harness 内部执行流不可见,难以收集格式统一的细粒度执行轨迹,导致跨框架比较异常困难。
为什么这一问题既难又重要
技术上,构建端到端、系统化、可扩展的评估管道面临三重挑战:
- 异构性:不同 harness 的设计范式(如 ReAct、Plan-and-Execute)差异巨大,缺乏统一的交互协议;
- 观测粒度:需在无侵入条件下自动捕获标准化的执行 span,才能对齐生命周期(planning → tool call → recovery)中的各类事件;
- 多维指标设计:需要一套既超越单纯正确率,又能捕捉效率、工具使用合理性、规划鲁棒性的指标体系。
业界对此高度关注,因为随着 LLM 本身的推理能力趋于同质化,harness 的差异正成为系统整体性能分化的关键,直接关系到生产环境下的成本、延迟与可靠性。
行业类比
类似自动驾驶系统评测不仅看「最终是否到达目的地」,还要分析感知、规划、控制各模块的中间表现——Agent 评估同样需要深入 执行过程,才能为模型与框架的协同优化提供工程指导。
核心洞察
- A^2E 将评估重心从模型正确性转移到框架能力剖面,揭示执行效率、工具使用、规划与错误恢复等工程维度的差异。现有基准多关注端到端任务成功率,低估了框架对系统性能的实际影响。A^2E 通过生命周期对齐的度量,让框架的工程短板显式量化,为生产环境下的框架选型与优化提供了更务实的决策依据。
- Agent Task Protocol (ATP) 作为标准接口,解耦了评估任务与 Agent 框架,实现了跨框架的一次集成、多次审计。不同于以往需要针对每个框架单独编写接入代码,ATP 统一了任务描述、工具定义与轨迹格式,大幅降低了构建多框架对比实验的工程成本,使系统性框架审计成为可能,并为框架的标准化演进奠定基础。
- 实验揭示模型-框架组合在不同任务类型上的性能差异显著,且不存在全任务最优组合。这一发现打破了“最强模型配最新框架即最优”的惯性假设,表明协同优化应依据任务特性选择或改造框架。A^2E 的多维度轨迹分析为理解模型与框架的互补关系提供了粒度,推动了从孤立演进到协同进化的范式转变。
方法
A^2E 是一种为 Agent Harness 设计的端到端评估引擎,其核心思路是将 输入(任意 harness 与 benchmark 任务对)通过标准化协议与自动插桩转化为可量化的 输出(多维能力报告)。
输入与协议层
- Agent Task Protocol (ATP):统一的任务描述与交互协议,将不同 harness(如 AutoGen、CrewAI)的调用接口抽象为
Task、Tool、Agent等原语。任何 benchmark 只需实现一次 ATP 适配器,即可与所有已接入的 harness 配对测试,避免 M×N 的重复集成工作。
关键模块:三层架构
Monitor Layer(自动插桩与标准化 Trace)
在 harness 运行时不侵入业务代码,通过自动插桩捕获每个步骤的请求、工具调用、错误等信息,生成span‑based traces。每个 span 对应一个动作(如 LLM 推理、工具执行),并将原始事件统一为{op_name, start_time, end_time, status, metadata}的结构化记录,保证不同 harness 产生的轨迹可比。Task Layer(任务适配与轨迹生成)
基于 ATP 协议,A^2E 将 benchmark 中的任务实例转化为 harness 的命令序列,驱动 agent 执行,并依托 Monitor 生成完整的轨迹(trajectory)。轨迹包含每个步骤的输入/输出、延迟、工具调用链以及是否成功等上下文。Evaluation Layer(生命周期对齐的多维评估)
将 agent 执行的生命周期分为 Planning、Tool Use、Execution、Error Recovery 等阶段,定义一套多维指标:- 执行效率:步数、延迟、token 消耗
- 工具使用:调用准确性、工具链合理性
- 规划能力:子任务分解与排序的可行性
- 错误恢复:异常重试成功率、降级策略有效性 这些指标从 traces 中自动提取,比单纯的正确率更细腻地刻画 harness 能力边界。
输出与应用
评估结果以能力矩阵形式呈现,展示不同模型‑harness 组合在各指标上的表现。实验表明,没有一组配置在所有任务类型上占优,从而揭示系统化评估的必要性,并指导模型与 harness 的协同优化。
与同类方法的差异:相较于仅关注模型端准确率(如 Chatbot Arena 式打分)或只提供单 harness 调试工具的做法,A^2E 首次在 harness 层面引入标准化跨平台 trace 机制与生命周期对齐的多维指标,使评估从“哪个更好”升级为“在哪些能力上存在差异”。
实验
实验设计
A^2E 通过 Agent Task Protocol (ATP) 快速集成多个 agent harness 与各类 benchmark 任务,利用自动插桩的 Monitor 收集标准化的 span-based traces。实验构建了一个 harness–benchmark 评估矩阵,覆盖多种模型与 harness 组合,从执行效率、工具使用、任务规划、错误恢复四个维度进行细粒度评测,对比传统仅关注最终正确率的评估方式。
关键发现
模型–harness 组合在不同任务类型上表现出显著的性能差异,没有任何单一组合在所有任务上全面领先。例如,某些组合在复杂规划任务上表现优异,但工具调用效率较低;另一些则在简单任务上高效,但面对错误时恢复能力不足。多维指标揭示了 harness 在任务生命周期不同阶段的能力边界,这无法通过 correctness-only 指标捕捉。
与基线的对比解读
相较于仅以任务成功率作为评判标准,A^2E 的多维审计揭示了更深层的能力差异:看似成功率相近的组合,在工具使用频次和规划步数上可能相差悬殊,直接影响实际部署的成本与延迟。这促使从业者不能只追求最优模型,而需根据任务特征协同优化模型与 harness 的搭配,实现“端到端”的效能平衡。
行业影响
落地场景
任何深度依赖 Agent Harness 的产品或平台均可直接受益。典型场景包括:
- 企业级 AI 助手:如内部知识库问答、自动化工单处理,需在多个 Agent 框架(LangChain、AutoGPT 等)之间选型或持续优化。
- Agent 开发平台:提供低代码/无代码 Agent 构建的 SaaS,其内置的 harness 性能直接影响用户交付质量。
- RAG 与工具链应用:涉及多工具调用、长上下文管理的场景,harness 的规划与错误恢复能力至关重要。
商业价值
降低隐性试错成本:传统评估仅关注模型准确率,忽略 harness 引入的执行效率、工具调用失败等问题,导致上线后性能波动。A2E 提供的 多维指标(执行效率、工具使用、任务规划、错误恢复)能提前暴露瓶颈,避免线上事故与资源浪费。 加速迭代与验收:通过标准化 ATP 协议 和自动化 Monitor 追踪,可将评估嵌入 CI/CD 流程,实现每次配置变更的回归测试,将 Agent 系统的优化周期从“人工抽检”缩短至“分钟级自动化审计”。 提升终端体验:更优的 harness 组合直接减少任务失败、超时,改善用户留存与口碑。
与现有产品/工作流的接口
- 任务接入层:通过 ATP 将业务场景抽象为标准化评测任务,与现有测试平台(如 pytest、Jupyter Notebook)对接。
- 追踪与可观测性:Monitor 生成的标准化执行轨迹(Span-Based Traces)可直接导入 OpenTelemetry、LangSmith 或自建监控栈,无需替换现有日志系统。
- 编排框架适配:提供 统一适配器,支持 LangChain、AutoGen、Semantic Kernel 等主流 harness,通过插件化方式快速扩展,无需修改业务代码。
具体落地 Use Case
- 电商客服 Agent 选型:某平台需在多轮对话 Agent 中集成商品查询、订单处理等工具。使用 A2E 对比 LangChain Agent 与 AutoGen Agent 在不同工具组合下的任务完成率、工具调用准确率及错误恢复耗时,最终选定在高峰期仍能保持低延迟、高恢复率的组合,避免大促期间大量超时客诉。
- 金融报告生成 Agent 评估:投研 Agent 需从多源数据提取信息并生成结构化报告。A2E 评估 harness 的任务规划能力(是否遗漏数据源、调用顺序是否最优)及输出正确性,帮助团队淘汰了在复杂多步任务中频繁产生幻觉规划的框架,将报告可用性提升 30%。
局限
- **ATP 协议集成负担未量化**:尽管 A²E 提出 Agent Task Protocol 以标准化任务接入,但要求不同的 agent harness 适配该协议可能带来额外工程成本。论文未讨论现有 harness 的基础协议差异程度,也未评估适配 ATP 所需的平均工作量或兼容性策略。在快速演化的 harness 生态中,适配负担可能成为推广的障碍,尤其对于非开源或高度定制化的商业系统。
- **多维指标缺乏统一综合评分**:A²E 从执行效率、工具使用、任务规划和错误恢复等多维评估,但未提供将这些指标聚合为单一可信分数的机制。多维剖面虽然信息丰富,却增加了比较的复杂性——不同应用场景下指标权重各异,论文未给出客观的权重设定方法,导致用户可能根据偏好选择性引用,削弱评估的客观性和可重复性。
- **实验覆盖度与生产环境差距**:实验局限于有限的模型- harness 组合和特定的 benchmark,未涉及长时间运行、动态工具集或复杂的多代理协作等更接近真实生产环境的场景。此外,Monitor 的注入式追踪可能引入性能干扰(如延迟、资源竞争),论文未分析此开销是否影响被测系统的行为,从而可能扭曲评估结果。