360CityArena: 面向具身智能体的真实虚拟城市导航基准
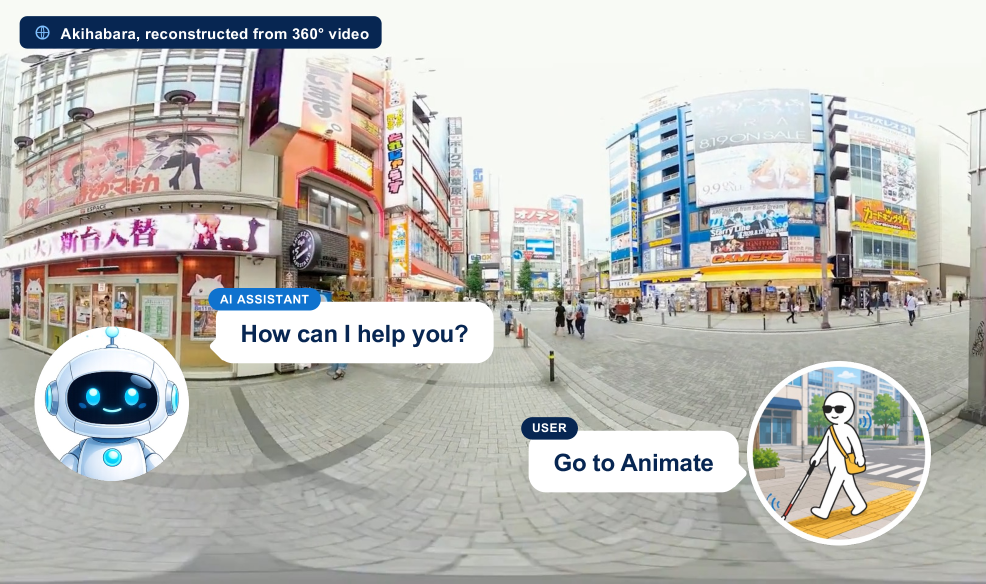
我们提出 360CityArena,一个用于评估具身智能体在由 360 度视频构建的逼真环境中城市探索能力的基准。现有户外基准要么缺乏足够的照片级真实感,要么复杂度不足,与真实城市环境存在较大差距。 360CityArena 基于日本东京秋叶原地区的真实重建,使用 602 段 360 度视频覆盖 85 条街道,并包含 175 个精心人工设计的任务。它涵盖三类任务:环境理解、路径推理 和 空间推理,覆盖城市探索所需的基本能力,如定位、地标搜索、路径规划和关系空间推理,从而能够在真实城市场景中进行全面评估。 我们使用最先进的基于 LMM 的智能体进行评估,结果表明即使最强的模型 Gemini 2.5 Flash 也远低于人类水平(人类为 77.3%,而 Gemini 2.5 Flash 仅为 17.1%),这揭示了城市规模具身导航和推理中仍然存在的巨大挑战。360CityArena 为逼真的城区导航和空间推理提供了一个必要且具有挑战性的测试平台。
论文精读
TL;DR 360CityArena 用 360° 视频真实重建东京秋叶原街区,构建含 175 个任务的具身导航基准;当前最强 LMM 智能体仅得 17.1%,远低于人类 77.3%,凸显城市级导航推理的巨大挑战。
问题
问题背景
具身智能体在城市街区探索与导航(embodied urban exploration)正成为 LMM 时代的研究热点,目标是将视觉感知、空间推理与行动决策集成到统一模型中,完成寻路、定位、地标搜索等真实任务。
现有方法局限
当前户外导航基准通常依赖合成渲染或低分辨率街景,缺乏真实城市中的光照变化、遮挡和语义细节;任务设置偏向室内短程或单一目标,无法覆盖城市尺度的关系推理与长期路径规划。常见 VLN 数据集局限于室内环境或简化街道,不足以评估 LMM-based agents 在真实街区中的泛化能力,且多数基准未提供高保真 360° 视频重建环境和人工标注的多类别任务,导致与真实部署存在显著 gap。
为什么这个问题难/重要
城市环境高度复杂:动态物体、视觉重复地标、长距离依赖和指路歧义都要求 agent 具备鲁棒空间记忆与常识推理。论文中的 360CityArena 基于东京秋叶原的真实重建,用 602 段 360° 视频覆盖 85 条街道,设计 175 个人工标注任务,涵盖环境理解、路径推理和空间推理。实验显示最强 LMM Gemini 2.5 Flash 仅达到 17.1% 成功率,而人类为 77.3%,说明现有模型在 city-scale embodied navigation 上仍有巨大差距。该基准为照片真实城市导航评估提供了关键 testbed。
行业类比
正如自动驾驶领域从纯合成仿真(如 CARLA)转向真实数据重建以缩小 sim-to-real gap,具身导航同样需要高保真城市级虚拟环境作为可靠测试平台。
核心洞察
- 360CityArena 用 360° 视频重建真实城市街区,在保持照片级真实感的同时提供可导航的交互环境,弥补了现有户外基准在视觉保真度和任务复杂度上的不足。与依赖合成渲染或简化地图的基准相比,其基于秋叶原 602 段视频的真实重建让 agent 必须处理动态光照、遮挡、街景噪声等真实世界变量,从而更贴近实际部署。工程师可借此测试模型在未见过区域中的泛化能力,避免实验室数据与现场表现之间的严重偏差。
- 该基准将任务划分为环境理解、路径推理和空间推理三类,显式解耦了具身导航所需的不同认知子能力。现有工作常将导航简化为单一路径执行,而 360CityArena 要求 localization、landmark search、path planning、relational spatial reasoning 等独立评估,能精确定位 LMM 在哪些环节失效。作者发现最强模型 Gemini 2.5 Flash 仅达 17.1%,人类为 77.3%,说明当前视觉语言模型在真实尺度空间推理上存在根本性短板,而非简单缺少训练数据,为后续架构设计提供了明确优化方向。
方法
输入与任务定义
360CityArena 的输入包含两部分:一是基于 602 段 360° 视频重建的秋叶原街区虚拟环境,覆盖 85 条街道;二是 175 个人工构建的任务,每个任务以自然语言指令或图像查询等形式给出,要求 agent 在环境中探索并做出回答。任务分为三大类:Environment Understanding(定位、地标搜索)、Path Reasoning(地图导航、视觉语言导航)和 Spatial Reasoning(物体计数、关系空间推理)。
关键模块
- 环境构建:通过 360° 视频序列拼接与配准,生成可自由移动、旋转视角的 photorealistic 虚拟街道场景;每条街道由多个视频片段覆盖,agent 可以在离散节点间跳跃或平滑移动。
- 任务生成:由人工标注者根据环境真实地标、路径和空间关系设计任务,确保难度贴近真实城市探索需求,并排除歧义。例如,定位任务要求 agent 根据地标外观推断自身位置;地图导航要求给定起点和终点规划路径并描述关键转向;空间推理则需要计数或判断相对方向。
- 评估协议:采用 LMM-based agents(如 GPT-4o、Gemini 2.5 Flash 等)作为基线,agent 接收视觉观测和指令,可以调用地图查询或反思模块,最终输出答案。评估使用 模糊匹配 对文本答案进行打分,并记录任务成功率。
输出与指标
输出为每个任务的二进制成功/失败,以及整体成功率。基准测试同时收集人类受试者的表现(77.3%)作为上界参考,当前最强模型 Gemini 2.5 Flash 仅达到 17.1%,揭示了城市尺度具身导航在真实视觉与空间推理上的显著差距。
与同类方法的差异点
相较于现有户外导航基准(如基于简单 3D 模型或街景快照),360CityArena 提供了高保真、连续可探索的 360° 视频重建环境,并将任务类型拓展到关系推理和路径规划的综合评测,更贴近真实世界城市探索需求。
实验
实验设计
360CityArena 构建了一个基于东京秋叶原地区的真实感虚拟环境,使用 602 个 360° 视频段覆盖 85 条街道,共包含 175 个人工标注任务。评估协议以 LMM-based agent 为核心,采用零样本设置,在 环境理解、路径推理和空间推理三个类别下测试定位、地标搜索、路径规划与关系推理等能力。基准使用模糊匹配评测方法衡量 agent 输出与真实答案的一致性。
原文引用:human: 77.3% vs. Gemini 2.5 Flash: 17.1%
关键发现
实验结果显示,当前最强的 LMM-based agent(Gemini 2.5 Flash)在整体准确率上仅为 17.1%,远低于人类水平 77.3%。误差分析表明,模型在需要多步空间推理和路径规划的复杂任务上表现尤其薄弱,暴露出 LMM 在城市场景中缺乏稳定的空间状态表征和长期规划能力的问题。
对比解读
相较于早期户外导航基准,360CityArena 通过真实 360° 重建和细粒度任务设计,显著提高了任务的真实感与复杂度,使现有模型与人类之间的差距被清晰量化。这一结果说明仅靠扩大模型规模或增加预训练数据难以解决城市级具身导航的根本问题,工程上需要引入更强的空间记忆模块、显式地图表示或专门的规划器。360CityArena 因此为后续研究提供了一个具有挑战性的评测平台。
行业影响
落地场景
- 具身智能与机器人导航:360CityArena 提供的逼真城市环境可用于训练和评测室内外机器人、自动驾驶车辆在复杂街区中的定位、地标搜索和路径规划能力。
- 数字孪生与城市仿真:基于 360° 视频的低成本重建方法可快速构建高拟真城市模型,用于城市管理、应急演练和智能交通系统验证。
- 增强现实与视觉定位:任务中的 landmark search 和 localization 直接对应 AR 导览、基于视觉的定位服务(VPS),可加速相关算法迭代。
商业价值
- 降低研发成本:相比激光雷达扫描或手工建模,360° 视频重建大幅削减高真实感城市环境的构建费用,使中小团队也能进行大规模具身智能测试。
- 加速产品迭代:作为标准化 benchmark,企业可快速评估 LMM-based 代理的导航推理能力,缩短从研究到落地的周期。
- 提升安全性与可靠性:自动驾驶、配送机器人等在仿真环境中充分测试能减少真实场景的事故率和试错成本,间接提升用户信任和产品竞争力。
与现有产品/工作流的接口
- 评估框架集成:可嵌入现有 MLOps 流水线,作为 LMM 代理或具身模型的多模态评测套件,与 LangChain、AutoGPT 等代理框架对接。
- 机器人仿真平台:提供统一任务格式和 API,可对接 ROS、Isaac Sim 或 NVIDIA Omniverse,用于 sim-to-real 迁移研究。
- 数据增强与 benchmark 平台:数据集可整合进 Hugging Face 等平台,作为多模态模型训练或 few-shot 评测的基准。
具体落地 Use Case
- 自动驾驶测试:在虚拟秋叶原街区模拟复杂道路、密集行人和多路径选择,测试自动驾驶车辆的视觉导航与实时决策,降低真实路测风险。
- 最后一公里配送机器人:利用 landmark search 和 path reasoning 任务训练机器人在商业街区快速定位目标店铺并规划最优配送路线,提升物流效率。
局限
- **环境交互与运动自由度受限**:360CityArena 基于 360° 视频重建虚拟环境,可能仅支持离散视点切换或预设路径,无法提供连续自由移动,这与真实机器人部署中的连续控制存在差异。该限制可能导致 agent 无法执行精细的局部调整,影响其在复杂路口或狭窄空间中的表现评估。此外,视频重建可能缺乏显式深度信息,对依赖几何理解的空间推理任务(如距离估计、物体遮挡关系)构成挑战,降低评估生态效度。
- **任务规模与场景多样性有限**:当前数据集仅覆盖 Akihabara 一个district 的 85 条街道,共 175 个人工设计任务。虽然任务类别涵盖环境理解、路径推理和空间推理,但城市环境多样性不足,难以全面覆盖不同城市风格、道路拓扑和光照条件。模型在该 benchmark 上的表现可能无法泛化到其他城市或季节变化场景,限制了其作为通用城市导航评估基准的代表性。
- **评估指标与失败分析不足**:主要评估指标为任务完成准确率,未充分考虑导航效率(如路径长度、时间步数、碰撞次数)以及任务完成质量(如是否偏离最优路径)。人类基线 77.3% 与 Gemini 2.5 Flash 的 17.1% 存在巨大差距,但论文未深入分析失败模式(如感知错误 vs 规划错误),也未提供细粒度的错误类别统计,这削弱了 benchmark 对后续算法改进的指导价值。