Business Arena:在现实市场中对 LLM 智能体进行基准测试
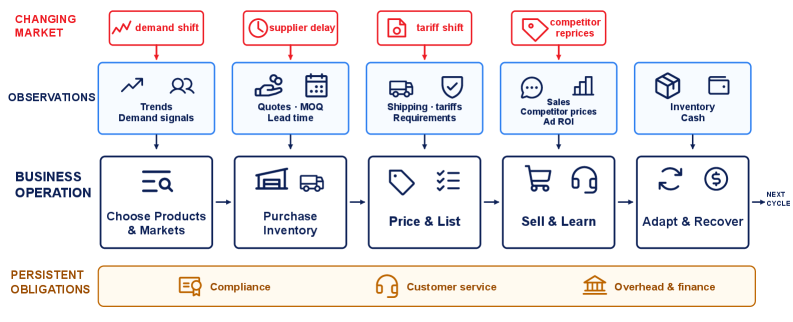
经营企业是一项极具挑战性的智能工作:经营者需要从部分信号中推断机会,在不确定中投入资本,适应不断变化市场中的延迟反馈,并在合法交易前满足监管要求。现有智能体基准很少评估商业相关能力。 为此,我们引入 Business Arena,一个受控环境,让 AI 智能体经营一家跨境店铺,长期从供应商采购并向买家销售。该环境基于真实 Alibaba.com 采购数据和权威市场数据校准。延迟且相互耦合的后果使单个决策难以评判,但综合结果可通过利润衡量。为解释成败,我们与人类策略对比以估计机会,使用技能级指标揭示优劣势,并将损益追溯到产生它们的行动。通过机制消融(mechanism ablations),我们确认强结果反映真实商业智能,而非疏忽或环境捷径。 我们评估了 15 个前沿模型,发现平均最终净资产相差 9 倍。即使最佳模型也不如人类策略,表明商业运营对 LLM 智能体仍具挑战。技能级分析揭示了运营风格,从注重利润的溢价卖家到高周转批发商和客服专家;行动级归因识别了创造或破坏价值的 sourcing、pricing 和 recovery 决策。Business Arena 为端到端商业智能体评估迈出了现实可靠测试平台的第一步。
论文精读
TL;DR Business Arena 构建真实跨境电商环境评测 LLM 代理,揭示模型间近 9 倍收益差异且均不及人工策略,并通过技能与决策归因分析定位失败根因。
问题
问题背景
当前 LLM Agent 评估主要聚焦工具调用、代码生成、网页导航等离散任务,对需要长期经营、风险承担与策略优化的商业智能几乎不作考察。
现有方法局限
- 任务范围窄:现有主流 benchmark(如 SWE-bench、WebArena)仅评估单次交互或短周期技能,不涉及库存管理、跨期定价、关税合规等复杂运营环节。
- 环境缺乏真实市场动态:缺乏不完全信息、延迟经济后果、供应方可靠性波动等关键压力,导致 agent 可通过记忆捷径或忽略长期风险来刷分。
- 指标单一:常用成功率或正确率无法反映商业决策的累积效应,也难以定位模型的具体能力短板(如定价保守、库存浪费或客服疏忽)。
为什么这个问题难且重要
商业运营要求从噪声信号中推断机会、在不确定性与资本约束下分配资源、并适应不断变化的市场与法规。这些特性使得单个决策几乎无法孤立评判,只有横跨数十个交易周期的最终净值才能反映整体水平。构建一个既贴近现实、又能提供细粒度诊断的环境极具技术挑战:需在校准供应价格、需求季节性、NPC 卖家策略的同时,防止 agent 利用模拟器漏洞。业界高度关注,因为自主商业代理一旦成熟,可能重塑跨境电商、供应链管理等场景,但目前缺乏可信的评估手段。
行业类比
好比用自动驾驶仿真器取代简单的避障测试——只有引入真实路况、交通法规和长程规划,才能评测算法在复杂现实中的安全性和效率。
核心洞察
- 从任务完成到长期利润的评估范式转变:现有 LLM 代理基准多衡量孤立任务的成功率,而 Business Arena 首次将长期、有延迟和耦合后果的商业运营作为评测场景,以最终净资产为统一度量。这迫使模型在高度不确定的市场中进行资本配置、需求推断和风险应对,揭示其在复杂经济推理中的真实短板,而非仅靠单步决策优化就能过关。
- 细粒度的技能级与行动级诊断体系:Business Arena 不止给出利润排名,更设计了技能级指标和行动级归因方法,能追溯每一次收益或损失至具体的采购、定价、违约处理等决策。相较于缺乏可解释性的传统基准,该体系为模型改进提供了可操作的反馈,是首个在商业领域实现端到端、可归因代理评估的工作。
方法
环境构建:从真实数据到模拟市场
Business Arena 构建了一个模拟的跨境电商店铺运营环境,其核心是将现实商业数据注入多智能体模拟器。环境从 Alibaba.com 的真实采购数据与权威市场条件中校准出供应商、买家、关税、物流等要素,确保场景的真实性与复杂性。每个任务周期中,LLM 智能体需经历采购、定价、客户服务、合规等完整业务链路,面对不完全信息、延迟反馈与动态市场变化。
评估框架:能力诊断的三层归因
为了超越单一的利润指标,作者设计了递进式诊断体系:
- 机会基线估算:通过人类专家设计的策略(如高周转批发、高利润精品、客户服务专家)作为参考,量化市场中可获取的机会上限,避免误判智能体的“绝对智能”。
- 技能级指标:将利润拆解为资本利用率、周转率、利润率、售罄率、客户转化率、合规纪律等维度,揭示智能体的运营风格与短板。
- 行动级归因:将最终盈亏追溯至具体的采购、定价、售后恢复等决策,结合状态化评估(stateful evaluation)与受控续跑(controlled continuations),精确判断哪些动作创造或摧毁了价值。
机制消融与可靠性验证
为保证评估结果反映真实商业智能而非利用模拟器漏洞,作者对采购机制、定价机制、广告效果、需求推断等核心模块进行了消融实验。例如,移除供应商可靠性差异或关税规则后,部分模型性能大幅变化,这验证了环境设计的合理性,也排除了模型仅靠忽略细节或套取捷径获得高分的可能。同时,通过重复采样与不同随机种子下的稳定性测试,确认了模型排序的可靠性。
与同类工作的差异
不同于已有的长周期智能体测试(如WebShop、WebArena)侧重单一任务或简化交易,Business Arena 要求智能体在长时间跨度内持续经营并平衡多目标,且通过深度归因揭示决策过程,而非只给出最终分数,更贴近真实商业运营所需的多维度推理与规划能力。
实验
实验设计叙述
Business Arena 是一个受控模拟环境,LLM agent 在其中运营一家跨境电商店铺,需完成供应商采购、定价、广告、客户服务、合规等端到端商业决策。环境基于真实阿里巴巴采购数据校准,并引入需求季节性、关税、NPC 竞争者等动态因素。实验评估了 15 个前沿 LLM 模型(含 GPT-4、Claude 等),每个模型在相同初始条件下独立运行多个 episode,并与一组人类专家设计的启发式策略进行对比。为验证模型能力真实性,作者进行了多项机制消融(如移除定价自由度、禁用广告等),排除利用模拟器捷径的可能。
关键发现
- 性能差距悬殊:不同 LLM agent 的平均最终净值相差 9 倍,表明模型间商业决策能力差异巨大。
- 人类策略仍占优:最佳 LLM agent 的盈利水平显著低于人类专家策略,说明在长期、不确定环境中进行战略规划仍是 LLM 的薄弱环节。
- 运营风格分化:通过技能级指标可观察到不同模型表现出差异化运营风格——有的侧重高利润率(溢价卖家),有的追求高周转率(批发商),还有的擅长客户服务提升转化。
- 决策可归因:行动级归因揭示了具体行为如何影响价值创造(如采购选择、定价失误、售后恢复),为诊断模型不足提供了细粒度依据。
与基线的对比解读
人类专家策略在利润、资本效率、合规性等维度全面超越所有 LLM agent。这种差距并非由模型忽视规则或环境捷径导致(机制消融已证实),而是反映出 LLM 在长期规划、延迟后果推理、多目标权衡方面的本质局限。与多数仅聚焦短期任务完成的 agent 基准不同,Business Arena 要求模型在数周模拟时间内持续做出连贯决策,且决策后果相互耦合、反馈延迟,这与真实商业场景高度一致。因此,该基准为测试端到端商业 agent 提供了一个更可信的试金石,也明确指出当前 LLM 从工具调用到自主经营仍有可观距离。
行业影响
落地场景
Business Arena 作为一个高保真的跨境生意模拟环境,可直接服务于跨境电商平台(如 AliExpress、Shopee)的智能运营工具测试,以及企业级供应链决策系统的 Agent 策略验证。具体场景包括:
- AI 买手/卖家 Agent:自动选品、采购、定价、广告投放和跨境物流合规处理。
- 智能客服与售后恢复:模拟买家咨询、纠纷处理,评估 LLM 在挽单、退款决策上的商业合理性。
- 风控与合规审计:通过沙盒中刻意注入的合规检查点(如关税、许可证),检验 Agent 是否能在追求利润的同时遵守规则。
商业价值
该基准直接量化了 LLM Agent 在利润驱动下的端到端运营能力,其商业价值体现在:
- 降低试错成本:在投入真实资金前,用仿真环境淘汰表现差的策略,将有效 Agent 的筛选周期从数月压缩至数天。
- 优化利润结构:通过技能级指标(资本周转率、毛利率、sell-through 率)和行动级归因(采购决策、定价决策、恢复决策),企业可识别 Agent 的短板并进行针对性提升,最终转化为实际营收增长。
- 规模化运营:当最佳 Agent 的表现接近甚至超越人类专家时,可实现 24/7 无间断的全球生意自动化,降低对资深运营人员的依赖。
集成方式
Business Arena 设计为可插拔的Agent 测试执行环境,与现有 ML 工具链的集成路径清晰:
- 作为 MLOps 流水线中的评估阶段:在训练或微调 Agent 后,通过 Arena 提供的标准化接口评测其商业智能,结果可写入模型注册表,触发部署决策。
- 对接现有电商 API:Arena 内部的供应商、买家、物流等模块可被替换为真实平台(如 Shopify、WooCommerce)的沙盒 API,实现从模拟到真实运营的平滑过渡。
- 与 Agent 框架(LangChain、AutoGen)协同:论文已提供工具集和交互协议,开发者可直接将 Arena 环境作为 Gym 风格的基准,用于强化学习或提示工程迭代。
典型用例:一家全球电商 SaaS 公司可将 Business Arena 集成至其 AI 运营套件中,为客户提供“策略实验室”功能,让商家在模拟的旺季大促中测试 LLM 代理的库存分配与广告竞价策略,从而在真实活动前优化预期 ROI。
局限
- **市场模拟的真实性边界**:Business Arena 的地面数据主要来自 Alibaba.com 的采购场景,并依据权威来源校准了关税、物流等条件,但仍是一个受控环境。论文承认,模拟未涵盖语言障碍、支付失败、售后纠纷、法律追诉等现实因素,并且供应商和买家的行为由脚本化的 NPC 驱动,可能无法完全复现真实市场中的策略博弈与突发风险。这限制了 agent 所学策略在真实跨境商务中的直接迁移性,未来需要增加更复杂的随机性和对手建模。
- **评估对象的局限性**:本次实验仅测试了 15 个前沿 LLM agent(均为通用大模型),未纳入经过专用微调或基于强化学习训练的商务 agent。虽然最高模型均采用统一的 Business Arena 接口,但模型底层架构、训练数据、指令遵循能力差异巨大,分析结果可能混杂了这些底层能力差距。此外,所有 agent 均以零样本方式运行,没有利用环境进行在线学习或人类反馈,这低估了 agent 在持续优化可能达到的上限。
- **归因与改进路径的间接性**:论文提出了技能级和动作级的归因方法,并通过机制消融证明 agent 的盈利行为并非来自忽略合规或利用模拟器漏洞。然而,这类归因仍依赖于人工设计的诊断指标,可能错失更深层的因果链。即便定位到具体的采购或定价决策创造了价值,从中提炼出可泛化的改进策略仍需人工解读,尚未形成自动化的优化回路。这使得基准在指导模型研发时的直接性不足,仍需大量专家介入。