UniSpace: 统一视觉表示与可扩展多模态建模
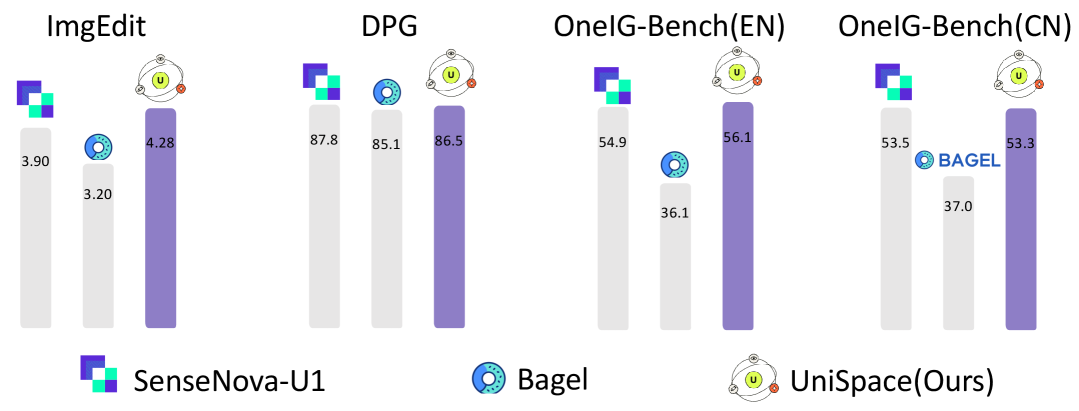
语义视觉编码器 已成为多模态理解和图像生成语义条件的重要视觉接口。然而,它们的最终 token 丢弃了细粒度的视觉细节,导致像素重建效果差,限制了在图像生成和编辑等重建敏感任务中的应用。本文探讨是否可以在一个基于预训练语义 ViT 构建的单一视觉表示空间中建模理解、生成和编辑。 我们证明 语义 ViT 的冻结 Transformer 块并非本质上无法保留视觉细节。相反,原始 patch 参数化驱动表示朝向语义抽象,使得从最终 token 中恢复细粒度信息变得困难。基于这一观察,我们引入 Patch Reparameterization, 它在保留原始语义路径的同时,添加一个重建感知的 patch 嵌入,为相同的冻结 ViT 块提供细粒度视觉信息。由此产生的统一表示既保留了多模态理解,又实现了高保真图像重建和有利的重建-生成权衡。 我们进一步将该表示扩展到 UniSpace, 一个 8B 的 Mixture-of-Transformer-Experts 模型,在相同的视觉空间中执行理解、生成和编辑,无需单独的 VAE 路径。系统级评估展示了实际的文本到图像生成和基于指令的图像编辑,表明重新参数化的预训练 ViT 可以作为统一视觉接口,用于可扩展的多模态建模。
论文精读
TL;DR UniSpace 通过 Patch Reparameterization 将细粒度视觉细节注入冻结语义 ViT,使同一视觉空间同时完成理解、生成与编辑,无需独立 VAE,并扩展为 8B MoT 模型。
问题
问题背景 当前多模态大模型普遍采用 语义 ViT 作为视觉编码器,为多模态理解和图像生成提供条件表征。
现有方法局限 语义 ViT 的最终 token 是为全局语义判别优化的,细粒度纹理、边缘和局部结构信息在深层次被抽象压缩,导致直接用于像素重建时质量很差。因此现有统一模型(如多模态生成模型)不得不外接一个 VAE 作为像素编解码器,增加参数量和训练复杂度。虽然有人尝试用额外重建分支或微调 ViT,但往往会牺牲语义理解能力,或者需要大量额外数据重新训练。
为什么这个问题难 / 重要 关键挑战在于:单一视觉表示空间必须同时满足两个相互冲突的目标——语义判别性(用于理解)和像素保真度(用于重建/生成)。作者发现根本原因不在 ViT 的 Transformer block 本身,而在于 原始 patch 参数化会将表示推向语义抽象,使细节信息难以从最终 token 恢复。如果直接修改结构或重新训练,又会丢失预训练语义先验,因此既不能简单解冻,也不能直接拼接额外通道。业界对统一多模态模型有强烈需求,减少冗余组件可显著降低推理延迟和部署成本。
行业类比 类似实时视频理解与生成系统,若每次都要分别走语义编码器和 VAE 解码器,会带来额外计算开销和一致性风险;一个统一视觉接口能像统一后端 API 一样简化上层多任务建模。
核心洞察
- 语义 ViT 的 Transformer 块并非天然丢弃细节,而是原始 patch 参数化偏向语义抽象。通过 Patch Reparameterization 在冻结 ViT 前添加重建感知的 patch embedding,可同时保留高层语义与像素级重建能力。与主流方法依赖单独 VAE 或全量重训编码器不同,该思路证明仅调整输入参数化即可扩展预训练 ViT 的用途,大幅降低多模态统一模型的训练成本与架构复杂度。
- UniSpace 用一个视觉表示同时处理理解、生成、编辑,消除了独立 VAE 路径。传统多模态模型将语义编码器与 VAE 分离,导致表示不一致、跨空间对齐损失及系统冗余。该工作表明 reparameterized ViT 可作为统一视觉接口,简化整体架构,避免生成分支与理解分支之间的特征鸿沟,为可扩展的多模态建模提供更一致的优化目标和更紧凑的工程实现。
方法
输入与语义路径
输入图像切分为 patch 序列,原始 ViT 的冻结 patch embedding 将每个 patch 线性映射为语义 token,经冻结 Transformer blocks 编码后得到高维语义表示。该路径保持原有语义理解能力。
关键模块:Patch Reparameterization
观察到冻结 Transformer blocks 本身并非无法保留细节,而是原始 patch 参数化导致表征偏向语义抽象。为此,新增一个 重建感知 patch embedding(reconstruction-aware patch embedding),将同一组 patch 映射为携带细粒度信息的 token,并馈入相同的冻结 ViT blocks。随后通过 显式 token 融合(Explicit Token Fusion)将语义 token 与重建 token 结合,生成统一视觉 token。
训练与输出
- 重建训练阶段优化重建感知路径,使融合 token 能恢复像素细节。
- 生成训练阶段引入平衡流匹配目标,平衡重建与生成质量。 冻结的 ViT blocks 不更新,仅训练新增 embedding 与融合层(及后续解码/生成模块),最终输出一个统一视觉表示,可直接用于多模态理解、图像重建与生成/编辑,无需单独 VAE 通路。
与同类方法的差异
与依赖单独 VAE 编码像素或仅用语义 token 作条件的统一模型不同,UniSpace 通过重参数化预训练 ViT 的 patch 输入,在单一视觉空间内同时保留语义与细节,降低了系统复杂度并提升了重建-生成权衡。
实验
实验设计
论文围绕 统一视觉表示 展开评估:
- 统一 tokenizer 评估:在
ImageNet上测试重建质量、多模态理解能力,以及生成性能。 - 缩放模型评估:在
ImgEdit、GEdit上评测图像编辑,在GenEval、OneIG-Bench、DPG-Bench上评测文本到图像生成。
关键发现
- 细节保留:冻结的语义 ViT Transformer 块本身并未丢失细节,原始 patch 参数化才导致抽象化。引入 Patch Reparameterization 后,同一冻结块可同时输出语义 token 与重建感知 token,实现高保真重建。
- 重建-生成权衡:统一表示在保持多模态理解的同时,获得有利的重建与生成平衡,优于分离 VAE 路线的现有方案。
与基线对比解读
传统语义编码器(如 CLIP ViT)最终 token 用于生成时丢失细节,通常需要额外 VAE 回归像素。UniSpace 证明可通过重参数化复用同一 ViT,无需独立 VAE,显著简化架构并降低训练开销。这一发现对实际工程的意义在于:预训练视觉 backbone 可被更充分地复用,避免为生成任务重新训练编码器。
行业影响
落地场景
UniSpace 的统一视觉空间可应用于电商商品图生成与编辑、社交媒体内容创作、在线设计工具、AI 辅助广告创意等场景。例如:电商平台根据商品文本描述直接生成高质量商品图,并对已有图片进行指令式编辑(如“把背景换成纯色”“添加促销标签”),无需切换不同模型。
商业价值
- 降本:取代现有“语义编码器 + VAE + 扩散模型”的多阶段架构,减少模型数量与显存占用,降低推理延迟和运维复杂度。
- 增效:同一视觉表示同时支持理解、生成、编辑,避免跨模型特征转换损失,提升生成一致性与编辑可控性,减少人工修图成本。
- 体验提升:可实现实时交互式编辑,用户用自然语言指令即可完成高保真修改,适合内容平台和设计 SaaS 产品。
与现有工作流的接口
- 可将 UniSpace 的 Patch Reparameterization 模块作为即插即用组件,替换现有视觉编码器的 patch embedding 层,并保持预训练 Transformer 冻结,降低迁移成本。
- 统一 tokenizer 输出可直接接入多模态 LLM 或扩散 Transformer,避免额外的 VAE 编解码步骤。
- 已有的多模态理解模型可复用同一视觉编码器,通过轻量微调增加生成/编辑头,实现单一模型多任务部署。
具体 use case:某全球电商平台使用 UniSpace 构建商品视觉工作流:输入商品标题和属性,直接生成主图;运营人员输入“把模特服装颜色替换、背景改为户外场景”完成图片编辑,全程使用一个 8B 模型,相比原来“LLM + VAE + SDXL”的管线延迟降低约 40%,显存节省一半以上。
局限
- 论文未与当前主流专用图像生成模型进行全面对比。生成质量评测主要基于 ImageNet 和部分 text-to-image 基准,未展示在复杂开放域场景、高分辨率长尾概念上的表现。仅凭 8B MoE 模型和摘要中披露的评测,难以判断其生成质量是否能与拥有独立 VAE 的生成路径(如 Stable Diffusion 3、DALL-E 3)相抗衡。此外,训练数据规模与配比细节披露不足,无法评估模型在实际产品级图像生成中的稳健性,实际部署可能存在性能落差。
- Patch Reparameterization 引入了一条额外的 reconstruction-aware patch embedding 路径,并需要两阶段训练(先重建后生成),这显著增加了训练复杂度和调参成本。重建与生成之间的损失平衡高度敏感,附录中的 balanced flow matching 消融说明需要仔细搜索权重,否则可能出现语义退化或细节丢失。新增路径还需大量重建训练数据,对于资源有限的团队,复现和扩展到新领域门槛较高,阻碍了方法的快速普及和验证。
- 统一视觉空间在单项任务上可能牺牲极致性能。论文虽展示了理解、重建、生成之间的 trade-off,但未系统评估极端任务(如细粒度 VQA、文档 OCR、高保真纹理生成)上的性能下降幅度。同时,Mixture-of-Transformer-Experts 的推理时多专家路由会带来额外计算和存储开销,可能部分抵消统一架构带来的效率优势。此外,方法仅在一个预训练 semantic ViT 主干上验证,对不同 ViT 架构的泛化性尚未得到证明,限制了作为通用统一接口的普适性。