Thought-Level Beam Search for Reasoning
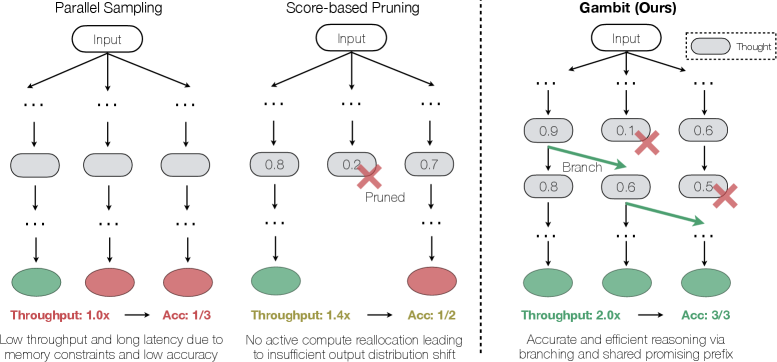
测试时计算扩展是大型推理模型性能的主要驱动力,但极端低效限制了现有方法,关键问题从“用多少计算”转变为“计算分配到哪里”。本文将测试时推理形式化为受约束的计算分配问题,作用于部分轨迹。在固定硬件预算下,现有范式无法主动将计算分配给最有希望的部分进展:传统并行采样独立处理轨迹,导致严重的内存瓶颈;而减法剪枝则使硬件饥饿,无法主动且充分地改变输出分布。 为克服这一 dichotomy,本文提出 Gambit,一种执行思路级束搜索的推理算法。通过定期剪枝无望的轨迹,并立即从高质量前缀分支,Gambit 借助轻量级评分器探测隐藏状态,动态地将计算集中到最有希望的推理轨迹上,同时保持持续的硬件高利用率。 在多个模型和基准上的大量评估表明,Gambit 严格优于现有基线。在相同硬件约束下,与剪枝基线相比,该方法在 HMMT-24 上最多获得 +6.7% 的绝对准确率提升,在 AIME-25 上获得 +3.3%;在轨迹完成上提供 2 倍的吞吐量,并将总 token 消耗相比标准并行采样减少最多 68.5%。
论文精读
TL;DR Gambit 将推理形式化为受限计算分配问题,用 thought-level beam search 动态剪枝低质轨迹、分支高质量前缀,在固定硬件下最高提升 6.7% 精度、2 倍吞吐,并减少 68.5% token 消耗。
问题
问题背景
当前大型推理模型(LRMs)主要依赖 test-time compute scaling 提升性能,但推理成本急剧膨胀,核心问题已从“投入多少算力”转向“算力分配到何处”。
现有方法局限
- 并行采样 将多个完整轨迹独立生成,KV cache 内存随并发数线性增长,形成严重内存瓶颈;且各轨迹间无交互,无法在生成中途将算力转向更优前缀。
- 减法剪枝 逐步淘汰低分轨迹,虽缓解内存压力,但会导致硬件饥饿(GPU 利用率不足),因为活跃序列减少后并行度下降;同时剪枝只做减法,无法从高质量前缀扩展新分支,输出分布偏移不够有效。
作者论断:剪枝系统“starves hardware and fails to actively and sufficiently shift the output distribution”。
为何困难且重要
技术上需要在部分轨迹上动态评估质量,要求 scorer 轻量且准确;同时必须维持连续的高硬件利用率,避免频繁剪枝导致的计算空转。这涉及 KV cache 解耦管理、分支调度与内存回收等系统级设计,还要保证 beam search 在自回归推理中的低延迟。工业界对固定硬件预算下的准确率与吞吐高度敏感,更高效的 test-time 计算分配直接影响部署经济性与产品体验。
行业类比
类似 AlphaCode 在代码生成中先采样后聚类过滤,但 Gambit 将筛选与扩增提前到 token 级别,属于生成过程内部的细粒度计算调度,而非事后筛选。
核心洞察
- - Gambit 将 test-time compute 定义为 **部分轨迹上的受限计算分配问题**,把重点从“总共花多少计算”转移到“把计算分配到哪些前缀上”。与 parallel sampling 将每条 trace 独立处理、导致严重显存瓶颈,以及 subtractive pruning 因裁减而让硬件饥饿并无法充分改变输出分布不同,Gambit 通过周期性剪枝低潜力 trajectory 并立即从高质量 prefix 分支,用轻量 scorer 探测 hidden states,在固定硬件预算下维持持续高利用率,动态地把计算集中到最有希望的推理路径。
- - Gambit 的关键工程实现是 **thought-level beam search 的解耦内存管理**:剪枝后立即从高质量前缀分支,避免传统 beam search 在等待完整序列或重计算 KV cache 时引入的空闲周期。该设计让 scorer 只在 thought 边界触发,降低额外推理开销,同时保持 prefix reuse 与 unique token 最小化。相比现有 subtractive pruning 的“只减不加”,Gambit 能在裁剪后主动扩增高质量分支,真正实现 active search,这是其在 HMMT-24 / AIME-25 上严格优于 baseline 的底层原因。
方法
Gambit 将推理过程形式化为部分轨迹上的受限计算分配问题,输入为问题提示与一个轻量级序列 scorer(通过隐藏状态预测前缀质量)。
核心流程
- 轨迹初始化:从问题出发,采样若干初始 thought(思考步骤)作为 beam 节点。
- 周期性评分与剪枝:每完成一个 thought,scorer 读取当前序列的隐藏状态,输出每个轨迹的得分;保留 top-(k) 个高分前缀,删除低分节点。
- 从高质量前缀分支:对存活前缀立即扩展多个候选后续 thought,而非等待原始轨迹完成。
- 迭代至终止:重复评分-剪枝-分支,直到满足预算或生成完整解答。
系统集成要点
- Decoupled memory management:不同 beam 共享公共前缀的 KV cache,减少内存峰值;前缀重用与 unique token 最小化进一步降低显存占用。
- 隐藏状态评分:scorer 直接探测中间层隐藏状态,避免完整前向传播,开销极小。
- 硬件利用率:通过连续调度活跃轨迹,避免 subtractive pruning 的硬件饥饿问题。
与 parallel sampling(独立全轨迹采样,忽略中间质量)和 subtractive pruning(只剪枝不分支,无法主动转移分布)不同,Gambit 同时执行剪枝与分支,将计算动态集中到最有希望的推理前缀上。
实验
实验设计
在固定硬件预算下,对比 Gambit 与两种基线:并行采样 (parallel sampling) 和 剪枝式方法 (subtractive pruning)。评估覆盖多个 大型推理模型 (LRM) 和数学推理基准,如 HMMT-24、AIME-25,从准确率、吞吐量、token 消耗和解码动态四个维度展开。
关键发现
- Gambit 严格优于基线,相同硬件约束下:
- HMMT-24 绝对准确率提升 +6.7% (vs 剪枝基线)
- AIME-25 绝对准确率提升 +3.3% (vs 剪枝基线)
- Trace completion 吞吐量提高 >2x
- 总 token 消耗相对并行采样最多减少 68.5%
- 解码分析显示前缀重用增加,唯一 token 生成减少,总序列长度分布偏移,降低了解码延迟。
基线对比解读
传统并行采样将每个轨迹独立处理,导致严重内存瓶颈;剪枝方法则因提前丢弃而硬件饥饿,且无法充分主动偏移输出分布。Gambit 通过周期性剪枝低分轨迹并立即从高质量前缀分支,动态将计算集中到最有希望的推理轨迹,同时保持高硬件利用率。轻量级 scorer 探测隐藏状态,实现主动剪枝与分支,克服了前述二元对立,从而在准确率和效率上实现同步提升。
行业影响
落地场景
Gambit 适用于需要长链推理的后台服务,如数学求解 API、代码生成助手、科学问答系统。具体用例:
- 教育解题平台:高并发提交复杂数学题,期望在固定 GPU 集群上服务更多请求且不降低准确率;Gambit 可优先扩展高质量前缀,减少无效推演。
- 金融分析工具:生成财报解读与风险评估时,推理路径长且易分叉;通过动态剪枝和分支,可更快锁定关键分析走向。
商业价值
- 降本:相对并行采样减少 token 消耗最高 68.5%,直接降低推理成本。
- 增收/体验:在相同硬件预算下准确率提升(HMMT-24 +6.7%、AIME-25 +3.3%),服务质量上升;同时 trace 吞吐 >2× 提升,可支撑更高并发。
与现有产品/工作流的接口
Gambit 可作为推理策略层插入现有推理引擎(如 vLLM、SGLang):
- 在采样循环中增加轻量 scorer(基于 hidden states),对部分轨迹打分;无需改动大模型权重。
- 内存管理解耦:
thought-level beam search周期性剪枝并分支,需与 KV cache 管理器协同,现有分页内存可适配。 - 对已使用并行采样或剪枝的服务,可平滑替换后端采样器,前端 API 保持不变。
项目主页:Gambit GitHub
局限
- **依赖训练好的 scorer**:Gambit 的性能高度依赖于其轻量 scorer 的质量。该 scorer 需要通过额外数据训练(见附录 A.1),若 scorer 对部分轨迹潜力的评估不准确,beam search 可能过早剪枝掉有价值的分支,导致准确率下降。论文未分析 scorer 误差传播对最终结果的影响,也未提供无训练 scorer(如基于规则的启发式)作为对照,削弱了方法的开箱即用性。
- **评估范围较窄**:实验主要基于数学推理基准 HMMT-24 和 AIME-25,并在有限数量的模型上测试。虽然结果显著,但未覆盖代码生成、多跳问答、开放式推理等更广泛的推理任务,难以证明方法的跨任务通用性。此外,基线仅包括并行采样和剪枝类方法,未与蒙特卡洛树搜索(MCTS)、基于价值模型引导的搜索等更先进的推理时搜索策略直接比较,限制了结论的完整性。
- **系统实现复杂度高**:Gambit 需要解耦内存管理、动态分支调度以及前缀复用等机制,相比传统的并行采样或简单的剪枝推理,工程实现复杂度明显增加。论文强调能够维持高硬件利用率,但对于更大规模部署(如大规模并发请求、超长轨迹、多 GPU 分布式环境)下的扩展性、容错以及与其他推理优化技术(如 continuous batching、PagedAttention)的兼容性缺乏深入讨论,实际落地可能面临额外挑战。