零差距不是恢复:基准污染的分层逐问题概率评估与逐步缓解
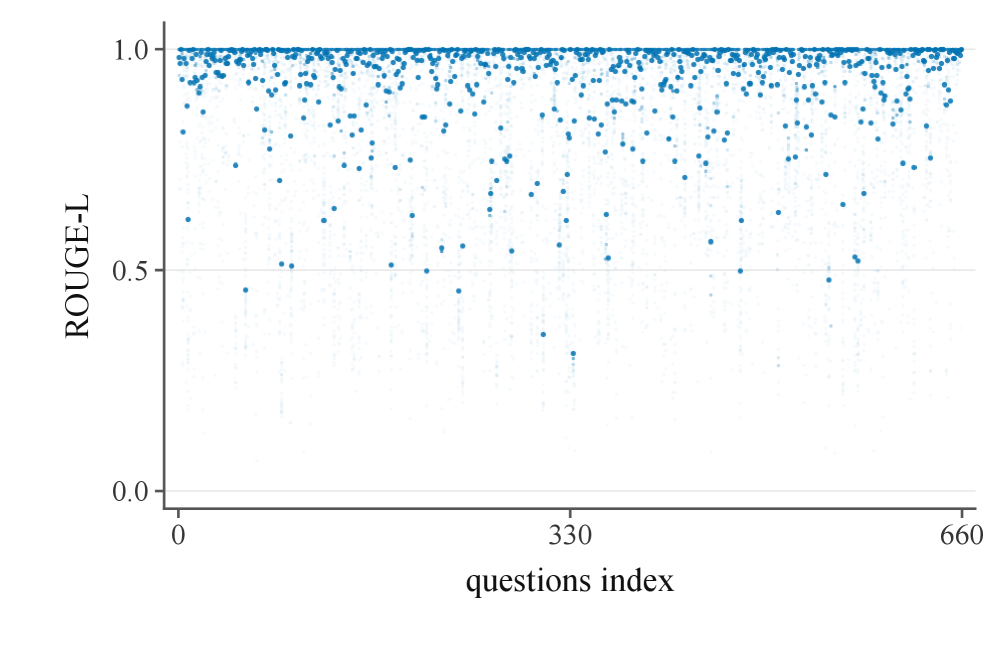
公共基准的测试数据不可避免地泄漏到预训练语料中,一旦模型记忆这些数据,评估分数就会被虚高。缓解污染评估在解码过程中进行干预,以抑制记忆并恢复受污染模型的真实能力,但其主流指标 G-AP(聚合性能差距)存在缺陷。 G-AP 的缺陷包括: - 离散的正误读数无法刻画逐问题性能; - 先平均再差分会使过度抑制与欠抑制相互抵消; - 均匀的逐问题加权会促使策略将求解概率推向干净模型的高频值。 为此,我们提出 SA-PPG(分层逐问题概率差距聚合):通过采样估计每个问题的求解概率,与干净模型逐问题求差,并按干净模型的求解概率分层聚合。 现有缓解策略先估计污染位置再据此操作,因此其效果受限于估计的准确性。RailCap 则在生成过程中判断污染:每当样本落回贪婪轨迹,便将下一轨迹 token 限制为次选,逐步累积抑制,直到响应分布充分分散。 在多个受污染模型和基准上,SA-PPG 显示先前的策略对恢复效果存在大幅高估,而 RailCap 取得了最低的 SA-PPG。
论文精读
TL;DR 现有去污染评估指标 G-AP 存在严重缺陷,本文提出分层概率指标 SA-PPG 与解码端逐步抑制方法 RailCap,证实先前方法被高估,RailCap 取得最优去污染效果。
问题
问题背景
大规模语言模型(LLM)的评测严重依赖公开基准(如 MMLU、HumanEval),但基准数据极易通过预训练语料泄露,导致模型通过记忆而非真实能力获得虚高分数。抑制记忆、还原模型真实能力的污染缓解评估成为可靠能力测量的关键环节。
现有方法的局限
当前主流指标 G-AP(Aggregate Performance Gap)存在三重缺陷:
- 离散二值化:仅以“对/错”判断衡量性能,无法捕获模型对问题求解概率的连续变化,丢失了大量细粒度信息。
- 先平均后差分:先计算整体准确率再求与干净模型的差距,使得过度抑制与抑制不足在平均过程中相互抵消,掩盖了真实恢复效果。
- 均匀权重诱导策略:对所有问题一视同仁,变相鼓励方法将求解概率简单推向干净模型的高频值,而非关注各问题真实的能力对齐。 现有缓解策略大多采用“先定位污染再操作”的流水线,其精度严重依赖污染估计的准确率,而估计本身困难重重,导致恢复效果被系统性高估。
技术挑战与重要性
污染缓解评估面临的核心挑战是如何在不依赖显式污染标签的前提下,定义并度量模型能力的“恢复程度”。由于真实污染分布未知,任何宏观指标都可能被策略利用而失真。更本质的困难在于,污染对每个问题的影响强度不同,统一的标量指标必然忽略这种异质性。业界对可信 LLM 评测的需求日益迫切,一个能精细反映问题级恢复水平的指标,是推动稳健模型开发与公平比较的基础。
行业类比
如同自动驾驶测试中,若评测指标只看平均安全里程而忽略危险场景的恢复能力,则可能诱导系统只在简单场景过度优化——基准污染恢复问题同样要求评价体系能区分不同难度和污染程度下的真实表现。
核心洞察
- **G-AP 指标的系统性缺陷导致污染缓解被高估**:现有 G-AP 仅以离散正确率聚合再求差,会掩盖过度抑制与抑制不足的抵消效应,并使策略偏向高频正确样本。**SA-PPG** 提出逐题求解概率的差距分层聚合,实验表明先前方法在多个基准上的“复原”效果被严重高估,甚至出现排名反转,揭示了连续概率评估对真实恢复能力判定的必要性。
- **RailCap 开创了生成过程判断污染的实时抑制范式**:不同于先定位污染再操作的传统两步法,RailCap 在解码时一旦检测到采样回退至贪心轨迹,便抑制下一 token 至次优候选,累积扰动直至响应分布充分散开,从而避免污染估计错误导致的二次偏差。这种方法在多个污染模型中取得最低 SA-PPG,为无显式污染定位的鲁棒缓解提供了新路径。
方法
RailCap:基于逐步抑制的去污染解码方法
RailCap 旨在复原被基准污染损害的模型真实能力,其核心思想是在生成过程中动态检测并抑制污染记忆,而非预先猜测污染位置。
输入与输出
- 输入:一个已遭受基准数据污染的预训练语言模型,以及一个来自(可能污染的)基准测试的问题提示。
- 输出:经过去污染处理的文本生成结果,用于更真实地评估模型能力。
关键模块:自适应污染检测与逐步抑制
RailCap 不依赖外部污染估计,而是在每一步解码时进行以下判断与干预:
- 落回检测:对比当前采样路径与贪婪解码轨迹。若连续若干 token 的采样结果与贪婪 argmax 相同,则认为模型可能落入了污染记忆的“惯性”模式。
- Runner‑up 封顶:一旦检测到落回,RailCap 将下一步的 token 选择强制限制为概率第二高的候选(runner‑up),而非概率最高的贪婪 token。这一操作迫使模型偏离被记忆的路径。
- 累积抑制:重复执行「检测→封顶」的循环,直到生成分布的熵或分散度达到预设阈值(即响应分布已足够“发散”),此时认为记忆压制已充分,恢复正常解码。
整个过程无需先验地知道哪些样本被污染,而是通过“走偏一步,再走偏一步”的方式逐步削弱记忆效应,实现能力复原。
与同类方法的差异点
现有污染缓解策略通常分两步:先估计污染所在(如通过 n‑gram 匹配或困惑度比对),再对估计出的污染区域施以惩罚或屏蔽。这类方法过度依赖污染估计的准确性,一旦误判,反而可能损害模型在干净样本上的表现。RailCap 则将检测与抑制统一到生成过程中,以模型自身的行为(是否掉回贪婪轨迹)作为污染信号,避免了分阶段设计带来的错误传递,在多模型、多基准的设置下展现出更低的 SA‑PPG 分数,说明其复原效果更为彻底且鲁棒。
实验
实验设计
本文实验围绕两个核心贡献展开:(1) 新指标 SA-PPG 的有效性验证;(2) 去污染策略 RailCap 的效果评估。所有实验均在受污染的模型与公开基准数据集上进行,通过模拟预训练数据泄露来考察模型记忆对评测的干扰。对比的缓解策略包括现有的基于估计的干预方法,以及本文提出的 RailCap。评估时,对每个问题采样估算 solve probability,并与干净模型做逐题差值,最后在干净模型 solve probability 分层内聚合,得到 SA-PPG;同时报告传统指标 G-AP 作为对比。
关键发现
- 指标反转:SA-PPG 与 G-AP 给出了相反的缓解策略排名。先前策略在 G-AP 下看似恢复良好,但 SA-PPG 揭示其真实恢复程度被大幅高估。
- 高估根源:G-AP 的缺陷——离散正确/错误读数无法刻画逐题表现,平均后再差分导致过抑制与欠抑制相互抵消,均匀加权诱使策略偏向高频 easy case——是造成失真的主因。
- RailCap 优势:RailCap 在所有污染模型和基准上取得了最低的 SA-PPG,证明其逐步骤监督的抑制方式能更精准地剥离记忆影响,且无需显式估计污染位置。
与基线对比的深度解读
先前策略大多遵循“先估计污染位置,再对估计结果执行操作”的范式,其有效性高度依赖估计的准确性,一旦估计偏差,后续干预可能反成干扰。而 RailCap 另辟蹊径,在生成过程中实时判断污染:当采样路径回落到贪心轨迹时,将下一个 token 限制为概率次高项,累积抑制直到响应分布足够分散。这种机制天然规避了离线估计的风险,且仅在必要时施加惩罚,避免过度修正。SA-PPG 的分层设计则消除了 G-AP 的聚合偏差,使得即便在模型对不同难度问题表现差异巨大时,也能公平衡量恢复效果。从工程部署角度看,RailCap 是一种即插即用、无额外估计开销的轻量方案,适合集成到生成流程中,而 SA-PPG 则为更可信的离线评测提供了新基准。
行业影响
落地场景
基准污染导致大模型在公开基准上虚高评分,却在实际任务中表现不佳。SA-PPG 提供更真实的每问题概率间隙评估,可嵌入模型选型、技术报告发布等环节的内部评测 pipeline。RailCap 作为一种在生成过程中抑制记忆的解码策略,适用于任何需要减轻污染、提升输出原创性的场景。
- AI 编程助手(如代码补全、自动修复 Bug):模型可能记忆了 LeetCode 测试用例,SA-PPG 能发现“高分低能”问题,RailCap 则能在实际推理时减少直接复制粘贴答案,提升生成代码的泛化性。
- 在线教育平台(如 AI 辅导系统):避免模型照搬题库答案,RailCap 可帮助生成更真实的解题思路引导,而非简单的记忆复现。
商业价值
- 降低误判风险:污染导致的虚高评分可能使企业错误地选择能力不足的模型,进而引发线上事故或客户流失。SA-PPG 让评估更贴近真实能力,减少此类损失。
- 提升产品信任与粘性:对于代码助手、写作助手等工具,输出原创、非记忆的内容能显著增强用户信任,尤其在法律、医疗等对准确性要求高的领域,RailCap 可降低合规风险。
- 节约迭代成本:更准确的评估反馈帮助研发团队聚焦真正薄弱环节,避免在“已过时”的基准分数上优化。
与现有产品/工作流的接口
- 评估集成:SA-PPG 可包装为自动化评估组件,与 MLflow、Kubeflow 等 ML pipeline 工具对接,输出分层报告,替代或补充 G-AP 指标。
- 推理部署:RailCap 作为轻量级解码策略,可无缝嵌入 vLLM、Hugging Face TGI 等高性能推理框架,通过配置
decoding_strategy=railcap及少量超参数(如 n-gram 阈值)启用,与现有采样参数(temperature、top-p)共存,不影响推理延迟。 - 污染检测前置:对于已知污染源的数据,可将 RailCap 与检索增强(RAG)结合,先检索相似记忆,再动态调整抑制强度。
局限
- - **计算成本较高**:SA-PPG 需要多次采样来估计每道题目的解决概率,这可能显著增加评估开销,尤其在大规模基准或计算资源有限的场景下。尽管采样数量可控,但相比 G-AP 的单次推理,SA-PPG 的实用性在低资源环境中可能受限。此外,RailCap 在生成时需实时计算轨迹偏离与分布离散度,引入了额外的运行时开销,可能影响推理速度。
- - **泛化性有待验证**:实验主要在模拟的污染模型(如通过微调注入污染数据)和特定基准上展开,真实世界中污染形式多样(如文档片段、问答对混合),RailCap 的 n-gram 阈值与贪心轨迹回退判断可能对不同风格或语言的基准表现不一。SA-PPG 的分层聚合方式虽优于 G-AP,但其分箱策略依赖干净模型的解决概率分布,若干净模型能力不足或基准难度分布偏移,分层可能失效。
- - **对非自回归任务适用性不明**:RailCap 的逐 token 干预机制高度依赖自回归语言模型的生成特性,对扩散生成、图像生成等非自回归或非文本模态任务难以直接迁移。同时,SA-PPG 基于采样估计得分概率,适用于有明确评估指标的任务,但对开放式生成质量评估(如流畅性、有用性)则无法直接应用,限制了其在更广泛基准污染评估中的使用。