Skaling: Chinchilla 指数与 Kaplan 耦合
神经缩放定律是语言模型开发的基础,但标准公式在数据稀缺和过度训练极端情况下会系统性地低估或高估损失。这一失败的根源在于潜在假设:模型大小 与 训练数据 对损失的影响是独立的。 为此,我们提出 Skaling 定律,一种广义函数形式,通过单一交互指数耦合 模型容量 与 数据量。该扩展在 插值 与 外推 两种场景下,将 平均绝对百分比误差(MAPE) 降低了 1.5-3 倍。 结合仅限低计算量场景的 稀疏网格策略 时,Skaling 定律能以约 10 倍更少的计算量,实现准确的完整网格外推。通过小规模实验可靠预测性能,Skaling 定律为下一代模型训练的计算预算分配提供了更稳健、资源更高效的框架。
论文精读
TL;DR 提出 Skaling 缩放定律,用单个交互指数耦合模型容量与数据量,解决标准缩放律在数据稀缺和过度训练时预测失准问题,预测误差降低 1.5–3 倍,结合稀疏网格策略以约 1/10 计算量实现可靠外推。
问题
问题背景
神经缩放定律(scaling laws)是现代大语言模型(LLM)开发的基石,它通过少量小规模实验预测大规模训练的性能,从而指导计算预算分配和架构设计。当前,业界高度关注提升预测精准度,尤其是在数据量极端不足或过度训练的场景下,避免资源浪费。
现有方法局限
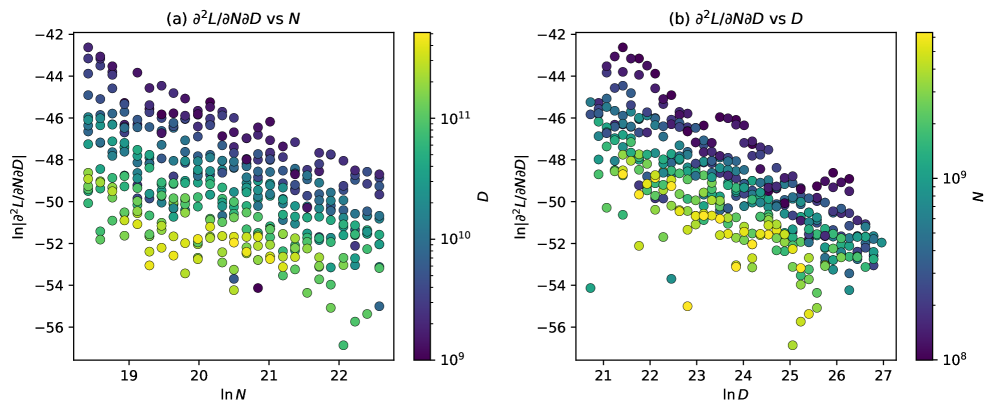
主流缩放定律,如 Kaplan 形式 和 Chinchilla 形式,都基于一个隐含假设:模型参数量(N)和训练数据量(D)对损失的影响相互独立。这一假设导致在数据稀缺端(D ≪ N)系统性低估损失,而在过度训练端(D ≫ N)系统性高估损失。根源在于损失曲面上 N 与 D 存在强耦合效应,独立假设无法捕捉这种交互。现有方法通过均匀网格扫描拟合,不仅计算开销大,且外推时边界误差显著(MAPE 偏高)。
为何问题重要且困难
精确预测缩放行为对技术决策至关重要:低估损失会导致训练不充分,高估则造成计算超支。但建模 N 与 D 的耦合面临两大挑战:① 计算成本——全网格扫描极高,必须依赖稀疏采样和小规模实验外推;② 函数形式——如何在保持简洁的同时引入交互项,防止过拟合。若能以小得多的计算量(如 稀疏网格策略)实现准确外推,将显著提升资源配置效率,这对全行业的大模型预训练具有直接经济价值。
行业类比
与推荐系统中单纯依赖独立特征无法准确预估点击率类似,语言模型性能预测也需显式建模模型容量与数据量之间的交互作用,才能避免在资源分配决策中出现方向性偏差。
核心洞察
- 交互耦合纠正了标准缩放定律对数据稀疏与过度训练场景的系统性偏差。Kaplan 和 Chinchilla 形式均假设模型大小与数据独立影响损失,导致在数据极端稀缺或过度训练时预测严重失准。Skaling law 通过引入单一交互指数耦合二者,以最小参数增量(仅增加一个指数)统一了 Kaplan 的耦合思想与 Chinchilla 的指数形式,在插值和外推任务上 MAPE 降低 1.5–3 倍。这一修正揭示:模型与数据并非独立维度,而是协同作用于损失曲面,为更准确地刻画缩放行为奠定了新的理论基础。
- 稀疏网格策略结合 Skaling 定律实现了极低计算代价的准确外推。传统均匀扫描需在高计算区间大量实验以构建完整损失网格,而 Skaling 仅依赖低计算区域的稀疏采样(如计算量减少约 10 倍),利用耦合形式的平滑性即可外推整个网格。这种方法论革新使算力受限的研究团队也能进行可靠的缩放预测,大幅降低了对大规模计算资源的依赖,为资源高效的模型研发和超参数搜索提供了实用新范式。
方法
方法核心:从独立假设到耦合缩放
Skaling 律的设计动机源于传统缩放律(如 Kaplan 形式、Chinchilla 形式)中模型参数量 N 与训练数据量 D 对损失独立作用的假设,该假设导致在数据稀缺极端(D 极小)或过度训练极端(D 极大)时出现系统性低估或高估。Skaling 通过引入单一交互指数将 N 与 D 耦合,用一个乘性项替代独立的幂律项,从而更准确捕捉损失曲面的联合缩放行为。
输入:一系列小规模实验数据点,每个点包含模型参数量 N、训练 token 数 D 以及对应的验证损失 L。这些点通常来自低计算预算区域。
关键模块:
- 耦合函数形式:损失函数表达为
L(N, D) = E + A / (N^α * D^β)^{γ}一类形式(原文为乘性耦合,而非加法交互项)。其中 α, β, γ 为可学习参数,通过 γ 统一调控 N 和 D 对损失的联合影响强度。这一形式源自对损失曲面的数值梯度分析:观察发现损失对 N 和 D 的偏导数在高维空间中并不彼此正交,存在强交互。 - 稀疏网格采样与拟合:为最大化计算效率,只在
N和D的低计算区域构建稀疏网格(例如等比例缩放切面N ∝ D^p上的少量点),然后在这些点上拟合 Skaling 律参数。通过该策略,仅需均匀网格约 1/10 的计算量即可获得可靠拟合。 - 外推机制:拟合完成后,将参数外推到高计算量区域,预测更大模型在更多数据上的损失。评估使用 MAPE,在插值和外推区间均比 Chinchilla 律低 1.5–3 倍。
输出:高精度损失预测,同时可导出计算最优的 token 与参数量配比(如“Farseer 分配前沿”),为下一代模型训练的计算预算分配提供更稳健的决策依据。
与同类方法差异:Skaling 律用单个耦合指数取代多个独立指数,在保持函数形式简洁的同时,纠正了极端区域误差,并且通过低计算区稀疏采样极大降低了实验成本,而传统均匀网格扫描或基于独立假设的缩放律无法兼顾这两点。
实验
实验设计与关键发现
实验设计 论文采用 稀疏网格策略 (sparse grid strategy),仅在低算力区间进行采样,然后利用 Skaling law 外推至全网格。评估覆盖多种模型大小与数据量组合,对比标准缩放律 (如 Kaplan 和 Chinchilla 形式) 的预测误差,指标为 MAPE。
关键发现
- 耦合建模的威力: Skaling law 通过交互指数将模型容量与数据耦合,在 数据稀缺 (data-scarce) 和 过度训练 (overtraining) 极端区域显著降低预测误差,MAPE 减少 1.5–3 倍。
- 高效外推: 结合稀疏网格,仅用 约 10 倍少 的计算即可实现准确的全网格性能外推,无需密集扫描。
- 交互指数稳定可解释: 该指数在不同设置下保持稳定,揭示了损失曲面中模型与数据的耦合强度。
与基线对比解读 传统缩放律假定模型大小和数据对损失的影响相互独立,导致在上述极端区域系统性低估或高估。Skaling 引入的 单一交互项 打破了这一假设,从根本上修正了误差。与 Kaplan 耦合形式 相比,Skaling 更具普适性(统一了 Kaplan 与 Chinchilla 的指数),且在实际计算预算分配中表现出更高的鲁棒性。这一特性使得 小规模实验即可可靠预测大规模模型性能,为下一代模型训练的计算资源规划提供了更高效的框架。
行业影响
核心应用场景
Skaling law 主要面向大语言模型预训练的资源规划与精度外推,尤其适用于需要在有限算力下快速决策模型规模、数据配比的场景。典型落地环节包括:
- 预训练前的计算预算分配:在启动大规模训练前,仅用低算力区间(如总 FLOPs 的 1/10)的小规模实验即可拟合 Skaling 参数,准确预测全量训练下的损失表现。
- 数据需求规划:针对特定领域(如医疗、法律、金融)的垂直模型训练,帮助确定最小有效数据量,避免过度收集或标注。
- 多模态与混合训练:对于视觉 - 语言模型、代码生成模型等,其中不同模态数据量差异大,Skaling 的耦合形式能更稳定地预测损失曲面。
商业价值
- 直接降低试错成本:相较于均匀扫参(uniform sweep),稀疏网格 + Skaling 可节省约 10 倍计算量,使中小型 AI 团队也能进行可靠的 scaling 规划,而无需租用昂贵的大规模集群。
- 加速模型迭代周期:更准确的损失外推意味着更少的高代价误判,研发团队可在早期阶段锁定最优配比,缩短从实验到生产的周期,最终加快产品落地速度。
- 提升资源利用率:在多项目共享的 GPU 集群中,Skaling 可帮助平台调度器动态预估最佳 token 与参数比,减少“训练不足”或“过度训练”造成的资源浪费。
与现有工作流的集成
Skaling law 可作为一个轻量级性能预测模块嵌入现有 MLOps 管道:
- 实验设计阶段:在实验管理工具(如 Weights & Biases、MLflow)中内置 Skaling 拟合函数,根据少量 scouting runs 自动推荐下一步的(模型大小,数据量)组合。
- 训练监控阶段:在训练过程中持续对比实际 loss 与 Skaling 预测值,偏差过大时触发告警,提示数据质量或超参问题。
- AutoML / 神经架构搜索:替代传统的独立 scaling 假设,作为搜索空间中的约束项,使搜索过程更关注 compute-optimal 子空间。
具体落地案例
- 企业级 AI 客服平台:为一大型零售企业训练订单查询、退换货策略的定制 LLM。使用 Skaling 仅需在 7B 参数以下、数据量不超 50B tokens 的区间进行 5~8 个模型的试训,即可锁定 70B 模型所需的数据量,避免因数据不足导致上线后高误答率。
- 自动驾驶感知模型:训练统一处理图像、激光雷达点云和文本指令的多模态模型。Skaling 的耦合项能更好地描述视觉编码器容量与文本数据量之间的交互关系,帮助确定在给定的车载芯片算力约束下,最优的 visual encoder 尺寸与总训练 token 数,从而在嵌入式部署时不牺牲关键场景召回率。
局限
- 拟合交互指数需要额外的稀疏采样点,相对于标准缩放律的独立参数形式,增加了少量计算开销,且非线性优化的多峰性可能导致拟合不稳定,对初始化超参数敏感。
- 实验主要在标准 Transformer 语言模型架构和优化器设置下进行,耦合强度是否在不同模型家族、激活函数或训练策略下保持一致性尚未充分验证;此外,稀疏网格低计算外推到高计算区域的可靠性仍缺乏在数百亿参数规模下的实证检验。
- Skaling 假设模型容量与数据通过乘法项耦合,未探索更一般的交互形式(如加法或多项式项),在极数据稀缺或极度过训练边界可能仍存在系统性偏差,该形式的通用性边界尚未明确定义。