HarnessOpt-Bench: 评估LLMs在Harness优化上的表现
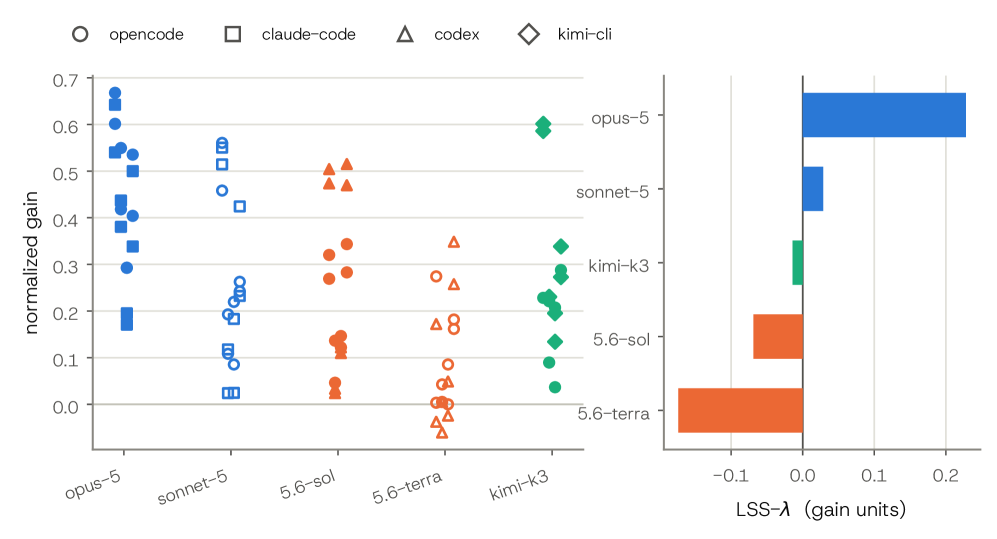
随着 LLMs 越来越多地部署在智能体系统中,其能力不仅取决于模型权重,还取决于 harness——即围绕它们的提示、工具、控制流、记忆和编排代码。这使得自动化 harness 优化(由 AI 系统对 harness 进行迭代、评估引导式的改进)成为提升 AI 系统的重要途径,同时也是对 AI 系统自身能力的严苛考验。然而,社区缺乏一个统一协议来衡量前沿 LLMs 在此任务上的表现。 我们提出 HarnessOpt-Bench,一个在昂贵且随机评估条件下进行端到端 harness 优化的基准。优化器(一个 LLM 配合编码 harness)接收目标智能体的种子 harness、分级评估反馈和固定的目标评估预算。它编辑 harness 并提名最终候选,候选者根据其在保留测试分区上的归一化增益获得评分,该分区在整个搜索过程中不可访问。可信执行环境 强制执行评估边界,计量目标智能体的资源使用,并保留候选版本以供审计。 我们在 4 个下游任务上,对 5 个前沿 LLM 作为优化器进行了评估,既在共享编码 harness 下,也在其原生 harness 下,共进行了 111 次有评分运行。实验结果表明: - 优化器模型之间的差异大于它们所借助的编码 harness; - 原生 harness 并非一致优于共享 harness; - 增益在不同任务和种子机制下差异显著。 这些结果确立了 harness 优化作为一项可测量、有区分度的能力,且仍有巨大的改进空间。
论文精读
TL;DR HarnessOpt-Bench 首次系统化衡量 LLM 优化智能体 harness 的能力,实验发现不同模型优化效果差异显著且存在巨大改进空间。
问题
问题背景
LLM 越来越多地作为 Agent 部署在复杂系统中,其表现不仅取决于模型权重,更严重依赖于外围 harness——即提示词模板、工具调用、控制流、记忆管理和编排代码。如何系统化地优化这些 harneess 已成为提升 AI 系统性能的关键焦点。
现有方法局限
当前 harneess 设计主要依赖人工试错与经验法则,缺乏自动化优化闭环。少量工作尝试自动优化,但大多只针对单一组件(如 prompt 优化),无法覆盖端到端的 full harneess。更重要的是,缺少统一基准来在不同优化器(例如不同 LLM 充当优化器)之间进行公平比较。由于真实环境下的 agent 评估成本高、结果随机性强,现有的优化方法往往在受控条件下测试,难以反映实际部署中的搜索效率和稳健性。
为什么这个问题难且重要
- 搜索空间巨大且离散:harness 组件涵盖自然语言、代码、工具选择等多个异构空间,难以应用连续优化或梯度方法。
- 目标函数昂贵且随机:每次评估都需要完整运行 agent 任务,消耗大量 token 或时间,且任务结果方差大,导致信号噪声比低。
- 强约束预算:现实场景下评估预算有限,优化器必须高效探索。 业界的关注度正在飙升,随着 agent 系统走向产品化,手工调参式 harneess 维护已不可持续,自动化 harneess 优化将成为 AI 工程栈中的核心能力,其战略地位可比肩 AutoML 对传统 ML 模型开发的影响。
行业类比
就像自动超参数调优(如 Optuna)或神经架构搜索(NAS)取代了手工调参,harness 优化旨在让 LLM 自身扮演系统工程师,动态搜索并编排最优的“外骨骼”逻辑,以最大化 agent 在目标场景下的作用。
核心洞察
- HarnessOpt-Bench 定义的评估协议引入“信任执行环境 + 留出测试分区 + 固定评估预算”,杜绝了优化过程中通过超量试探或窥探测试数据来虚假提升的作弊空间。与多数自动化优化基准允许无限次评估或访问测试集不同,该协议严格模拟真实场景下昂贵且随机的评估约束,迫使优化器必须在信息受限的条件下做出有效决策,因此更能反映模型在受限预算下的真实优化能力。
- 实验揭示优化器模型自身的能力差异远大于它们所使用的 coding harness 差异,且原生 harness 并不一致占优,这颠覆了“好工具链 = 好优化”的隐性假设。这意味着当前的自动化 harness 优化瓶颈在于模型的推理与策略生成能力,而非工具设计,为后续研究指明了应重点提升模型自身优化智能的方向,而非过度依赖定制化的编码环境。
方法
任务定义与输入
HarnessOpt-Bench 将 harness 优化 建模为一个受限的迭代搜索问题:给定一个目标 agent 的种子 harness(包含 prompts、tools、control flow、memory 与编排代码),优化器须在固定的评估预算内改进该 harness,输出最终候选版本。
关键模块:优化器与受信环境
优化器 (Optimizer) :一个 LLM 与一个编码 harness 配对。它在每一轮迭代中接收:
- 上一次候选的分级评估反馈(如正确率、延迟、资源消耗等),
- 种子 harness 的代码上下文,
- 剩余预算。
优化器据此编辑 harness 代码,并提交新候选。该过程循环直至预算耗尽,然后提名一个最终候选。
受信执行环境 (TEE) :所有评估在一个隔离的沙箱中运行,确保:
- 评估边界不可旁路;
- 目标 agent 资源用量(如 LLM 调用次数、执行时间)被精确计量;
- 候选版本完整保留以供审计。
这保证了优化过程的可复现性与公平性,防止优化器通过作弊手段(如访问测试集)获取不当收益。
评分协议与输出
最终候选在一个不可见的 held‑out 测试分区上评估,计算其相对于种子 harness 的归一化增益:
归一化增益 = (候选得分 - 种子得分) / (理论上界 - 种子得分)
其中“理论上界”为任务预定义的参考值(如理想正确率)。因此输出是一个标量分数,直观反映优化器带来的相对提升。
实验矩阵
- 优化器模型:5 个前沿 LLM 在共享编码 harness 和各自原生 harness(如 function calling、工具配置)下分别作为优化器运行。
- 下游任务:4 个不同领域的 agent 任务。
- 总运行:至少 111 次完整优化过程。
与同类工作的差异
不同于现有 prompt 优化或代码生成基准仅聚焦 prompt 调整或单步代码生成,HarnessOpt-Bench 将整个 agent 的“外骨骼”作为优化对象,要求优化器在成本受限、随机评价下进行多步版本迭代,更贴近真实生产环境中的 AI 系统调优。此乃首个系统化度量 LLM 在 harness 优化这一复合能力上的基准。
实验
实验设计
HarnessOpt-Bench 为评估 LLM 在 自动化 harness 优化 上的能力而设计。优化器(一个 LLM 搭配一个编码 harness)接收目标 agent 的 种子 harness、分级评估反馈 和固定的目标评估预算,通过迭代编辑 harness 并提名最终候选。最终得分采用在不可见的保留测试集上相对于种子的归一化增益(normalized gain)。实验评估了 5 款前沿 LLM 作为优化器,分别在 共享编码 harness 和它们各自的 原生 harness 下执行优化,覆盖 4 个下游任务,共进行 111 次评分运行。
关键发现
- 优化器模型比编码 harness 更具区分度:不同模型间的性能差异大于不同编码 harness 带来的差异,表明 harness 优化任务主要取决于优化器本身的推理与代码编辑能力。
- 原生 harness 并不总是更优:优化器在自己的原生 harness 下并未一致胜过统一共享 harness,提示当前 LLM 对自身运行环境的适应性仍有局限。
- 增益随任务和种子变化显著:某些任务或种子条件下优化器表现突出,但整体增益空间大,反映出 benchmark 具有高分辨力。
- 搜索行为与效率:更广泛的搜索(更多 explore-exploit 平衡)与更高增益相关,但读取 trace 并未带来额外收益;案例通过次数(而非评估调用次数)是约束优化效果的关键。可见验证分数常存在乐观偏差,需依赖隐藏测试集评估。
与基线对比解读
基线为未经优化的种子 harness,优化器需在固定预算内发现并实施有效修改。归一化增益成为核心指标,直接衡量优化器相对于原始基线的提升幅度。实验结果表明,自动化 harness 优化是一项可度量且具区分力的 AI 能力,当前最强模型仍有较大提升空间。这一设定与常见的模型中心式评估不同,它更接近真实 Agent 开发流程,为后续 AI 驱动的工程自动化研究提供了标准化协议。
行业影响
落地场景
自动化 harness 优化 直接服务于任何将 LLM 封装为 agent 或智能体系统 的产品线,例如 对话式 AI 客服、代码助手、数据分析 Copilot 以及 自主决策机器人。在这些场景中,提示模板、工具调用序列、记忆管理和控制流逻辑 的组合(即 harness)往往比基础模型权重更能决定最终表现。该基准为衡量和改进此类优化能力提供了标准化协议,可应用于 RAG 流水线调优、工具编排策略搜索 和 复杂任务拆解流程优化 等环节。
商业价值
通过将 人工反复试错的 prompt 工程与管道编排 替换为 预算约束下的 AI 驱动优化,企业可直接降低 高技能工程师的维护成本,并将新任务 or 新模型的部署周期从数周缩短到数小时。以客服系统为例,更高的一次解决率 直接提升客户满意度并减少人员介入;在代码助手场景中,更精准的工具选择与步骤规划 提升开发者产出,转化为 SaaS 产品的留存与付费转化率。优化的可审计性和版本追溯机制还降低了合规风险。
与现有产品/工作流的接口
HarnessOpt-Bench 的设计天然契合 MLOps 管线:优化器作为 元代理,可集成到 CI/CD 流水线中,在固定评估预算内迭代改进部署的 agent 配置,并通过 独立 test 分区 客观评估真实提升。它可以对接现有的 模型评估平台(如 Weights & Biases、MLflow),借助其跟踪和对比实验;提示管理层(如 LangSmith 或 PromptLayer)可作为候选 harness 的存储与回滚媒介。对于已使用 agent 框架(LangChain、AutoGen 等)的团队,只需将 seed harness 和评估器暴露给优化器,即可建立自动化优化循环。
具体落地用例
- 电商平台智能客服:某全球电商平台需要客服 agent 能灵活调用订单查询、退货、物流追踪等 API。优化器自动调整 prompt 中函数描述的顺序与措辞、多轮对话的压缩策略 以及 异常回复的兜底逻辑,在有限用户模拟评估次数内找到显著提升问题解决率的 harness 组合,减少客户流失。
- 企业级代码审查助手:一个 SaaS 代码审查工具集成 LLM agent 来生成 review 评论。优化器针对 从检索 repo 知识到生成建议的全链条(包括检索查询改写、证据融合 prompt、输出格式控制)进行搜索,在保持 review 质量的同时降低 token 消耗,直接改善产品的成本结构,并提升付费用户采纳率。
局限
- 论文承认优化增益在不同任务和种子设置下差异显著,且验证集分数偏乐观,说明当前基于 LLM 的优化器对初始种子质量敏感,评估反馈本身存在噪声,优化能力的稳健性不足。
- 实验仅涵盖 4 个下游任务与 5 个前沿模型,任务多样性有限,难以泛化到更复杂的真实 harness 优化场景。优化器受固定评估预算约束,且与贝叶斯优化、RL 等范式的对比缺失,限制了结论的外部有效性与方法论改进空间。
- 基准聚焦于优化器模型本身的区分度,但未深入分析 harness 组件(prompt、工具选择等)的具体改进模式,导致对失败模式理解不足。原生 harness 并非一致优于共享 harness,表明当前 LLM 利用自身工具链的能力尚未稳定,难以指导实用化优化策略。