PaDoc: 布局引导的并行解码用于文档解析
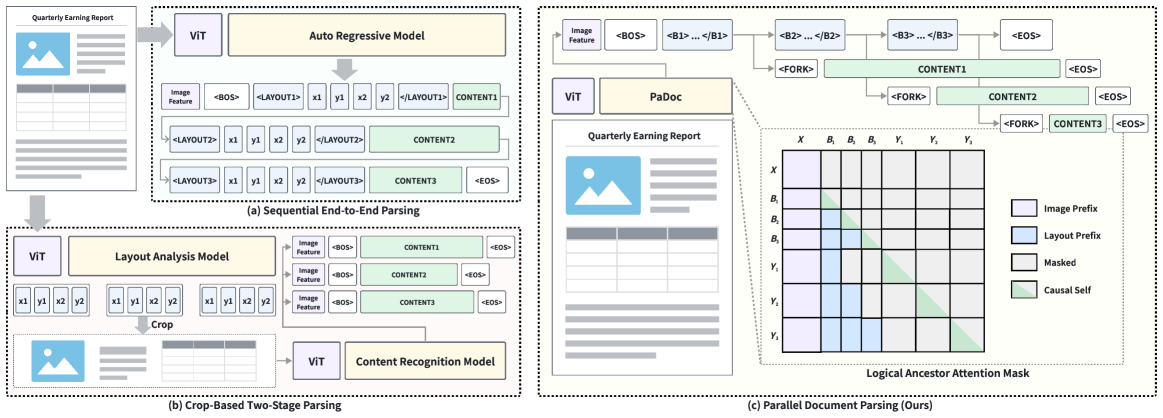
端到端文档解析器提供了统一接口,但将页面布局和区域内容序列化为一个自回归序列。这种设计迫使相互独立的区域处于同一解码路径,解码长度随总内容增长;而基于裁剪的两阶段解析器虽暴露区域级并行性,却需重复的视觉预填充和碎片化的页面上下文。 为在保留全页上下文的同时消除依赖,我们提出 PaDoc, 一种布局引导的解析器,将预测布局视为共享页面表示上的分支结构。在区域充分性假设下,我们推导出前缀条件因子分解,使布局流和区域内容分支并发推进,将解码深度缩减为最长布局-内容路径。我们在单个 MLLM 中实现该分解:打包的可变长度祖先注意力在标准 next-token 训练下保持可见性,而掩码并行解码创建分支,评估所用 vLLM 后端将其作为并发请求处理,并复用缓存中的共享前缀。 在 OmniDocBench Full 上,PaDoc 达到 Overall 布局 F1 91.1,在端到端解析器中取得 Overall 94.24 的顶级得分,同时获得最佳 Text Edit (0.038) 和 Formula CDM (95.59)。在 384 页子集和单张 A800 GPU 上,它在五个并发级别下均为最快的端到端解析器,相较同骨干的 Sequential SFT 基线,有效页面吞吐量提升 67.4%-118%,P95 延迟降低 39.2%-54.9%。
论文精读
TL;DR PaDoc 将文档布局建模为分支结构,在共享页面表征上实现布局与区域内容的并行解码,将串行解码深度缩短为最长路径,在保持顶尖精度的同时成为最快的端到端文档解析器,吞吐量翻倍、延迟减半。
问题
问题背景
文档解析(Document Parsing)正成为视觉语言模型(VLM)的关键下游任务,旨在从复杂版面的页面图像中提取结构化文本、表格、公式等元素。端到端多模态生成已被视为统一解决方案,但其序列化解码范式与页面内在并行结构之间存在根本矛盾。
现有方法局限
- 端到端自回归解析器(如基于 Transformer 的布局到序列模型)将页面所有区域按预定顺序拉平成单一 token 流,迫使独立区域共享同一条解码路径。这导致解码长度随总内容量线性膨胀,无法利用区域间的天然并行性。
- 两阶段方法(先检测区域,再对各区域单独识别)虽能并行处理区域,但需要为每个区域重复运行视觉编码器(Vision Encoder),造成大量冗余计算;同时,区域级裁剪丢失了跨区域的全局版面上下文,容易导致重叠区域和表格跨页断裂等语义错误。两种范式均未实现全局感知与并行推理的同步优化。
为何该问题重要与困难
文档页面天生具有结构化稀疏性:逻辑区块(段落、表格)空间独立但语义关联。技术挑战在于:如何在不破坏自回归训练范式的前提下,让单一多模态大模型以分支结构建模这种并存关系?这要求模型既能维持对完整页面的注意力覆盖,又能在推理时将区域内容解码解耦为并发流。此外,工业级文档解析对吞吐和延迟高度敏感(如发票识别、扫描件数字化),因此该问题的突破直接影响实际落地的经济可行性。
行业类比
如同视频理解中需同时处理多路相机流——独立分析各帧以加速,又必须维护全局场景上下文以防止动作误判——文档解析同样需要以共享前辍复用和布局引导并行来打破序列化瓶颈。
核心洞察
- **布局结构即并行解码的先验**。传统端到端文档解析器将整个页面序列化为单条自回归路径,导致区域内容被迫串行生成,解码深度随总 Token 数线性增长。PaDoc 首次将预测的布局树显式用作解码分支,在共享页面表示上同时推进布局流和各个区域的内容流。这种“结构即并行”的设计不同于两阶段裁剪方案(虽可并行但丢失全局上下文),也不同于在序列中插入分隔符的伪并行,它真正利用文档固有的区域独立性,将有效解码深度压缩为最长分支路径。
- **单模型内实现训练 - 推理一致的并行加速**。PaDoc 通过打包可变长度祖先注意力在标准 Next-Token 训练中保持跨区域可见性,不修改损失函数;推理时用掩码并行解码将各区域映射为独立请求,在 vLLM 中复用共享前缀缓存并发执行。这种方案避免了额外编排,训练与推理架构完全统一,为多模态大模型的高效长文档解析提供了即插即用的范式。
- **前缀条件分解将解码深度从总量缩减至瓶颈路径**。基于区域充分性假设,PaDoc 推导出前缀条件因子分解,使自回归解码的总步数不再由页面全部内容决定,而仅取决于最长的单区域生成路径。在 384 页子集上,这一分解配合共享前缀重用,使吞吐量提升 67.4–118%,P95 延迟下降 39.2–54.9%,验证了结构感知并行解码在真实长文档场景下的显著收益。
方法
输入
PaDoc 接收完整文档页面图像作为输入,目标是在单一前向过程中同时输出页面的布局结构与每个区域的内容(文本、公式、表格等)。与传统序列化方案不同,这里不将页面“压平”为单一自回归序列,而是将布局视为树形分支结构的根,各区域内容为并行分支。
关键模块
共享页面表示 (Shared Page Representation)
整个页面通过单次视觉编码获得全局上下文特征,所有区域分支共享该表示,避免裁剪式两阶段方法中重复的视觉 prefilling 和全页上下文割裂。前缀条件分解 (Prefix-Conditioned Factorization)
在区域充分性 (Region-Sufficiency) 假设下,全页生成概率被分解为:先预测布局(各区域坐标、类别),再并行解码每个区域的内容,且布局序列与所有区域内容分支在解码时并发推进。这使解码深度从所有区域内容串行总长度,缩减为最长布局-内容路径的长度,极大降低生成延迟。训练:紧凑变长祖先后代注意力 (Packed Variable-Length Ancestor Attention)
为了在标准 next-token 训练中保留分支间的正确可见性,PaDoc 设计了特殊的注意力掩码方案,允许每个 token 仅关注其祖先路径上的 token,同时将多条长短不一的序列打包成一个批次,实现高效训练。推理:掩码并行解码 (Masked Parallel Decoding)
推理时,布局分支生成后立即触发多个区域分支的并行生成。通过构造适当的注意力掩码,每条分支独立解码,且共享公共前缀(页面表示 + 布局序列)在 KV 缓存中只保存一份。利用 vLLM 后端,这些分支被实现为并发请求 (concurrent requests),自动复用缓存中的共享前缀,实现低延迟、高吞吐的并行推理。
输出
最终输出包含:页面布局(区域位置、类别)和每个区域的识别结果(文本、公式 LaTeX、表格 HTML 等),二者在语义上对齐,直接可用。
与同类方法的差异
相比裁剪后两阶段并行解析(因重复视觉编码、全页上下文丢失而牺牲精度),以及端到端序列化解析(因区域串行解码导致延迟与内容总量线性增长),PaDoc 是第一个在 单个 MLLM 内,通过布局分支实现全页上下文保留 + 区域并行解码的方法,在精度和推理吞吐上取得显著突破。
实验
实验设计
质量评估在 OmniDocBench Full 上全面进行,涵盖布局检测、文本编辑距离、公式识别等多个维度,与同期端到端解析器公平对比。推理效率则使用一个 384 页的内部子集,在单张 A800 GPU 上以 vLLM 并发服务 测量 5 个不同并发级别下的有效页吞吐与 P95 延迟,基线为相同 backbone 的 Sequential SFT 模型。
关键发现
- 质量与效率双优:PaDoc 取得 91.1 的 Overall Layout F1 和 94.24 的 Overall Score,在端到端解析器中位列第一梯队;同时,Text Edit (0.038) 与 Formula CDM (95.59) 均为所有对比模型中的最佳。
- 推理速度大幅领先:相比 Sequential SFT,有效页吞吐提升 67.4%–118%,P95 延迟降低 39.2%–54.9%,且随着并发度增加优势更明显,这源于 共享前缀的 cache 复用 与 分支并行解码 对解码深度的压缩。
与基线的深度对比
传统序列化解码将独立区域的内容串行生成,解码长度与总内容量成正比,而 PaDoc 将预测布局视为共享页面表示上的分支结构,在 region-sufficiency 假设下推导出前缀条件分解,使布局流与各区域内容分支并发推进。这一设计同时保留了全页上下文(避免 crop-based 两阶段方法的重访视和碎片化)并消除了区域间的串行依赖,在实际服务中通过 packed variable-length ancestor attention 保持训练兼容性,并通过 masked parallel decoding 实现高效推理。与相同 backbone 的串行基线相比,PaDoc 不仅在长文档上显著缩减了解码步数,还将理论加速比成功转化为实际吞吐和延迟的提升,展现了结构化并行在文档多模态生成中的工程可行性。
行业影响
落地场景
PaDoc 面向复杂页面文档的端到端结构化解析,可直接嵌入需要高吞吐、低延迟的智能文档处理(IDP)系统。典型场景包括:在线合同审核、发票与表单自动录入、学术论文与教科书内容抽取、医疗报告数字化、金融合规文件解析等。任何需从混合布局(文本、表格、公式、图片)中实时提取信息的 AI 产品均可受益,特别是对 全页上下文 依赖性强的任务,如跨栏表格识别、多区域逻辑关系抽取。
商业价值
- 算力降本:相比顺序自回归基线,PaDoc 在相同 GPU 上将有效页吞吐提升 67.4–118%,直接降低每页服务成本,对大规模文档处理服务(如云 API 调用)经济效益显著。
- 体验升级:P95 延迟下降 39.2–54.9%,使实时交互式文档问答、即拍即搜等 C 端场景成为可能,减少用户等待,提升留存与付费意愿。
- 维护简化:端到端单模型替代传统“布局检测 + 区域识别”多模型流水线,减少版本迭代与运维复杂度,同时保留与顺序解析模型同等的精度(Overall score 94.24,端到端模型中 Text Edit 最优),避免精度折损。
与现有产品/工作流的接口
PaDoc 作为 MLLM 可直接融入现有 vLLM 推理服务栈,利用其 共享前缀缓存 与 并发请求调度 实现并行解码。部署时以标准 REST API 暴露文档解析端点,接收图像输入,返回结构化 JSON(含布局框、文本行、公式 LaTeX)。企业可将其替换现有管线中的顺序解码模块,或与 OCR 引擎、后处理规则结合,作为文档智能流水线的核心解析层。模型支持标准 next-token 训练范式,可基于现有大模型底座快速微调适配垂类文档。
具体落地 Use Case
- 电商平台智能发票核验:大促期间海量用户上传发票图片,PaDoc 并行解码特性可在单 GPU 上支撑更多并发,实时提取商品明细、金额、税号等,直接对接到 ERP 系统,缩短报销周期。低延迟保障用户端反馈秒级完成,避免超时流失。
- 法律科技合同关键要素抽取:处理数十页 PDF 合同时,传统 crop-based 方法割裂页面导致跨段落条款识别错误率高;PaDoc 全页输入端到端解析,准确提取甲乙方、金额、期限等要素,并维持上下文一致性,减少人工复核成本,支撑合同比对、风险预警等高级功能。
局限
- **区域充分性假设可能限制跨区域依赖建模**。PaDoc 的核心推导建立在“区域内容生成仅依赖共享前缀和自身,不依赖其他区域”的假设之上,这忽略了文档中常见的跨区域引用(例如正文引用图注、表格注释),以及表格与文本区域间的语义对齐。当文档布局具有强跨区域约束时,模型可能生成不一致的内容,影响解析质量。该假设在真实复杂文档上的适用边界尚未被充分验证,可能成为进一步提升性能的瓶颈。
- **布局错误传播与系统实现复杂度**。方法将解码分解为布局分支与区域内容分支并发执行,若布局预测(尤其是区域边界或跨页关系)出现错误,会直接导致内容分支的条件失效,且由于并发调度缺乏分支间的矫正机制,错误难以在推理中修正。此外,训练需定制 packed variable-length ancestor attention 与对应的掩码策略,推理依赖 vLLM 的请求级并发与缓存共享,整体训练和部署管线比常规 seq2seq 模型更为复杂,增加了复现和工程维护成本。
- **实验规模的局限性**。文章仅在 OmniDocBench 数据集和单卡 A800 GPU 上验证了性能与效率,未展示在多卡/多节点环境下的扩展性,也未在更大规模、更多样化的文档数据集(如 PDF 多语言混合、长文档等)上进行评估。速度提升指标(有效页面吞吐量提升 67.4–118%)虽然显著,但受限于并发级别和测试集规模(384 页子集),其结论的普适性有待更大规模真实服务场景的检验。