转型中的持续学习
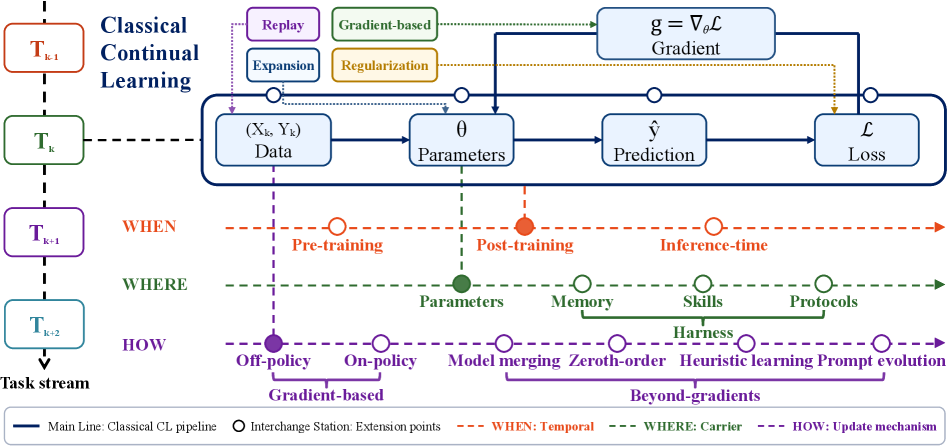
经典持续学习(CL)主要依赖于参数中心机制(如训练策略、架构设计、权重适应)来更新和保留知识。然而,新兴范式正在重塑CL的边界,从传统模型适应视角扩展为更广泛的系统级适应。例如,on-policy学习 拓宽了更新机制的范畴;test-time training 将CL从训练阶段延伸至推理阶段;而外部组件(如 memory、skill libraries、interaction protocols)将模型能力演化范围推进到静态参数空间之外。这些发展共同标志着从参数中心学习向系统级适应的转型。 为了刻画这一转型,我们提出了一个三轴框架,从三个维度审视持续学习的演化:When(学习发生在何时)、How(如何学习)、Where(在何处更新)。其中,How 维度涵盖 off-policy、on-policy 以及 beyond-gradient 等优化机制;When 维度捕捉从预训练、后训练到推理阶段的演化;Where 维度则区分内部参数更新与外部结构约束。借助这一框架,我们系统梳理了代表性方法,追踪持续学习的转型路径,并探讨了该范式转变带来的关键挑战、深远影响与未来发展方向。
论文精读
TL;DR 经典持续学习聚焦参数更新,本文揭示其正从参数中心转向系统级适应,并以“何时、如何、何处”三维框架梳理了这一范式迁移。
问题
问题背景
当前持续学习 (Continual Learning, CL) 领域主要关注模型在动态数据流中更新并保留知识的能力,传统研究核心围绕参数空间的调整机制,如正则化、架构扩展和回放策略。
现有方法的局限
经典 CL 方法普遍基于三个隐式假设:
- 更新发生在训练阶段,推理时模型固定;
- 知识载体仅限于模型参数,忽略外部工具与记忆;
- 优化依赖梯度下降,难以适应策略性交互或非梯度信号。
这些假设限制了模型在全生命周期内的演化能力。例如:
- 推理时遇到分布外数据无法即时适应(test-time training 缺失);
- 长周期任务中,无法像智能体一样通过调用记忆库、技能库来累积经验,仅靠参数微调易导致灾难性遗忘。
- 多维协调如 LLM + 检索增强、工具调用等场景下,参数更新与外部组件更新的耦合问题未被系统性解决。
技术挑战与重要性
从参数中心向系统级适应的转变,要求同时考虑三维度:
- When:预训练 → 后训练 → 推理时,各阶段如何协作优化;
- Where:内部参数(parameter)与外部工具(harness,如记忆、技能库、交互协议)如何协同承载能力;
- How:从离策略(off-policy)梯度到在策略(on-policy)学习,甚至无梯度更新机制,如何整合。
这一框架对构建长周期自演进智能体至关重要,业界因 LLM 与 Agent 的兴起而高度关注——仅靠静态参数无法应对复杂开放环境,系统需像生物体一样在不同时间尺度、不同组件上持续吸收、重组知识。
行业类比
类似自动驾驶系统(Autonomous Driving)需要在线学习新路况又必须保持基本安全约束,同时融合高精地图(外部记忆)与实时感知,这正是 CL 从参数更新走向系统协同演化的缩影。
核心洞察
- 论文重新审视持续学习的边界,指出从以参数为中心的学习到系统级适应的转型正成为趋势。相比经典方法专注于模型权重更新,新兴范式将外部记忆、技能库、推理时训练等 harness 组件纳入学习范围,使得能力的持续演化不再局限于参数空间,从而为长期开放场景下的自适应 Agent 提供了新的架构思路。
- 作者提出的 When-How-Where 三维分析框架为持续学习方法提供了超越传统分类的系统化图谱。该框架分别从模型生命周期阶段、更新机制类型和更新发生位置三个正交维度进行刻画,不仅覆盖了现有方法,还清晰揭示了研究空白,例如推理时无梯度更新的 harness 层面学习,这对于设计下一代持续学习系统具有指导意义。
- 论文强调从 off-policy 到 on-policy 再到超越梯度的学习演进,反映了持续学习正从离线数据回放向在线交互式学习转变。这一视角突显了在具身智能、长期 Agent 等应用中,模型需要在与环境实时交互中更新能力,而不仅是事后利用历史数据,这种动态更新方式对算力效率和遗忘缓解提出了新的挑战与机遇。
方法
论文提出了一个三维分析框架,用于系统化地审视持续学习从参数中心向系统级适应的转型。该框架的输入是经典持续学习隐含的三个假设(模型内部参数是知识唯一载体、学习仅发生在独立训练阶段、更新基于离策略梯度),将其转化为三个核心问题:何时学(When)、何地学(Where)、如何学(How)。
框架核心模块
When 维度:将能力演化延伸至模型的全生命周期,包括预训练、后训练(微调/对齐)和推理阶段。突破了传统仅关注训练阶段更新的局限,纳入了测试时训练等新兴范式。
Where 维度:明确知识载体的二元性:
- 参数载体(Parametric Carrier):模型权重等内部参数。
- 外部装备层(Harness Layer):包括记忆模块、技能库、交互协议等外部结构约束,它们为模型提供了参数空间之外的演化边界。
How 维度:扩展了更新机制的光谱:
- 离策略更新(Off-Policy):基于静态数据集的梯度优化。
- 同策略更新(On-Policy):从环境交互的新经验中学习。
- 超越梯度的学习:如启发式更新、基于检索或规则的非梯度方法。
通过对三个维度的交叉组合,生成跨维度方法画像(Cross-Dimensional Method Profiles),将现有持续学习方法映射到该空间中。输出是对代表性工作的系统分类,揭示了从参数孤立优化转向协调参数、记忆、技能与协议的系统级持续学习趋势。
与同类综述的差异
不同于以往按克服灾难性遗忘的技术手段(正则化、回放、参数隔离)进行分类,该框架从“学习发生的时机、地点与方式”这一根本性视角重构持续学习,更能捕捉大模型时代装备增强与终身代理等新范式。
实验
本文是一篇调查综述,旨在梳理持续学习领域正经历的范式转移。作者提出了一个三维框架:When(预训练、后训练、推理时)、How(off-policy、on-policy、超越梯度的优化)、Where(模型参数、外部 harness 组件)。在此框架下,作者系统性地审视了代表性方法,并构建了跨维度方法画像,展示不同方法在何时、何地、如何更新上的分布。
主要发现包括:从以参数为中心的学习正向系统级自适应演进;外部 harness(如记忆、技能库、交互协议)扩展了模型能力进化边界;推理时训练和 on-policy 学习打破了传统训练阶段的限制;现有方法在坐标轴上呈现多簇聚集,揭示了当前研究的空白区域。与经典分类法对比,该框架更强调系统视角,将 LLM 时代的新范式纳入,指出来自更长上下文、持久能力、长期智能体的需求将促使持续学习成为迈向 AGI 的关键议题。实验部分未涉及新模型训练,而是通过方法维度映射提供未来研究的路线图。
行业影响
落地场景
持续学习(CL)从参数更新范式向系统级适应的演进,为需要持续演化能力的 AI 产品打开新空间。典型场景包括:
- 智能客服与对话 Agent:利用外部记忆与技能库(harness)持续积累领域知识,无需全量重训即可应对新增产品线或政策变更,避免灾难性遗忘。
- 个性化推荐与电商:用户兴趣漂移时,通过 on-policy 学习在线融合实时反馈,同时借助外部记忆保持长期偏好,减少离线全量更新的延迟与成本。
- 自动驾驶感知:面对长尾场景(如罕见天气、异形障碍物),可在推理时(test-time training)即时适应,并通过 harness 组件将试探性知识转化为可复用的结构化经验。
- 金融风控与反欺诈:在交易流中持续学习新型欺诈模式,利用梯度自由更新机制(如启发式规则调整)快速响应,同时保持对历史欺诈类型的识别能力。
商业价值
- 降本:系统级 CL 避免每次数据或任务变更时重新训练大模型,显著降低算力与标注开销。通过 harness 层积累可复用的技能模块,新任务只需轻量组装,减少 ML 工程师介入。
- 增效:on-policy 与推理时学习使模型能够无缝响应环境变化,提升任务成功率(如客服解决率、推荐点击率),缩短模型迭代周期。
- 体验提升:持久记忆与持续个性化为用户提供连贯体验(如对话 Agent 记住用户偏好),避免“每次重启”的生硬感,增强用户粘性。
与现有产品/工作流的接口
现有 ML 基础设施围绕离线训练-在线推理构建。集成系统级 CL 需要:
- 数据流层面:引入实时反馈采集管道,将用户交互、环境信号转化为持续学习的流式样本,对接 Kafka/Flink 等消息系统。
- 模型治理:在 MLOps 中增加模型版本与外部组件(记忆库、技能索引)的联合管理,使用特征存储或向量数据库(如 Milvus)作为 harness 的记忆载体。
- 推理架构:改造推理服务支持动态加载/更新外部模块(如 adapter 或技能描述),同时保留回滚与 A/B 测试能力,以适应 on-policy 更新的不确定性。
具体落地用例
- 电商对话推荐 Agent:在用户多轮对话中,Agent 利用 on-policy 学习实时调整推荐策略,同时将成功推荐的逻辑与用户反馈写入外部技能库。新商品上线时,仅需更新对应技能条目,无需重训模型,推理时通过检索增强生成(RAG)调用。此方案使推荐更新延迟从天级降至分钟级,并提高长对话的生命周期价值。
- 医疗影像辅助诊断:部署的模型通过 test-time training 在推理时适应新设备/染色协议的分布漂移,并将适应产生的参数偏移存储于外部 harness。当相似漂移再次出现时,快速激活对应补偿模块,避免遗忘原有常见病种的诊断能力,兼顾准确率与部署灵活性。
局限
- 作为综述,本文未提供任何实验验证或定量比较,仅依据三维框架对现有方法进行归类。这使得工程实践者无法从文中获取不同持续学习策略在具体任务上的性能基准或消融分析,也难以直接判断在给定场景下应优先采用哪一类更新机制或架构设计。框架的实用性受到限制,例如“Harness Layer”的概念仍较模糊,缺少形式化定义和指标来衡量外部约束的容量与效率。
- 三维框架虽整合了 When、How、Where 三个视角,但各维度之间的相互作用未被系统分析。例如,在推理阶段采用 on-policy 更新同时需要外部记忆库支持时,可能产生计算开销与灾难性遗忘的复合效应,文章并未揭示此类跨维度协同或冲突的内在机制。这导致分类本身较为静态,难以指导实际系统实现长期自适应的动态协调。