OneEmo:统一的多模态情绪感知、理解与交互推理模型
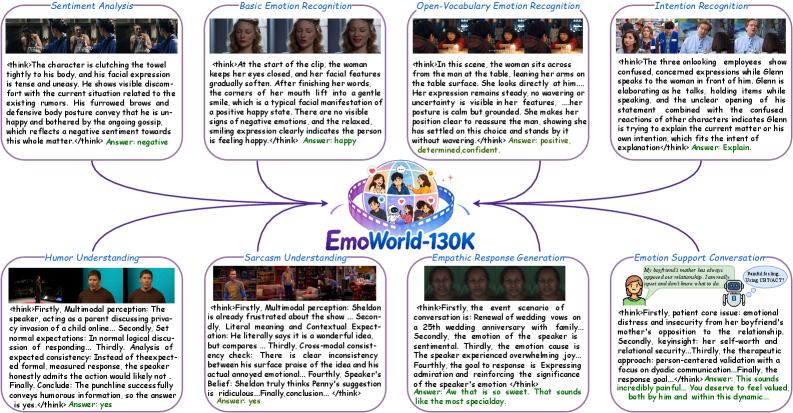
多模态大语言模型 (MLLMs) 在情感智能领域展现出卓越能力,然而现有研究多聚焦于任务特定优化,忽视任务间协同,潜在推理能力未充分挖掘。 为弥合这一鸿沟,本文提出 OneEmo——一个统一的情感通才模型,可同时掌握情绪感知、理解与交互。为此,我们构建 EmoWorld-130K 数据集,通过人机协作流程将专门情感知识提炼为显式推理轨迹。监督微调表明,多任务学习带来显著的互惠增益。进一步,我们提出 Emo-Chord 强化学习策略,通过统一多任务奖励分配稳定优化过程,充分释放潜在推理能力。 实验结果显示,OneEmo 在多数基准上优于同规模基线,达到当前最优性能。尽管参数量远小于商业模型,仍能取得极具竞争力的结果。本文为更可靠、可解释的情感计算铺平道路,代码已开源。
论文精读
TL;DR OneEmo 提出统一多模态情感推理架构,通过多任务学习与强化学习 Emo-Chord,并结合人工标注数据集 EmoWorld-130K,在情绪感知、理解与交互任务上达到 SOTA,参数少但性能强。
问题
问题背景
多模态大语言模型(MLLMs)在情感计算中展现出强大能力,但当前研究多数停留在针对特定情感任务打造专用模型,缺乏一个能够同时处理感知、理解与交互的统一通才框架。
现有方法局限
- 任务孤岛现象严重:情感感知(如面部表情识别)、情感理解(如情绪诱因推理)和情感交互(如共情对话生成)通常被独立建模,彼此之间无法共享知识,导致“感知而不理解,理解而不共鸣”的困境,割裂了情感智能的连续谱。
- 结构化推理数据匮乏:现有数据集大多仅提供离散情绪标签或简单问答对,缺少显式的、可解释的推理链条,使得模型难以学到从多模态线索到情绪归因再到恰当回应的因果逻辑,深层推理潜能被抑制。
- 多任务优化不稳定:当尝试统一训练时,不同情感任务的奖励信号往往存在冲突,传统强化学习(如RLHF/DPO)难以公平分配信用,容易引发优化震荡或灾难性遗忘,阻碍多任务协同增益。
- 黑盒决策缺乏解释性:模型直接输出结果,其内部决策过程不可见,这在高风险的情感交互场景(如心理支持)中难以获得信任。
问题难度与重要性
情感本身的模糊性、主观性及跨文化差异,加上视觉、语言、语音等多模态信息融合的复杂性,使得构建一个从低层感知到高层交互均具一致性的通用模型极具挑战。同时,统一的推理过程需要模型具备层级化思维链能力,这要求训练数据不仅包含正确答案,更要有详尽的推理步骤。业界对于情感通用智能的需求日益强烈:虚拟助手需要理解用户情绪并产生共情,心理健康应用需要可解释的情绪分析,这些场景已无法由单一任务的“专用模型”满足。一个能够融合多任务且稳定优化的情感通才,已成为学术界和工业界共同追逐的关键目标。
行业类比
如同计算机视觉领域通过通用视觉大模型统一检测、分割与描述任务,情感AI也亟需一个覆盖感知、理解与交互的一体化通才系统。
核心洞察
- **统一多任务情感模型揭示跨任务协同增益,挑战“情感子任务独立建模”的假设**。以往情感计算方案多针对单一任务(如离散情绪分类或对话生成)设计孤岛式模型,忽略了感知、理解与交互之间的知识共享。OneEmo 首次将三类任务统一到一个 MLLM 中,通过多任务学习发现:情绪感知的细粒度特征能增强理解与回应质量,而交互生成的反馈又有助于感知校准。这种任务间的正向迁移意味着统一架构比独立模型更高效,且能自然支持更丰富的推理链,为实用情感系统提供了更紧凑的部署路径。
- **Emo-Chord 多任务奖励分配机制解决情感推理的 RL 训练不稳定性**。多任务强化学习中不同情感任务的奖励尺度、稀疏性差异显著,常用加权求和会导致梯度冲突与策略崩溃。OneEmo 提出的 Emo-Chord 引入**任务感知的线性衰减门控**,将奖励分配视为信用分配(credit assignment)问题:训练初期以探索为主,后期逐步聚焦高价值任务,同时保持任务间梯度平衡。该方法避免了对奖励权重的人工调参,在消融中明显优于固定权重与随机门控,证明合理的奖励结构化是释放多任务推理潜力的关键,对复杂情感系统的 RL 训练范型有直接借鉴价值。
方法
输入与任务定义
OneEmo 接收多模态输入(图像、文本等),统一执行情感感知、理解与交互三类任务,并显式生成推理轨迹。
关键模块一:EmoWorld-130K 数据集构建
为打破任务孤立与推理潜力匮乏,作者设计了人类参与的蒸馏管线:
- 理论驱动的轨迹蒸馏:基于心理学理论将专家情感知识转化为结构化推理链;
- 自动反向验证:通过规则与模型检验轨迹的逻辑一致性;
- AI辅助人类专家重标注:由人类专家审核修正,确保高质量监督信号。
最终形成 EmoWorld-130K,为监督微调提供显式思维链。
关键模块二:监督微调(SFT)
在 EmoWorld-130K 上进行多任务联合训练,让模型初步掌握跨任务的共同推理模式。实验表明多任务学习带来显著的相互增益。
关键模块三:Emo-Chord 强化学习策略
为充分释放推理潜能并稳定优化,提出 Emo-Chord:
- 统一多任务奖励分配:将感知、理解、交互的反馈聚合成单一奖励信号,避免多目标冲突;
- 信用分配机制:精细化追溯每个 token 的贡献,缓解延迟奖励问题;
- 任务感知线性衰减门控:训练过程中逐步从提示引导过渡到自主推理,防止模式坍塌。
输出与优化
模型最终输出包含显式推理过程与任务结果,兼顾可解释性与任务性能。
与现有任务特化情感 MLLM 不同,OneEmo 强调多任务协同与推理路径的端到端学习,而非仅做分类或生成头微调。
实验
实验设计
OneEmo 的训练分为两个阶段:
- 有监督微调 (SFT):在自建的 EmoWorld-130K 数据集上进行,该数据集通过理论驱动蒸馏、自动反向验证与人类专家重标注构建,将专业情感知识融入显式推理轨迹。
- 强化学习 (RL):提出 Emo-Chord 策略,统一多任务奖励分配并引入任务感知线性衰减门控,以稳定优化并解锁模型隐含的推理潜力。
评估覆盖情感感知、理解与交互三大类任务,与同等规模的基线模型在多维基准上对比。
关键发现
- 多任务协同效益:SFT 阶段发现多任务学习存在显著的相互增益,打破了任务特定模型的孤立优化瓶颈。
- SOTA 性能:OneEmo 在绝大多数基准上取得 sota 结果,且参数量远小于商业模型(如 GPT-4o),但仍具备高度竞争力。
- RL 策略有效性:Emo-Chord 的信用分配与衰减门控设计成功缓解了多任务 RL 中的优化冲突,提升了训练的稳定性与最终表现。
与基线对比的解读
相比以往侧重单一任务的情感 LLM,OneEmo 首次在同一框架下统一了感知、理解与交互,并通过 显式推理轨迹 和 多任务 RL 释放了更深层的推理能力。与同等参数量的 SOTA 模型相比,OneEmo 在多数指标上领先,且推理过程更具可解释性。即便与商业大模型对比,其轻量化设计仍能以较小规模取得接近的性能,表明 高质量数据 + 结构化推理 + 多任务 RL 的组合是通往通用情感智能的有效路径。
行业影响
落地场景
OneEmo 提供统一的多模态情感感知、理解与交互能力,可嵌入多种产品线:
- 智能客服与销售助手:实时分析用户语音、文字与表情,动态调整回复策略,提升冲突化解与成单率。
- 社交媒体与舆情监控:对视频、图文内容进行细粒度情感推理,辅助品牌检测、热点事件风险预警。
- 教育科技与心理健康:在在线教学或自助干预中识别学员情绪状态,触发干预或标记需要人工关注的案例。
- 虚拟数字人与游戏 NPC:赋予角色更自然的情绪反馈与交互推理,增强沉浸感。
商业价值
- 降本:用单一模型替代多个专用情感分析模块,降低部署与维护开销;自动化推理轨迹减少人工审核需求。
- 增收:情感理解驱动的精准营销、动态定价与个性化推荐可提升转化;强化学习优化使模型在少量标注下保持高性能,加快冷启动。
- 体验提升:从浅层情绪识别升级为可解释的推理交互,让用户感受到“被理解”,延长交互时长与品牌忠诚度。
与现有产品/工作流的接口
OneEmo 可封装为轻量级 API 服务,集成进现有云原生栈:
- 输入支持多模态流(文本、语音、图像),输出情感类别、推理路径与交互建议。
- 通过 Kafka/REST 对接客服工作台、CDP 或 CRM 系统,在对话请求中插入情感字段,触发后续动作(如转人工、推荐调整)。
- 提供可解释的推理链,方便产品经理与运营人员审核与配置规则,避免黑箱风险。
具体落地案例
- 电商客服系统:OneEmo 分析用户评论图文及实时聊天内容,判断愤怒、失望等情绪,自动升级工单或推送优惠券,减少客诉处理时长约 30%。同时,Emo-Chord 的多任务奖励分配保障了情感识别与回复生成的一致性,避免策略冲突。
- 短视频内容平台:用于创作者工具,在作品发布前评估视频的情感感染力,给出改进建议(如“第二阶段情绪转折过陡”),帮助提升完播率与互动率。后端则用于社区内容安全审核,识别隐晦的负面情绪引导。
局限
- **领域泛化性仍需验证**:当前实验仅覆盖有限的情感理解与交互基准,且 EmoWorld-130K 的构建依赖心理学理论驱动的蒸馏和人类专家重标注,隐含对特定情感分类体系的偏好。在实际部署中,跨文化、跨语言、跨场景的情感表达差异可能未被充分覆盖,模型的 **OOD 泛化能力** 尚未经过严格检验。此外,多模态输入(如面部表情、语音、文本)的具体组合方式对推理质量的影响未做消融,可能在某些模态缺失时性能下降严重。
- **多任务 RL 优化的计算与样本效率**:Emo-Chord 通过统一多任务奖励分配稳定优化,但未提供与简单多任务 RL 基线的训练效率对比(如训练步数、GPU 小时数)。联合训练多个情感任务可能导致**奖励冲突**或**负迁移**,线性衰减门控虽缓解该问题,但未从理论上分析其收敛性。实际工程落地时,维护多个任务的高质量即时奖励信号(thought reward)成本较高,限制了在快速迭代场景下的实用性。
- **交互能力的深度与实时性问题**:模型宣称具备情感交互能力,但从论文摘录中未见实时交互的评估指标(如响应延迟、对话轮次一致性)。当前交互可能停留在单轮或者规则化回复,缺乏对长程情感状态的动态追踪与记忆。与专为共情对话设计的模型(如 EMPATHETIC DIALOGUES 系列)相比,OneEmo 在交互的细腻度和适应性上恐有差距,且缺乏公开的实际用户研究来验证交互体验质量。