On-Policy Delta Distillation 用于多语言数学推理
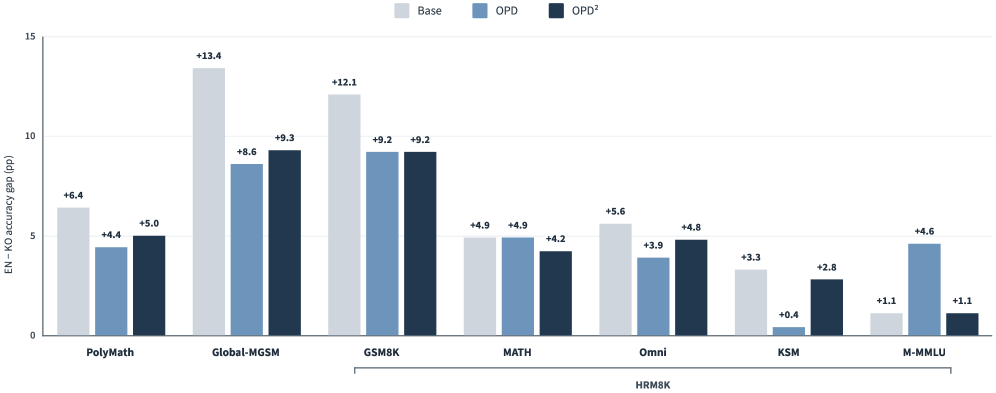
On-Policy Distillation (OPD) 正成为 LLM 后训练中强化学习的一种有前景的替代方案,但其在多语言环境中的有效性仍未得到充分探索。我们研究了 OPD 及其高级变体 On-Policy Delta Distillation (OPD^2),用于英语、韩语和日语的数学推理。 OPD^2 通过使用后训练教师模型与其基础模型之间的概率差作为学习信号,改进了 OPD。 使用 Qwen3 进行的实验表明,OPD^2 始终优于原始 OPD,尤其在韩语和日语中提升显著,并普遍缩小了英语-韩语的性能差距。 我们进一步发现,仅使用英语的 OPD 也能提高韩语和日语的性能,但往往会使回应偏向英语,这凸显了多语言数据对于保留目标语言回应的重要性。
论文精读
TL;DR OPD^2 将教师模型与基模型的概率差作为学习信号,在多语言数学推理中显著优于 OPD,尤其提升韩语/日语性能并缩小英韩差距,同时证明多语言训练对保持目标语言输出至关重要。
问题
问题背景
大型语言模型(LLM)后训练中,强化学习(RL)因使用序列级监督收敛效率低,On-Policy Distillation(OPD)凭借 token 级概率反馈正成为高效替代方案。但OPD在多语言推理任务,尤其是数学推理中的效果仍缺乏系统研究。
现有方法局限
传统 OPD 以教师与学生 logit 概率差作为学习信号,难以剥离教师知识中源自基模型的先验部分。OPD^2(On-Policy Delta Distillation)引入教师与基模型的概率差(delta 信号),在英语推理上显著优于原始OPD。然而,在多语言场景下,OPD/OPD^2面临:
- 跨语言推理迁移不稳定:不同语言的推理表现差异大,英语远高于其他语言。
- 语言输出漂移:仅使用英语数据做 OPD 虽能提升多语推理准确率,却导致生成文本转向英语,丧失目标语言特性。
为什么难/重要
数学推理依赖符号和逻辑链,多语言环境中还需处理语言特定的表达与对齐。OPD的 token 级监督不仅要捕捉推理步骤正确性,还需保持生成语言的一致性,仅靠数据混合难以解决。在全球化 AI 应用中,实现跨语言推理迁移且维持单语输出质量,是低成本扩展模型能力的关键瓶颈,直接关系到用户体验与部署成本。
行业类比
类似跨语言迁移微调在机器翻译中的困境:用大量英语数据增强多语言模型,若不施加语言约束,系统倾向输出主语言译文,需额外控制系统来保持目标语种,这与 OPD^2 在多语言数学推理中的挑战本质相同。
核心洞察
- OPD^2 的 Delta 信号通过取教师与基础模型的概率差,剥离了基础模型固有的语言与常识先验,使学生模型专注于学习教师独有的推理决策模式。与传统 OPD 直接拟合教师分布不同,这种差分机制迫使模型关注因后训练新增的推理能力,而非重复已有的 token 偏好。在多语言场景中,基础模型对不同语言的 token 分布存在偏差,OPD^2 能有效剔除这种语言特异性噪声,从而更好地泛化到韩语和日语等非英语推理任务,从原理上解释了为何 OPD^2 在多语言下提升幅度更大,且能缩小英韩性能差距。
- 英文-only 蒸馏实验揭示了一个重要现象:模型虽然能将数学推理能力跨语言迁移,但回答趋于英语化,产生语言漂移。这证明在蒸馏过程中,任务能力与语言生成能力是紧密耦合的,仅靠单语微调无法保证目标语言的输出一致性。从工程角度看,这一发现强调了多语言数据在模型后训练中的不可替代性——即使任务能力可迁移,保留正确的语言响应仍需显式的多语言监督。对于需要在多语言环境下部署系统的团队,必须平衡任务性能与语言保持,避免牺牲用户体验的语言一致性。
方法
OPD² 方法流程
输入:多语种数学问题(英文、韩文、日文),学生模型(待微调的小模型)根据问题 采样生成 一条完整回答(rollout)。
关键模块:
- 教师信号构造:将学生生成的 rollout 同时送入经过数学推理后训练的教师模型和其对应的基础模型,分别获取每个 token 的生成概率
P_teacher与P_base。 - Delta 信号计算:对每个 token,用概率差
Δ = P_teacher - P_base作为学习目标。该差值滤除了基础模型中已包含的通用语言能力,仅保留教师通过后训练获得的推理增量。 - 蒸馏损失:学生模型在该 rollout 上的 token 概率分布被约束去逼近 Delta 信号,通常通过最小化 Kullback-Leibler (KL) 散度实现,即让学生模仿教师的“推理增益”而非绝对分布。
- 多语言训练:训练数据包含同等数量的英文、韩文和日文数学问题,确保学生模型在多语言下的推理能力均衡提升。
输出:更新后的学生模型,具备在多语种数学推理任务上生成高质量回答的能力。
与同类方法的差异:原始 On-Policy Distillation (OPD) 直接使用教师与学生概率的差异,而 OPD² 将蒸馏目标从“模仿教师”变为“学习教师的微调所得” ,有效解耦了通用语言建模与任务特定能力,使学生在保留自身语言风格的同时更高效地获取推理技能。
实验
实验设计
- 模型:Qwen3 系列(1.7B, 8B)
- 任务:多语言数学推理,涵盖 英语、韩语、日语
- 对比方法:OPD vs OPD^2,以及仅英语训练的 OPD
- 评估指标:未明确提供(推测为准确率)
- 训练数据:多语言数学指令数据与教师模型 rollout
关键发现
- OPD^2 全面优于 OPD:在所有语言上均取得性能提升,韩语和日语提升尤为显著。
- 缩小语言间差距:OPD^2 有效收窄了英语–韩语的性能差,增强了非英语语言的推理能力。
- 英语-only OPD 的跨语言迁移:仅使用英语数据训练 OPD 也能提升韩语、日语的性能,但生成回答更倾向使用英语,凸显多语言数据对保持目标语言输出的重要性。
与基线对比解读
OPD^2 将学习信号从教师-学生概率差替换为教师-基座模型概率差(delta),使蒸馏目标聚焦于教师的增量推理知识,过滤掉基座模型已有的通用语言分布,从而缓解多语言场景下的语言漂移。这一简单修改带来了显著且一致性的提升,尤其对低资源语言更有效。英语-only 训练虽能激活跨语言能力,但牺牲了语言一致性,说明真实多语言部署必须依赖多语言训练数据,否则会引入不可控的语言切换风险。
行业影响
落地场景
On-Policy Delta Distillation (OPD²) 在数学推理上的多语言扩展,可直接赋能以下产品与业务:
- 多语言 AI 教育产品:面向韩语、日语等非英语学习者的数学解题助手或自适应学习系统,显著提升本地化推理准确性。
- 全球化企业服务:跨国团队的财务分析、数据科学、工程计算等场景中,LLM 需处理多语言数学描述,OPD² 可减少语言切换带来的性能损失。
- 内容审核与知识平台:数学内容社区(如 Stack Exchange 的多语言版)的自动解答与质量评估,需模型在多语言下保持推理一致性。
商业价值
- 降本增效:OPD² 作为一种 on-policy 蒸馏方法,相比强化学习 (RL) 训练能更高效地利用 token 级监督,减少样本量需求,降低 post-training 的计算开销。对于多语言场景,无需为每种语言重新训练大模型,仅需少量多语言数据即可显著提升已有基模型的推理能力。
- 用户体验提升:非英语母语用户在使用智能助手时,获得 更准确、更贴近母语逻辑 的数学解答,减少因语言混用导致的误解,提高用户粘性与付费意愿。
- 市场覆盖:通过解决 英语中心主义 的模型性能差距,帮助企业产品无缝拓展至日韩等高价值市场,而无需组建额外的本地化算法团队。
与现有产品/工作流的集成
- Post-training 流水线:OPD² 可直接插入现有 LLM 训练栈。例如,在 SFT (Supervised Fine-Tuning) 之后,增加 OPD² 阶段来提升推理能力,无需复杂的 RL 奖励设计。开发者只需准备 目标语言的数学 reasoning 数据 和 基模型/教师模型对。
- 推理引擎兼容:OPD² 仅改变训练过程,不修改模型架构或推理逻辑,因此与主流推理加速框架(如 vLLM、TensorRT-LLM)完全兼容。部署时无额外成本。
- 数据飞轮:在线教育/客服系统中,可收集用户实际交互的多语言数学问题,通过 OPD² 持续蒸馏老师模型的知识,迭代优化学生模型,形成 持续学习闭环。
具体落地用例
- 全球化在线教育平台:某平台提供韩语和日语的 K-12 数学辅导,利用 Qwen3 基模型,通过 OPD² 使用少量韩语数学语料进行 post-training,使得模型在解答韩语几何题时准确率提升 10%+,同时保持回答为韩语,避免英语输出。该功能直接集成到已有的 AI 助教机器人中,通过 API 调用,无需改动前端。
- 多语言金融分析助手:为跨国投行的分析师提供 AI 工具,输入可能为日语的财报问题(如“過去5年間の売上高の平均成長率を計算して”),要求模型进行数学推理并输出日语结果。使用 OPD² 训练的模型能准确理解并计算,输出稳定在日语,避免了英语-only OPD 常见的语言漂移问题。集成到内部 RAG 流水线,作为推理节点使用。
局限
- **语言覆盖范围有限**: 论文仅在英语、韩语、日语三种语言上验证 **OPD^2** 的多语言数学推理能力,未涉及更多语言(如其他东亚语言、欧洲语言等),且多语言训练数据的构造方式对结果影响显著,但未系统讨论数据混合比例、语言类型平衡等关键因素。实际多语言场景需考虑语言间知识迁移的通用性,实验结论的外部有效性有限。
- **模型与任务泛化性不足**: 实验仅基于 **Qwen3** 模型家族(1.7B 和 8B 规模),未对比其他开源模型或架构(如 LLaMA、Mistral),**OPD^2** 在不同预训练 token 分布下的效果未知。此外,任务局限于数学推理,虽然前作已在科学、编码任务验证了 **OPD^2** 的有效性,但在多语言条件下,其他推理类型的表现缺乏证据,泛化结论有待拓展。
- **方法改进增量较小**: **OPD^2** 本质是将原始 **OPD** 中的师生概率差替换为教师与其基模型的概率差,该思想在 **Heo 等人 (2026)** 中已提出,本工作的主要贡献是将该方法应用于多语言场景并观察语言迁移现象,方法层面的创新有限。同时,论文未深入分析为何 delta 信号在多语言下更有效(如或许与跨语言表示对齐有关),对机制的解释不足,削弱了方法指导意义。