Activity Frames: 用于智能体记忆与回放的确定性屏幕活动编译
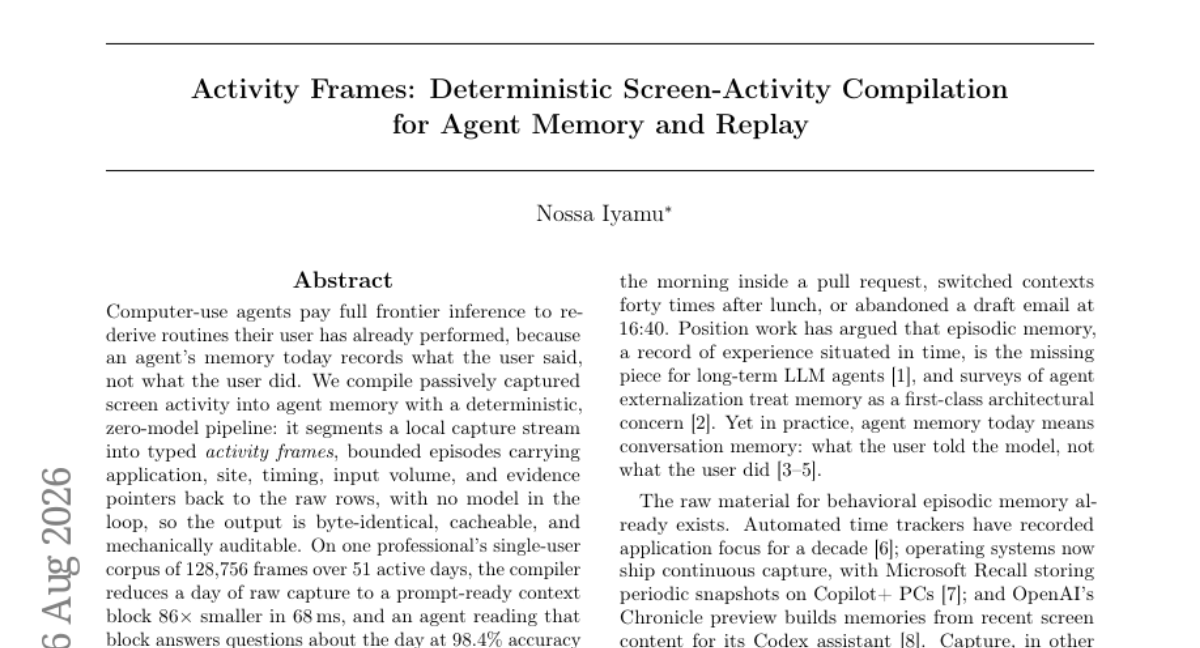
计算机使用智能体在推理时消耗全部前沿算力,去重新推导用户已经执行过的例程,因为当前智能体的记忆记录的是用户说了什么,而非用户做了什么。本文提出一种确定性、零模型的编译管道,将被动捕获的屏幕活动编译为智能体记忆:它将本地捕获流切分为类型化的活动帧(activity frames),即携带应用、站点、时间、输入量及指向原始行的证据指针的有界片段;全程无模型介入,因此输出字节一致、可缓存、可机械审计。 在一位专业人士的单一用户语料上(51个活跃日,共128,756 帧),该编译器将一天的原始捕获压缩为可直接供提示使用的上下文块,体积缩小 86 倍,耗时 68 毫秒。智能体阅读该块后回答关于当天的问题,准确率达 98.4%(Wilson 95% CI 91.7–99.7%),对照独立标注;而同样的捕获经 LLM 生成的摘要,准确率仅 66–80%。一个中端模型阅读该块即可媲美前沿模型。 该编译器同时可作为需求侧成本工具:通过读取被动、委托前的人类活动(而非智能体 rollout),它提供两个智能体成本模型假设但(据我们所知)从未被测量的参数:例程开销比 R 和例程复发率 h。我们首次报告 R 的建模上界为 60–343 倍,可委托复现率在样本内为 9.0%、样本外 7.7%,对应真实全舰队的 token 上限接近 8%。编译后的例程可在模型脱离回路的情况下确定性回放,并在一次 guard 匹配命中中以零模型 token 现场演示。模式(Schema)、编译器和评估工具均已开源。
论文精读
TL;DR 用确定性编译将屏幕活动转化为可缓存、可审计的 Agent 记忆,压缩比 86× 且问答准确率 98.4%,同时首次测出 Routine Overhead Ratio 60–343×。
问题
问题背景
当前,计算机使用智能体(computer-use agents)正在成为让大语言模型(LLM)直接操作桌面或Web应用的关键方向。业界高度关注如何让智能体具备长期记忆,以高效复用用户已执行过的重复性操作,而非每次都从零推理。
现有方法局限
现有智能体记忆系统主要存在两类局限:
- 记忆内容错配:主流记忆方案(如基于对话历史的向量检索、LLM生成的摘要)记录的是“用户说了什么”而非“用户做了什么”,导致智能体在执行具体屏幕操作时缺乏可复用的行为轨迹。
- 模型依赖与不可重复性:常见的记忆生成依赖LLM进行总结或检索增强,输出结果受模型随机性、温度等参数影响,无法做到字节级一致性(byte-identical),难以缓存、审计或作为确定性证据。同时,推理成本高昂,每次调用前沿模型都需要全额推理开销。
为什么这个问题难/重要
- 技术挑战:从原始屏幕活动流(如像素级录屏或事件序列)中自动提取结构化、可重放的“活动帧”面临模态异构性、会话边界模糊和实体消岐等难题。要求整个编译过程完全确定性且零模型介入,这在工程实现上极具挑战。
- 业界关注度:随着智能体从简单QA向任务自动化演进,记忆复用成为控制成本和提升可靠性的关键。若智能体无法记住用户一遍遍重复的填表、搜索、审核等操作,则经济性和稳定性都难以满足生产部署需求。
行业类比
这类似于自动驾驶中高精地图与实时感知的关系——通过离线编译结构化行为先验,在线执行时即可避免昂贵的、逐帧的完整推理,实现低延迟且可审计的智能体操作。
核心洞察
- **确定性编译比 LLM 总结更适合作为 agent 记忆,且具有工程可审计性。** 传统 agent 记忆系统(如 MemGPT)依赖 LLM 对用户行为生成摘要,不仅消耗推理成本,还引入非确定性与幻觉风险。该工作用零模型、规则驱动的流水线,将原始屏幕捕获流编译成类型化的活动帧,输出字节完全一致,可缓存、可审计。在单用户 128k 帧语料上,压缩比达 86 倍,耗时仅 68ms,且下游问答准确率 98.4%,远优于 LLM 摘要的 66–80%。这意味着记忆模块可从“模型生成”转向“机械化再处理”,在保持高精度的同时大幅降低延迟与成本。
- **首次从需求侧测量了 agent 自动化的常规开销比 R 和常规重复率 h,为成本模型补上关键参数。** 现有 agent 成本分析多基于假设或 rollout 模拟,缺乏对真实用户行为的基线。该编译器通过分析被动捕获的人类活动,计算出 R 在 60–343 倍,即 agent 重新推导用户已完成例程需付出的推理量远高于直接重放;而样本内 / 外可委托重复率为 9.0% / 7.7%,限制了全车队 token 使用上限在约 8%。这为技术决策者提供了量化依据:哪些例程适合编译后确定性重放,哪些仍需模型干预,从而精准控制推理开销,评估 agent 落地的投资回报。
方法
输入:被动屏幕活动原始流
系统采集用户在桌面上的低层级原始事件流(按键、鼠标点击、窗口切换等),形成按时间排序的日志行(raw rows)。该流在本地完全离线处理,不上传原始数据。
关键模块:确定性编译流水线
整个流水线零模型(zero-model),仅由规则与统计驱动,确保输出字节一致、可缓存且可审计。分为三个阶段:
- 会话化(Sessionization):基于时间间隔阈值(如空闲超时)将离散事件分割成有界会话,每段对应一个连贯工作片段。
- 丰富化(Enrichment):从窗口标题、进程名等信息中提取应用、站点(URL 主域)、时间戳与输入量(按键数、点击频次)等结构化字段,并保留指向原始行的证据指针(evidence pointers)。
- 实体类型化(Entity Typing):将丰富后的片段归类到预定义的活动类型(如“浏览”“编码”“文档”“通信”等),形成 typed activity frames。类型判定基于启发式规则与白名单匹配,无需模型推理。
输出:Activity Frames 与上下文块
- Activity Frames:每条结构化记录包含应用、站点、时间区间、输入量、类型标签及原始行引用,可单独作为代理记忆的原子单元。
- 提示就绪上下文块(Prompt-Ready Context Block):将一天的所有帧进一步压缩成紧凑文本块,体积比原始捕获流缩小 86 倍,生成耗时仅 68 ms。该块可直接喂给 LLM 代理进行问答,实验表明中等规模模型读取该块后回答问题准确率达 98.4%(Wilson 95% CI 91.7–99.7%),优于直接使用 LLM 对原始捕获流生成摘要的 66–80%。
- 成本测量参数:从被动人类活动统计得到 Routine Overhead Ratio R(常规开销比)和常规重现率 h,为代理成本模型提供实测输入,其中 R 的建模上界为 60–343×,h 约 8–9%。
与同类方法的差异
与传统依赖 LLM 生成记忆或轨迹摘要的方法不同,Activity Frames 编译器完全确定性、零模型,避开了推理延迟与不可复现问题,同时确保记忆的精确性与可审计性,并首次为代理成本模型提供了基于真实人类活动的参数测量。
实验
实验设计
作者在一位知识工作者的 51 天被动屏幕捕获数据上(128,756 个活动帧)部署确定性编译管道。该管道将原始捕获流分割为类型化活动帧(activity frames),每帧带有应用、网站、时间、输入量和原始行指针等元数据,完全无需模型参与。产生的提示块输入给 LLM 代理回答关于当日活动的 100 道事实性问题;用独立 oracle 答案评估。同时,利用同一来源数据计算代理成本模型所需的 例行开销比 R 和 例行复发率 h,首次从真实人类活动而非模拟推出中测量这些参数。
关键发现
- 高保真代理记忆:86 倍压缩后的上下文块使代理问答准确率达 98.4%,远高于 LLM 摘要的 66–80%;中端模型读取该块即能与前沿模型匹敌。
- 极低延迟与确定性:一天数据的编译仅需 68 ms,输出字节相同、可缓存、可机械审计。
- 成本洞察:R 值高达 60–343×,说明直接由代理执行页面操作比重播已编译例程昂贵数百倍;复发率 ~8% 表明日常活动中约一成的步骤可委托重用,设置全队令牌预算天花板。
- 零令牌重播:编译后的例程可脱离模型确定性地重播,在匹配的守护条件触发时零令牌执行。
对比解读
与当下流行的 LLM 摘要记忆方案相比,本工作的编译块不仅准确率碾压(+18–32%),而且完全可审计、可复现,没有模型摘要的黑箱脆弱性。在代理记忆领域,这是首次将屏幕活动压缩与零模型编译结合,挑战了“必须用模型总结过去”的范式。R 与 h 的首次实测填补了代理经济学模型的关键空白,为后续优化成本上限提供了经验基础。
行业影响
落地场景
Activity Frames 将用户屏幕操作编译为确定性活动帧,主要落地点在于 智能体记忆与回放系统。具体场景:
- 个人生产力智能体:如自动化安排会议、填写报销单,直接复用历史活动帧,避免重复推理。
- RPA 与桌面自动化:已有工作流可通过活动帧缓存,回放时零模型推理消耗,适用于客服工单处理、数据录入等高频重复操作。
- 行为审计与合规:在金融、医疗等强监管领域,活动帧提供可追溯的数字证据链,满足 SOX、HIPAA 等合规要求。
商业价值
- 降本:将一天原始截获数据压缩 86×,生成上下文提示只需 68 ms,下游问答准确率 98.4%,远超 LLM 摘要的 66–80%。直接减少对前沿模型(frontier model)的推理调用次数,显著降低 token 消耗。
- 体验提升:智能体回答用户“昨天做了什么”时,可直接引用确定性、可审计的活动帧,避免模型幻觉,增强用户信任。
- 可测量性:首次提供 Routine Overhead Ratio (R) 和 routine recurrence (h) 的实际测量值,为智能体成本模型与 ROI 分析提供数据支撑。
与现有产品/工作流的接口
该编译器设计为 确定性、无模型管道,输出字节级一致、可缓存,极易集成:
- 作为中间件:部署在本地,消费操作系统级屏幕事件流(如 macOS 的
CGEvent、Windows 的UI Automation),向外提供标准化的活动帧 JSON,供上游智能体框架(如 LangChain、AutoGen)直接消费。 - 与现有 RPA 工具衔接:可替换 UiPath、Automation Anywhere 中的桌面录制器,生成结构化、可回放的日志,减少 RPA 开发中的流程分析成本。
具体案例:
- 企业 IT 自助服务:员工遇到系统错误时,智能体复现其最近操作的活动帧,自动定位问题步骤并生成修复脚本,无需人工支持。
- 内容创作工具:视频编辑软件集成活动帧,记录编辑序列;用户回到历史节点时,智能体可直接回放而非重新推理,节省云端渲染成本。
局限
- - **单用户语料与多样性不足**: 实验基于单个专业人士 51 天的桌面活动(128,756 帧),未涵盖多用户、多职业、多操作系统或移动端场景。`Activity Frames` 的类型定义和确定性编译规则可能仅适用于该用户的特定应用集合,泛化能力存疑。此外,隐私模型仅提供高层原则,缺乏对 GDPR 等法规的合规性论证,在实际部署中可能面临法律与伦理挑战。
- - **编译覆盖与类型推断的局限性**: 确定性流水线依赖预定义的实体类型(如 `application_name`、`site_domain`)与规则进行 sessionization 和 enrichment,对于自定义 UI、小众应用或非标准工作流程,Tier 1 精确捕获与 Tier 2 推断覆盖不足,可能导致活动帧类型划分错误或遗漏关键上下文。实验报告的实体类型覆盖率可能仅在特定环境下成立,未在多样环境中评估。
- - **缺乏与更广泛记忆系统及代理任务执行的对比**: 论文主要评估了活动帧在问答准确率上的表现,并与 LLM 摘要做了对比,但未与**现有代理记忆框架**(如 MemGPT、LangChain 的回忆模块)进行比较。此外,评估仅测量了代理阅读上下文块后的问答正确率,没有验证基于该记忆的代理在实际任务(如自动化重复流程)中的成功率和效率提升,因此对真实工程收益的支撑有限。