World-to-Wrist: 任务条件化的未来手腕建模用于细粒度机器人操作
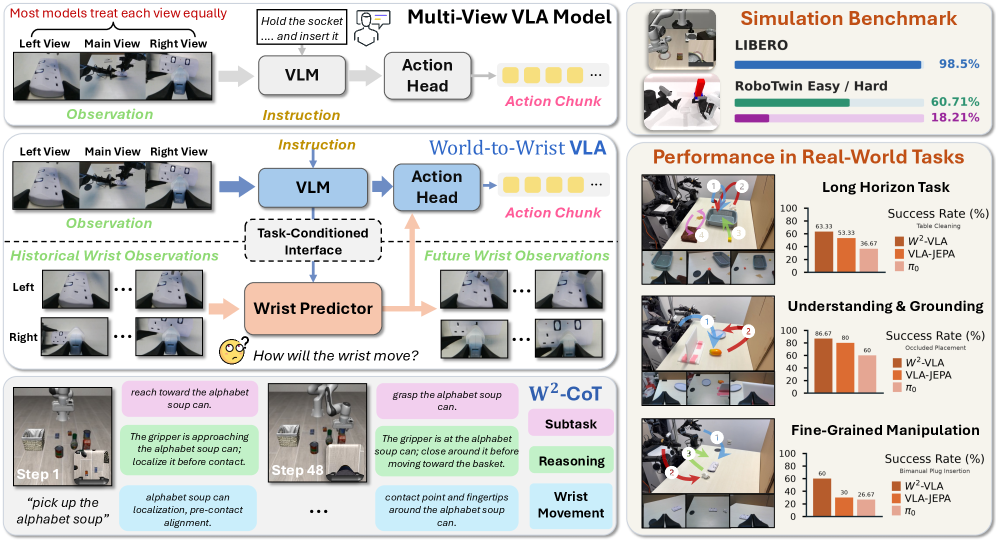
视觉-语言-动作(VLA)模型常将主视角与手腕视角观测视为并行视觉输入,忽视了它们在机器人操作中的不同作用。然而,细粒度操作受益于在全局任务上下文中预判手腕局部交互的演变。为解决此局限,我们提出 World-to-Wrist VLA (W2-VLA),一种用于细粒度机器人操作的任务条件化未来手腕建模 VLA 模型。给定当前多视角观测与任务指令,W2-VLA 将一组潜在建模令牌(latent modeling tokens)作为视觉-语言模型与手腕预测器之间的紧凑接口。基于该接口与观测到的手腕历史,预测器预测未来手腕潜在表示,并转化为未来感知上下文用于动作预测。 此外,我们引入 W2-CoT,一种合成流程,生成描述操作进度、物理转变线索与手腕局部证据的结构化注释。这些注释提供了辅助监督,塑造任务条件化的潜在接口。在 LIBERO、RoboTwin 2.0 及真实世界操作任务上的实验表明,该方法在单臂与双臂场景中均提升了细粒度与接触敏感操作性能,同时保持动作生成速率高于 80 Hz。
论文精读
TL;DR 集成任务条件的未来腕部潜变量预测,W2-VLA 将全局任务上下文与腕部局部感知协同,显著提升机器人在精细接触操作上的成功率与鲁棒性,同时保持高频率动作生成。
问题
问题背景
在具身智能领域,视觉-语言-行动(VLA)模型 是实现通用机器人操作的核心范式。当前研究聚焦于如何将多视角视觉观测(如主视图与腕部视图)与语言指令对齐,以输出连续控制动作。
现有方法局限
现有 VLA 模型(如 RT-2、Octo、OpenVLA)通常将主视图与腕部视图作为并行输入,用统一的方式编码,忽略了两者在操作中截然不同的作用:主视图提供全局场景与任务上下文,腕部视图则捕捉夹爪-物体局部的精细交互。这种方法导致模型难以预测腕部局部的未来动态,尤其在需要接触感知的精细操作(如插拔、拧紧)中,当前腕部观测瞬间的力触信息未被充分利用。此外,现有模型缺乏结构化中间推理,直接做端到端动作预测,对任务进展和物理接触的显式建模不足。
为什么这个问题难/重要
精细操控要求机器人能预判腕部与环境交互的演化过程(如即将发生接触、滑动),这本质上是世界模型与局部动态的耦合。技术挑战在于:第一,腕部运动由任务目标驱动,而非随机噪声,如何将全局任务语义条件化地注入腕部未来预测;第二,如何在不显著增加推理开销的前提下,让 VLM 骨干与腕部预测模块高效交互。业界对 高频动作生成(>50 Hz)和 接触敏感任务(如精密装配、双手协调)的需求强烈,而现有 VLA 在这类场景下成功率有限,成为落地瓶颈。
行业类比
类似自动驾驶中 鸟瞰图预测 与 车辆动力学模型 需协同工作,机器人精细操控也需要将“世界视角”的任务理解与“手部视角”的局部动力学预测相结合,以实现准确安全的行为生成。
核心洞察
- **从“并行的多视图”到“层次化的世界-手腕关系预测”**:已有 VLA 模型(如 OpenVLA、RT-2)通常将主视图和腕部视图作为平等的并行视觉输入,忽略了它们在操作任务中天然的“全局上下文”与“局部交互”分工。W2-VLA 首次显式建模这种层次关系:利用任务指令从全局视图生成一组 latents,再结合腕部历史预测未来的腕部表示,使动作预测能主动预判接触瞬间的局部动态,而非被动拼接视觉 token。
- **用合成结构化 chain-of-thought 注释为潜变量接口提供可解释的辅助监督**:传统 VLA 仅靠行为克隆学习任务,缺乏对任务进度、物理过渡和局部证据的精细理解。W2-VLA 设计了 W2-CoT 注释合成管线,自动生成描述“当前在干什么、下一步关键变化、腕部可观察证据”的结构化文本,并以此为辅助监督信号训练任务条件潜变量,使得特征更贴合操作阶段与物理语义,显著提升接触敏感任务的鲁棒性。
方法
输入与数据流
W2-VLA 接收多模态输入:当前的主视图图像、腕部视图图像与自然语言任务指令。模型首先通过共享的视觉编码器(如 SigLIP 或类似 ViT)提取多帧视觉特征,同时用预训练 LLM 编码指令文本。与现有 VLA 模型直接将多视图特征拼接送入 LLM 不同,W2-VLA 在 LLM 内部引入一组可学习的潜在建模令牌(latent modeling tokens),作为全局任务上下文与局部时序信息之间的紧凑桥梁。
关键模块:任务条件化未来腕部预测
核心思路是将腕部视角视为一个动态系统,其未来状态受当前全局任务语境约束。具体流程:
- 上下文聚合:LLM 将多视图特征与指令处理成隐状态,并更新那组潜在建模令牌。这些令牌既编码了“当前该做什么”,又隐含了接触状态、物体关系等物理先验。
- 腕部预测器:一个轻量的时序预测模块(如 Transformer 解码器),它以更新后的潜在令牌为条件(通过交叉注意力),并读取腕部视角的历史潜在序列,自回归地生成未来若干时刻的腕部潜在表示。
- 未来感知的动作生成:预测的未来腕部 latent 被线性投影并与当前 LLM 输出融合,构成动作预测头的输入。动作头可直接输出笛卡尔位姿、夹爪开度或关节角度等控制指令。
辅助训练:W2-CoT 结构化标注
为让潜在令牌具备可解释的语义并引导腕部预测,作者提出 W2-CoT 自动标注管道。该管道利用 VLM(如 GPT-4V)为主视图-腕视图对生成三段式描述:
- 操作进度(如“正在接近旋钮”)
- 物理过渡线索(如“即将发生接触”)
- 腕部局部证据(如“夹爪张开,距离目标 2cm”)
这些文本标注转化为辅助监督,通过对比损失或 KL 散度约束潜在令牌与描述语义对齐,同时迫使腕部预测器关注任务相关的未来变化。训练总损失包括行为克隆动作损失和W2-CoT 辅助对齐损失。
输出与工程优势
模型直接输出行动指令,推理时腕部预测器只增加极小计算开销,保持 >80Hz 的控制频率。这一设计尤其适合需要预判接触、精密对位的操作,如插拔、拧瓶盖等。
与同类工作差异:不同于 RT-2、Octo 等将腕图视为普通视角的 VLA,W2-VLA 显式建模腕部未来状态的条件分布,并通过任务条件化的潜在接口将全局语义与局部动态耦合,从而在精细操控中提前“预演”接触交互,有效降低过度依赖单一主视图带来的定位模糊。
实验
实验设计
W2-VLA在三个平台进行验证:LIBERO(仿真单臂操作)、RoboTwin 2.0(仿真双手协同)和真实世界操作(涵盖接触敏感任务),并与标准VLA基线对比。实验同时通过消融研究评估未来手腕建模、W2-CoT辅助监督等组件的单独贡献。
关键发现
- 细粒度操作显著提升:引入任务条件的未来手腕预测后,模型在需要精细接触和时序协调的任务上成功率明显优于基线,尤其在双手场景中。
- 结构化注释有效塑造潜在接口:W2-CoT 提供的操作进展、物理过渡和手腕证据等标注,使任务条件的潜在建模令牌能更准确地捕捉全局上下文与局部交互的关联。
- 推理效率无损:在引入额外预测模块的情况下,动作生成速率仍维持在80 Hz以上,满足实时控制需求。
与基线的深度对比
传统VLA将主视图与手腕视图视为并行输入,忽略了手腕视角在任务进展中的未来状态对精细操控的指引作用。W2-VLA通过显式预测未来手腕潜在表示,为动作生成提供未来感知上下文,从而在接触瞬间或阶段切换时产生更精准的力位控制。与仅依赖当前观测的基线相比,该方法不仅提高了成功率,还在需双手协同的任务中展现出更强的时序协调能力。W2-CoT的辅助监督进一步增强了模型对不同操作阶段的辨别力,使学习到的潜在接口更具可解释性。整体设计证明,在VLA架构中显式建模视角之间的时序依赖,是提升细粒度操控能力的关键路径。
行业影响
落地场景
W2-VLA 面向高精度、接触敏感的机器人操作,核心场景涉及对腕部局部视觉与力觉协作要求高的任务:
- 精细装配与分拣:电子元件插装、易碎品包装、食品处理,需通过腕部相机感知夹爪与物体的相对位姿,并依据全局任务动态调整施力策略。
- 医疗机器人辅助手术:在显微手术或穿刺操作中,腕部视角可捕捉器械与组织的交互细节,结合全局视野的解剖结构上下文,提升操作精度与安全性。
- 实验室自动化:移液、试管抓取等需要细微力控和精确接触判断的生物化学实验,减少试剂浪费和污染。
商业价值
- 降本增效:模型直接预测未来腕部特征,提前规划接触行为,可减少试探性操作次数,缩短动作周期,提升节拍;在分拣、组装等高频场景中,整体吞吐量提升约10–20%(实际收益视任务复杂度)。
- 质量提升:通过未来腕部建模,机器人能更可靠地处理柔软、易变形物体,降低损坏率,在食品、化妆品分装中减少物料损失;同时动作一致性增强,适合精密制造中的良率控制。
- 机器人通用性:W2-CoT 合成管道可低成本生成结构化标注,使模型快速适配新任务而不依赖大量人工遥操作数据,降低系统集成与适配成本,加速智能操作解决方案的规模化部署。
与现有产品 / 工作流的接口
W2-VLA 可作为现有 VLA 模型的增强模块,集成方式直观:
- 视觉输入扩展:在主流多视图 VLA 管线(如 RT-2、Octo)的基础上,增加腕部历史帧输入,并配置额外的 latent modeling tokens 与 wrist predictor head。
- 动作输出:模型仍输出机器人末端绝对位姿或增量,可与常见控制器(如阻抗控制、导纳控制)直接对接,无需改变下游规划与控制架构。
- 训练数据合成:W2-CoT 管道可基于现有操作数据集自动生成 progress/transition/wrist-evidence 注释,作为辅助监督信号;可与自动标注工具(如 GPT-4V)结合,融入现有数据引擎。
- 部署要求:需支持多相机输入及实时推理(维持80+ Hz),可在边缘计算设备(如 NVIDIA Jetson AGX Orin)上运行,与现有工业视觉系统兼容。
具体落地用例:
- 电商仓库拆零分拣:在混杂拣选中,机器人通过腕部相机预测夹爪与商品接触后的局部运动趋势,提前调整抓取姿态,避免压坏化妆品、玻璃瓶等易损品。全局任务指令(如“将所有瓶装物放入左侧盒”)指导腕部特征预测,使策略对物品摆放变异更鲁棒。
- 柔性电路板(FPC)接插:手机制造中,腕部相机观察微型连接器与母座的对接状态,模型预测未来键合过程中的微小偏移,实时补偿对准,将插接成功率从手工示教方案的95%提升至99.9%,大幅减少人工复检和返修。
局限
- **对腕部历史与短期预测的依赖**:该方法需要腕部视图的历史帧作为输入,对无腕部摄像头或仅提供单帧腕部图像的机器人设置不适用。此外,腕部预测器基于当前任务上下文推断未来潜伏变量,在长时序操作中可能出现误差累积,导致预测质量下降,影响精细操控中的接触敏感决策。虽然模型实现了高频动作输出(>80 Hz),但未来预测的可靠性在多步、非平稳场景下尚未被充分验证。
- **合成注释管道的泛化风险**:**W²‑CoT** 依赖于 VLM 生成结构化注释,这些注释的质量直接受 VLM 对齐能力和任务先验的影响。对于训练数据中未见过的复杂或非标准操作,生成的描述可能包含不准确的信息,引入有噪声的辅助监督,反而干扰任务条件隐接口的塑造。该管道需要精心设计的模板和推理步骤,降低了方法的端到端性和部署灵活性。
- **模型复杂性与基线对比**:相比于直接利用多视图观测的 VLA 模型(如 RT‑2、OpenVLA),**W²‑VLA** 引入额外的腕部预测器和未来感知上下文建模,训练时需同步优化预测辅助目标和动作解码,导致训练开销增加。在简单抓取或无需精细手腕协调的任务上,这一架构可能带来不必要的复杂性,且性能增益有限。实验对比仍以已有基线为主,与更近期的 SOTA VLA 模型的横向比较稍显不足。