StreamArena: 迈向连续、交互、长时程的智能体流式视频理解
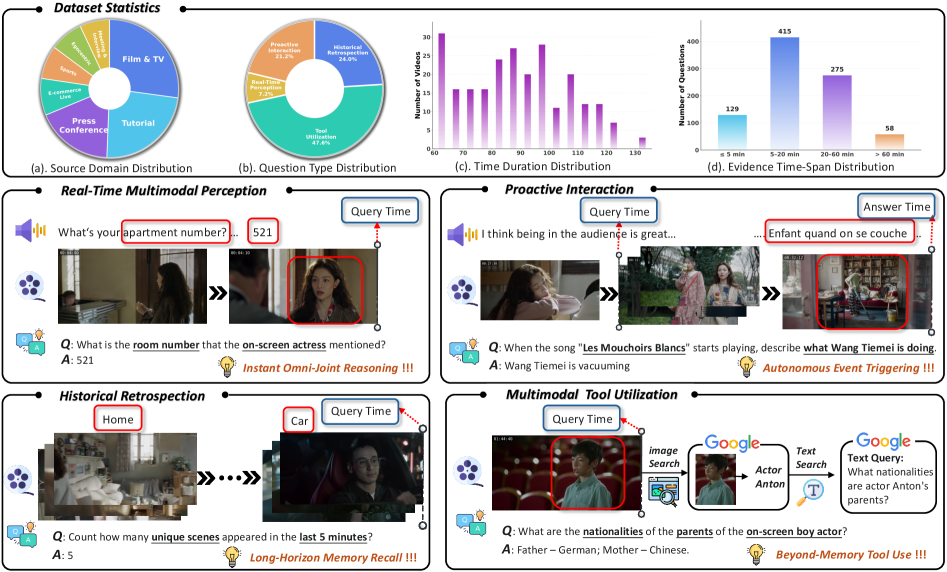
在连续真实环境中部署自主多模态智能体,需要其摄入无界的音视频流并维持小时级记忆。然而,现有评估主要依赖短视频片段和选择题形式。这种设计使得仅处理最后四帧的极简基线也能匹敌甚至超越复杂流式模型,同时选项也暴露了语言捷径。我们提出 StreamArena,一个面向小时级、交互式流式视频理解的基准。 StreamArena 包含 243 个完整视频(平均 88.8 分钟)和 3,646 个严格标注的开放问答对,评估四个方面:实时感知、历史回溯、主动交互、多模态工具利用。对不同系统的评估揭示了连续交互与长时程多模态理解之间的张力:仅保留近期帧的方法无法恢复遥远事件;将过去观测转为文本的方法丢失视觉证据;反复压缩视觉记忆的方法难以长期保留细节。 为解决这一矛盾,我们提出 StreamMind,一种双层架构:将延迟敏感型交互和主动监控分配给独立调度的前端 worker,后端 worker 异步构建持久多模态记忆并执行历史回溯与外部搜索。StreamMind 在全部四个能力上超越现有流式基线,并通过复用持久状态降低查询到回答的延迟。
论文精读
TL;DR StreamArena 首个小时级交互式流视频理解基准,暴露实时交互与长时记忆的张力;StreamMind 通过前后端分离架构实现低延迟持久多模态记忆,在感知、回溯、工具使用与主动交互四项能力上全面超越现有方法。
问题
流式视频理解正从短视频分析转向 小时级连续交互,旨在支撑能在真实环境中持续运行的多模态智能体。当前评测主要依赖 简短片段+多选题,导致仅处理最后四帧的极简基线即可媲美复杂流式模型,且答案选项本身暴露语言捷径。现有流式方法存在三类典型瓶颈:1) 仅保留近期帧的滑动窗口法无法回溯远期事件;2) 将历史观测转为文本摘要后,视觉证据大量丢失;3) 反复压缩视觉记忆的模型,难以保全细粒度时空细节。这些局限使系统陷入“长程记忆”与“实时交互”的张力。
该问题之所以困难,是因为需要在一个统一框架内兼顾:无界的视频输入、小时级记忆的持久化与检索以及 毫秒级响应的交互要求。视觉-语言信息的有效压缩、索引和异步调度均是核心技术挑战。业界对此高度关注,因为 自主多模态智能体(如AR助手、机器人)必须依赖此类能力来实现环境感知、历史回忆、主动决策与工具调用。
类比:就像需要一个全天候个人助理,它能连续观察周围数个月,随时回答“上周三那辆蓝色轿车停在哪个位置”这类需要长程视觉记忆的问题。
核心洞察
- 当前流视频理解评测仅依赖短片段与多选题,导致仅处理最近4帧的简单基线即可匹配甚至超越复杂流模型,且答案选项暴露语言捷径。StreamArena 首次构建小时级交互流视频基准,包含 243 段平均 88.8 分钟的视频及 3,646 个开放式问答,严格评估实时感知、历史回溯、主动交互与工具使用,揭示现有方法的真实能力落差。
- 实时交互与长时多模态理解存在本质冲突:仅保留近期帧无法回溯远事件,将历史转为文本摘要会丢失视觉证据,反复压缩视觉记忆难以保留细粒度细节。StreamMind 通过解耦架构应对这一张力——前端异步调度处理延迟敏感的交互与主动监控,后端异步构建持久多模态记忆并执行历史检索与外部搜索,在四大能力上超越现有流基线,且借助持久状态显著降低查询响应延迟。
方法
StreamArena 首先构建了一个面向小时级流视频理解的评测基准,包含 243 段平均时长 88.8 分钟的全长视频和 3,646 道开放式问答对,覆盖实时感知、历史回溯、主动交互与多模态工具使用四类能力。
针对现有流处理方法在长时理解与低延迟交互之间的冲突,本文提出 StreamMind——一种双层异步架构。其输入为连续的音频-视频流,系统由独立调度的两类 worker 组成:
- 前端 worker 负责延迟敏感的实时交互(如用户即席问答)与主动监控(如关键事件触发),仅维护近期窗口以保障低响应时间;
- 后端 worker 异步运行,持续从完整流中构建持久化多模态记忆。它不压缩为纯文本摘要,而是保留视觉证据的层次化存储,并支持历史事件的高精度检索与外部搜索工具调用。
前后端通过共享状态协调:前端遇到需要长时上下文的查询时,调度后端记忆检索结果;后端同时将压缩的全局状态推送至前端,补充缺失的长期依赖。这种解耦执行使系统在保持实时交互的同时,能回溯数小时前的细粒度视觉信息。
与仅保留最近帧、将历史转为文本摘要或反复压缩视觉记忆的现有方法相比,StreamMind 通过异步两级分工,首次在连续交互场景下统一了实时响应与小时级多模态理解。
实验
实验基于 StreamArena 基准,包含 243 个全长视频(平均 88.8 分钟)和 3,646 个开放问答对,覆盖四项能力:实时多模态感知 (RTP)、历史回顾 (HR)、多模态工具使用 (Tool) 和 主动交互 (Pro)。评估系统包括:离线轮次式 MLLM、仅保留最近帧的 AURA 与 MiniCPM-o-4.5、将过去观测转为文本的 VST、以及模型内压缩记忆的 StreamForest 与 ThinkStream。
关键发现:
- 连续交互与长时域理解存在固有矛盾:仅依赖最近帧无法恢复远距事件;文本化观测丢失视觉证据;反复压缩视觉记忆损害细粒度细节。
- StreamMind 通过两层架构(前端 worker 处理延迟敏感交互,后端 worker 异步构建持久多模态记忆)在所有能力上显著超越基线,并复用持久状态降低查询-回答延迟。
- 消融分析表明,长期记忆需要未来感知的保留机制,骨干模型规模也制约长时理解。
该设计揭示了流式视频理解中计算解耦的工程价值:将延迟关键任务与记忆构建分离,是处理小时级连续交互的核心思路。
行业影响
落地场景
StreamArena 及其配套 StreamMind 架构直接面向需要小时级流式视频理解的交互式 AI 应用。典型场景包括:
- 视频直播与社交:实时带货主播问答、多模态弹幕互动、直播违规巡检。
- 在线教育与会议:智能课程摘要、课堂实时答疑、会议纪要自动生成与回溯。
- 智能安防与巡检:长时段监控录像中的事件检索与异常主动预警。
- 内容平台审核:对 UGC 长视频进行多模态合规检查,支持回溯历史片段。
商业价值
- 降本:用 持续监控 + 主动触发 替代人工实时巡查,大幅降低人力审核成本;历史回溯能力减少人工复检时长。
- 增收与体验提升:在直播带货中即时回答复杂商品问题,提升转化率与用户留存;教育场景提供个性化交互,增强付费意愿。
- 新能力变现:开放 工具调用 接口,让 Agent 能实时查询外部知识库(如商品信息、课程资料),打造差异化增值服务。
与现有产品 / 工作流的接口
- 集成方式:StreamMind 可作为视频流处理中台,接入现有流媒体管道(如 WebRTC、RTMP)。前端 worker 负责低延迟交互,后端异步构建持久多模态记忆,通过 gRPC/HTTP 暴露查询 API。
- 对接产品:在直播平台中,可旁路拉流注入 StreamMind,输出结构化事件到实时大屏或客服系统;在教育平台,可对接录播库,提供知识点索引和问答服务。
具体落地用例
- 电商直播智能助播
Agent 持续观看 2 小时直播,能回答“主播刚才推荐的那件风衣的材质是什么?”并调用商品 API 获取库存;当主播念错价格时主动提醒。历史回溯避免因忘记几分钟前的细节而给出错误答案。 - 在线教育课堂笔记与辅导
对整节录播课自动生成时间线笔记,学生可随时提问“第30分钟讲的导数公式推导过程”,Agent 定位并解释;同时监控学生画面,在注意力分散时主动推送提醒。
StreamMind 的解耦设计使延迟敏感的交互与重量级记忆检索互不阻塞,可直接嵌入现有微服务体系,为长视频应用提供可落地的 Agent 方案。
局限
- **基准规模与泛化性有限**:StreamArena 包含 243 个视频和 3646 个问答对,虽覆盖多种场景,但视频领域分布可能偏向特定平台(如社交媒体),且时长集中于 88.8 分钟,难以反映真实世界连续流中极端长尾、高噪声或专业领域的挑战。评估采用回合制交互,无法完全模拟真实连续交互中的动态任务切换与优先级变化,高负载下的系统稳定性未得到充分验证。
- **架构复杂度与协调开销**:StreamMind 采用前后端分离的异步多 Worker 设计,虽解耦了延迟敏感型交互与长程记忆构建,但引入了 Worker 间通信与状态同步的潜在瓶颈。实验仅展示理想条件下的延迟改善,未分析 Worker 数量、消息队列深度、后端压缩策略失配等导致的性能退化。持久化状态重用虽降低平均延迟,但何时触发记忆清理或重构未给出明确策略,可能造成错误累积。
- **对比基线不够全面**:实验主要比较了近期窗口法、文本摘要法和内部压缩法,但未纳入更前沿的增强检索生成(RAG)或基于外部知识库的流式代理,也未讨论不同 MLLM 主干(如更大参数量或视频原生模型)对性能的影响。部分基线的实现(如 MiniCPM-o 配置)可能未达到最优,影响了对比的公平性。此外,工具使用和主动交互的评估场景较简单,缺乏对多工具协作和交互失败恢复机制的深入分析。