SFT 冲突,RL 共存:LLMs 多任务学习的理论与实证分析
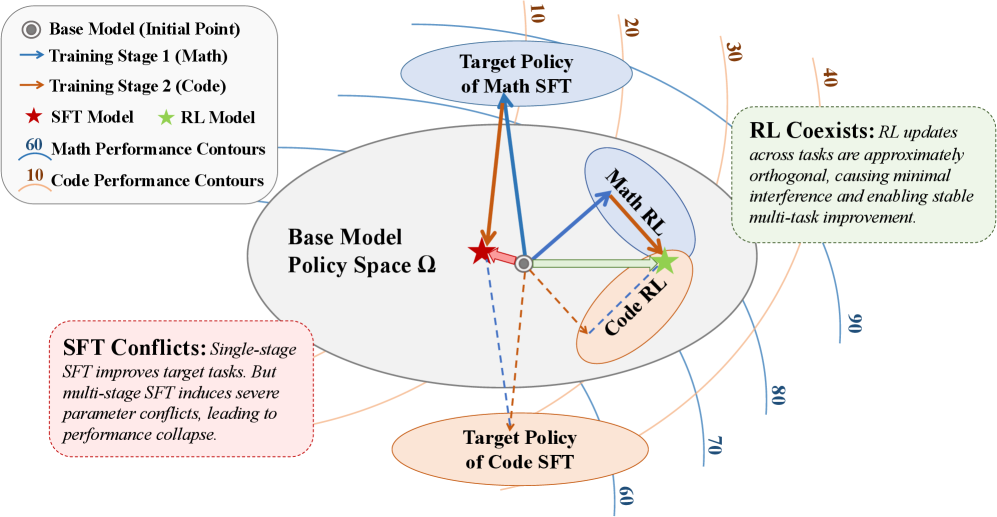
SFT 与 RL 在提升 LLMs 多任务推理能力时表现出截然不同的行为。初步实验揭示:SFT 在多阶段训练下遭受严重的任务冲突,而 RL 能使不同任务稳定共存。经验层面,我们追溯到参数级别,发现 RL 在任务间诱导稀疏且近似正交的更新。 我们通过分析多任务梯度干扰,为该机制提供理论解释。结果揭示了关键区别:SFT 中的干扰是范数受限的,随绝对梯度幅值缩放;而 RL 中的干扰是方差受限的,受优势归一化与在策略优化所引入的梯度方差约束。这种较小的方差界使得不同任务的优化方向近似正交。 基于此洞察,我们提出 Parallel-RL,一种解耦多任务训练的新范式,显著提高效率与灵活性。
论文精读
TL;DR 发现 SFT 多任务训练存在严重冲突,而 RL 因梯度更新稀疏正交能稳定共存,据此提出解耦的 Parallel-RL 框架大幅提升效率与灵活性。
问题
问题背景
当前 LLM 多任务推理能力提升主要依赖 Supervised Fine-Tuning (SFT) 与 Reinforcement Learning (RL) 两类范式。如何让单一模型在数学、代码、常识等不同任务上稳定获得增益,而避免相互干扰,是训练流程设计的核心关切。
现有方法局限
主流做法通常采用多阶段顺序训练:先用 SFT 注入通用知识,再按任务逐步 RL 优化。然而,初步实验揭示了一个普遍但未系统解释的现象:SFT 在多任务顺序训练时存在严重冲突,后一任务的梯度更新会显著覆盖前一任务的优化方向,导致灾难性遗忘;相比之下,RL 却能在任务间维持稳定共存,即使顺序叠加多个 RL 阶段,各任务性能几乎不下降。现有研究对这两种范式行为差异的深层原因缺乏理论剖析,多简单归因于“RL 更不易过拟合”,并未触及参数更新层面的本质机制。
为什么这个问题难且重要
LLM 多任务学习的关键挑战在于梯度干扰:不同任务的优化方向在参数空间中容易碰撞,导致部分任务性能倒退。该问题在 SFT 场景尤其突出,因为其梯度幅度直接与样本损失尺度相关,缺乏内在的冲突抑制机制。而在 RL 中,优势归一化与在线策略优化带来的梯度方差约束,使不同任务的更新趋向稀疏且近似正交,天然缓解了干扰。能否将这种 RL 的内在特性提取为可解耦的训练范式,直接影响未来 LLM 训练的效率与可扩展性。业界正广泛探索从单一通用模型向模块化、可组合训练的转型,理解梯度级正交化机理成为关键突破口。
行业类比
类似自动驾驶感知模型的模块化训练,各传感器任务若梯度不正交,联合训练时会有任务间负面拉扯;若能像 RL 更新那样自动稀疏化方向,便可独立训练子模块后再高效融合。
核心洞察
- **RL更新的稀疏与近似正交性使多任务共存成为可能**:本文首次从参数更新层面揭示RL在多任务训练时产生稀疏、近似正交的梯度,与SFT密集、高干扰的更新形成对比。以往多任务工作多依赖损失加权或梯度投影缓解冲突,而本研究通过实验和理论证明,RL的优势归一化与on-policy采样自然将干扰从范数限制转变为方差限制,使多个任务近乎独立优化。这为RL后期训练适合混合多任务提供了新解释。
- **“范数限制” vs “方差限制”的干扰理论框架**:论文创造性地区分多任务梯度干扰的两种机制:SFT的干扰随梯度范数增大而增大(范数限制),RL的干扰则由梯度方差上界控制,方差受优势归一化限制,即使任务多样,干扰也能稳定在很小范围。不同于以往仅从损失景观或冲突程度分析,该框架给出了可操作的指标,启发通过控制方差进一步缓解干扰,对RL微调的实践设计具有指导意义。
- **Parallel-RL解耦多任务训练,提升工程效率**:基于RL更新正交性的发现,作者提出Parallel-RL框架,将不同任务的数据、奖励解耦,并行训练后合并参数,无需复杂的多任务调度或梯度干预。相比串行或混合训练,这种范式显著提高训练吞吐,保持甚至提升各任务性能,为大规模LLM的多能力对齐提供了灵活、可扩展的方案,降低了多任务训练系统的维护复杂度。
方法
方法核心思路
基于SFT 多任务训练存在梯度冲突、而RL 更新具有稀疏性与近似正交性的发现,提出了 Parallel-RL 框架。该框架完全解耦多任务 RL 训练,将多个推理任务视为独立的 RL 优化过程,并行执行,再合并为统一模型,从而避免任务间干扰,提升训练效率与灵活性。
训练流程:输入 → 关键模块 → 输出
- 输入
- 多个推理任务的训练数据集,每个任务包含 prompt 与参考答案(用于奖励计算)。
- 关键模块
- 任务独立 RL 训练:每个任务以预训练 LLM 为起点,独立执行 PPO 类 on-policy 优化。各任务的 actor 网络从同一基础权重出发,分别积累经验、计算 advantage(归一化后方差受限)并更新参数。
- 梯度特性利用:理论证明 RL 梯度干扰为 方差受限(variance-limited),其内积上界远小于 SFT 的 范数受限(norm-limited),训练中梯度方向近乎正交,天然适合并行。因此无需跨任务梯度协调或冲突缓解策略,可直接并行训练。
- 权重合并:各独立训练得到的任务专用权重通过简单平均或参数融合形成最终模型,或保留为 MoE 式路由结构(论文未详细说明,但根据解耦思想可灵活设计)。
- 输出
- 一个能在多个推理任务上达到可比或优于联合训练、且无任务冲突迹象的 LLM。
与同类方法的差异
传统多任务学习通常混合所有任务数据做 SFT 或加权 loss,需要精心设计采样策略或梯度投影以缓解冲突,而 Parallel-RL 直接利用 RL 本身的稀疏更新特性,无需任何冲突缓解技巧,实现了“即插即用”的任务并行扩展,显著降低工程复杂度。
实验
实验设计
该研究首先通过初步实验观察 SFT 与 RL 在多阶段多任务训练下的行为差异:将 数学推理(GSM8K、MATH)、代码生成(HumanEval)、知识问答(ARC-Challenge)和通用推理(BBH)等任务依次训练,发现 SFT 出现严重灾难性遗忘与任务干扰,而 RL 能保持各任务性能稳定共存。随后从参数更新层面分析,量化梯度稀疏性与正交性,并基于梯度干扰理论给出严格证明:SFT 的干扰受梯度范数限制,RL 的干扰受优势归一化与在线策略带来的梯度方差限制,后者天然趋向近似正交。
关键发现
- SFT 的任务冲突源于梯度方向一致:多个任务更新在共享参数上对齐,导致优化方向相互抵消;
- RL 更新具有稀疏性与近似正交性:每个任务产生的更新高度稀疏,且不同任务间的更新方向几乎正交,这是由策略梯度本身的方差性质决定的;
- 理论证明揭示了 norm-limited vs variance-limited 的本质区别:SFT 干扰与梯度大小正相关,RL 干扰受限于梯度估计方差,而优势归一化有效压制了方差,使梯度接近正交。
对比解读与工程启示
传统多任务学习依赖联合训练或数据混合,但 SFT 天生存在干扰,往往需要谨慎的采样策略或参数隔离。而 RL 天然适应多任务共存,提示在需要持续学习或增量任务扩展的场景中,可优先考虑 RL 范式。基于此提出的 Parallel-RL 框架解耦了多任务训练,每个任务独立进行 RL 优化,大幅提升训练效率和扩展灵活性,避免了 SFT 中的任务编排瓶颈。该工作为多任务 LLM 微调提供了全新的范式选择依据,工程上可指导分布式训练架构设计,降低多任务统一模型的门槛。
行业影响
落地场景
该研究揭示了监督微调(SFT)与强化学习(RL)在多任务训练中的本质差异:SFT 存在严重的任务冲突,而 RL 通过稀疏、近似正交的梯度更新实现多任务稳定共存。这一发现可广泛应用于需要同时提升**大语言模型(LLM)**多项能力的工业场景,例如:
- 智能客服:需同时优化意图识别、多轮对话、情感安抚等任务,使用 Parallel-RL 能避免各能力互相干扰,提升整体服务质量。
- 内容审核与推荐:模型需兼顾违规内容检测、话题分类、生成解释等多种目标,RL 的多任务共存机制可显著降低维护成本。
- 金融分析:同时处理新闻摘要、数值推理、合规检查等任务,避免单一微调策略造成性能折损。
商业价值
- 降本:传统多任务训练通常需要顺序执行或多轮数据混合,Parallel-RL 将多任务解耦并行训练,降低计算资源占用与调试时间,直接减少硬件与人力开销。强化学习更新具有稀疏性,也能间接降低部署后的推理成本。
- 增效:由于 RL 更新避免任务间负向干扰,模型可在不遗忘已学能力的前提下持续加入新技能,使企业能够更快迭代产品功能,缩短上线周期。
- 体验提升:在客服、教育等交互场景中,稳定的多任务表现可减少答非所问或关键能力退化的问题,提升用户满意度与留存。
与现有产品/工作流的接口
- 训练框架集成:Parallel-RL 可作为一个即插即用的多任务 RL 训练模块,与现有的 TRL、DeepSpeed-Chat 等分布式 RL 框架兼容。只需将不同任务的奖励模型独立部署,即可实现梯度解耦,从而无需大幅改动现有 RLHF(人类反馈强化学习)流水线。
- 模型部署:训练得到的模型可直接替换原有单任务或多任务联合训练的模型,无需特殊推理优化。由于其参数更新正交,模型在多个下游任务上的表现更加均衡,减少因任务漂移引发的线上事故。
- 数据管线:企业可按照现有数据标注流程为各任务单独收集偏好数据,无需精心混合比例,降低数据工程复杂度。RL 对梯度方差的天然约束使得训练对超参数的选择更加鲁棒。
具体落地用例
跨境电商客服机器人:需同时处理多语种翻译、商品推荐、退换货政策问答、情绪安抚等任务。采用 Parallel-RL,可对每个任务独立训练奖励模型,并行优化主模型。例如,在“退货引导”与“新品推荐”两个任务中,传统 SFT 会导致模型因梯度冲突而偏向单一行为,而 RL 能够保持两种能力的稳定共存,从而在真实对话中灵活切换,提升客户解决率和复购率。
医疗辅助诊疗系统:需整合症状自查、检查建议、用药禁忌、沟通共情等多个子任务。通过 Parallel-RL 进行多任务 RL 训练,可避免模型过度关注高频任务(如常见病咨询)而遗忘低频但关键的任务(如罕见副作用提示),确保医疗场景下的安全性与全面性,同时减少二次人工审核成本。
局限
- 理论分析建立在RL中使用优势归一化和on-policy优化这一前提上,对于离线RL或SFT中引入类似基准方差的变体,结论的推广性尚未验证。论文在数学和代码推理任务上观测到RL更新的稀疏性与近似正交,但缺乏更广泛任务类型(如开放域对话、知识密集型QA)的验证,可能高估了现象的普适性。
- Parallel-RL框架需要一个任务判别器来为每个样本分配任务,实际部署时可能面临判别误差累积,且独立优化各任务会屏蔽跨任务的共享表示学习,丢失潜在的迁移收益。此外,尽管声称解耦提高了灵活性,但多任务各自前向反向传播,在序列执行时计算资源竞争仍可能限制实际加速比。
- 实验主要对比了SFT与RL在数学推理上的差异,缺乏在主流多任务基准(如MMLU、Big-Bench)上的评估。与多任务SFT基线的对比任务数量少,不足以全面刻画不同领域下的冲突严重度及Parallel-RL的相对优势,结果的外部效度有待加强。