SmartMage: 动态模态编排用于3D场景理解
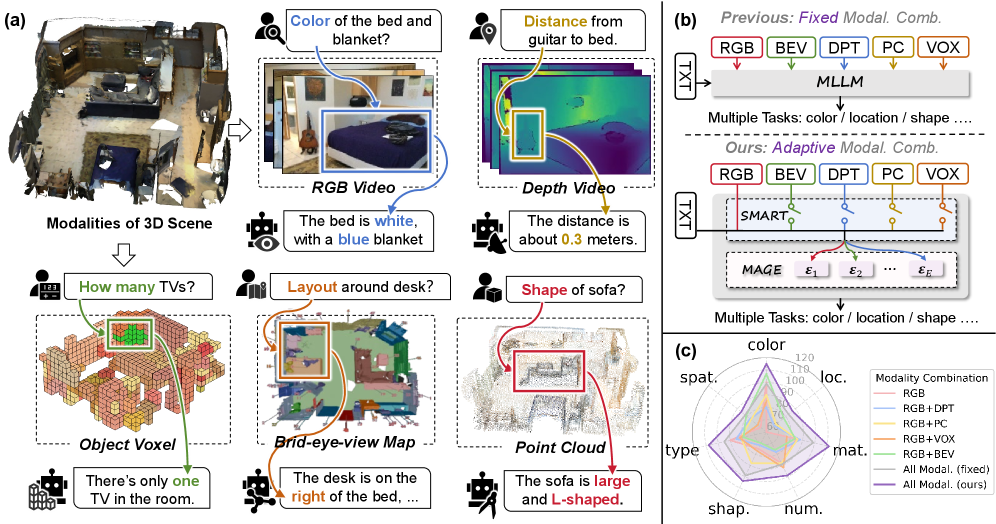
理解3D场景是具身智能的基础,需要对视觉、几何等多种模态的异构信息进行联合推理。然而,现有多模态大语言模型(MLLMs) 通常依赖固定的模态组合,忽视了查询相关的模态需求。这种刚性设计会引入无关模态的语义噪声,同时忽略信息量更大的模态,导致计算浪费和推理能力下降。 为此,本文提出SmartMage,一个统一的多模态大语言模型,能够动态编排异构模态,实现语义感知的3D场景理解。具体包括两个创新模块: 1. 语义引导的模态自适应路由(SMART):利用语义先验、文本-模态对齐和模态质量,选择任务相关的模态。 2. 模态感知门控专家(MAGE):利用模态先验指导专家激活,促进多模态推理中的自适应特化。 实验结果表明,SmartMage 在五个3D场景理解基准 上达到最先进水平,并在RGB-only视频理解基准 上取得有竞争力的结果。在诊断性基准ScanFacet中,任务被划分为细粒度语义类别,进一步分析了每种语义类型偏好的模态组合,验证了SmartMage 的有效性。项目主页:https://yuecheong.github.io/SmartMage/。
论文精读
TL;DR SmartMage 通过语义引导的动态模态路由与专家门控,让多模态大模型根据查询按需组合视觉与几何线索,在多个3D场景理解基准上取得最优性能,并首次系统揭示了不同语义任务对模态的偏好规律。
问题
在具身智能等应用中,3D 场景理解要求联合处理 RGB 图像、深度图、点云等多种模态信息,以支持视觉与几何推理。当前,多模态大语言模型(MLLM)已成为该领域的主流方法。
然而,现有 MLLM 大多采用固定的模态组合,即对任意查询都输入相同的多模态数据。这种刚性设计忽略了查询相关的模态需求:例如,“沙发是什么颜色?”仅需视觉 RGB 数据,而“椅子和桌子有多远?”则高度依赖几何点云。固定组合不仅浪费计算资源,更会引入语义噪声——不相关的模态数据可能干扰 LLM 的推理,导致性能下降。实验表明,无关模态的强制融合反而会稀释有用信息。
该问题的核心难点在于,模态的价值随查询语义动态变化,且受场景条件(如光照、遮挡)影响。如何让模型自动感知查询意图,并动态选择高质量、高相关的模态子集进行融合,是一个兼具理论与工程价值的挑战。随着具身智能、自动驾驶等场景对实时性和鲁棒性要求日益提高,工业界迫切需要一种计算高效且能保持高精度的动态模态编排方案。
与此类似,在自动驾驶感知系统中,工程师会根据天气条件(如雨雾)动态调整传感器融合权重,以避免低质量数据污染决策——这正是 SmartMage 探索的模态自适应路由思想在 3D 理解中的体现。
核心洞察
- **动态模态选择取代固定组合**: SmartMage 的核心突破在于通过 **SMART** 模块实现了查询感知的模态路由,打破了现有 MLLM 对多模态数据采用固定融合策略的惯例。传统方法无论查询需求,始终输入全部模态特征,不仅引入与任务无关的语义噪声,还浪费计算资源。SMART 利用语义先验、文本-模态对齐度及模态质量打分,自适应地为每个查询挑选最相关的模态子集,例如在识别物体形状时优先使用点云,而在理解颜色时侧重 RGB 图像。这种按需路由机制从源头抑制了无关信息的干扰,为多模态推理的效率与精度平衡提供了新范式。
- **模态感知门控激活专长分化**: **MAGE** 模块在 MoE 框架中引入模态先验,引导门控网络根据输入模态组合动态分配 token 给不同的专家子网络。与常规 MoE 仅基于 token 内容进行路由不同,MAGE 显式编码了模态来源信息,使得专家能够针对特定模态组合(如 RGB+点云、单模态 RGB 等)形成功能性专业化。在 ScanFacet 细粒度语义测试中,这种设计让模型在面对不同语义类别的问题时,自动激活擅长处理相应模态配比的专家,从而在保持计算效率的同时,大幅提升了多模态协同推理的效果。
方法
输入与特征提取
SmartMage 接收 多模态场景数据,包括 RGB 视频帧、深度图、点云 和 体素。首先,通过 Omni-modal 3D Scene Feature Extractor 将各模态转换为统一特征表示:
- 关键帧由 FoVSR (Field-of-View-based Keyframe Selection) 筛选,保证视角覆盖并降低冗余。
- 3D 几何通过 BEV 渲染、深度补全与归一化,生成点云和体素特征。
- 各模态特征经独立编码器投影至共享嵌入空间,形成一组候选 模态 token 集合。
动态路由:SMART 模块
Semantic-guided Modality Adaptive RouTing (SMART) 负责“什么时候用哪个模态”:
- 语义先验:从问题文本提取语义标签,预判任务类型(如空间关系推理、属性描述)。
- 文本-模态对齐:计算问题嵌入与每个模态 token 的相似度,筛选出强相关模态。
- 模态质量评估:对光照、遮挡等噪声建模,避免选择低质量模态(如暗光下的 RGB)。
路由输出一个 稀疏激活模态子集,未被选中的模态不会参与后续推理,从而抑制语义噪声,减少计算开销。
门控专家:MAGE 模块
Modality-Aware Gating Expert (MAGE) 负责“怎么用已选中的模态”:
- 采用 MoE (Mixture of Experts) 架构,每个专家为一组可学习前馈网络。
- 门控网络融合 模态先验(该模态的典型效应)与当前任务上下文,动态分配专家权重。
- 不同模态激活不同专家子集,促使专家逐渐特化——例如一部分专家专攻几何推理,另一部分专攻视觉属性。
- 最终由 LLM 解码器 对激活专家输出及文本 token 进行联合自回归生成。
训练与优化
- 整体端到端优化:路由与专家网络联合训练,损失函数包括 任务损失(交叉熵) 和 路由正则项(鼓励稀疏性与多样性)。
- 诊断基准 ScanFacet 将任务按细粒度语义分类(如“计数”“方位判断”),可直接观察不同语义下模态组合偏好,验证 SMART 路由的有效性。
与同类方法的差异点:现有 MLLM 大多采用固定模态集(如“直接拼接 RGB + 点云”),而 SmartMage 首次通过“语义感知路由 + 模态感知门控”实现动态模态编排,在 3D 理解基准上达到 SOTA,并保持对纯 RGB 视频任务的兼容性。
实验
实验设计
SmartMage 在 五个 3D 场景理解基准 上进行评测,涵盖 3D 视觉问答 (ScanQA)、3D 视觉定位 (ScanRefer, Nr3D, Sr3D) 及作者提出的细粒度诊断基准 ScanFacet。同时,为验证泛化性,还在 RGB-only 视频理解基准 上进行了对比。
关键发现
- 动态模态路由有效:SmartMage 的 SMART 模块 能根据查询语义自适应选择视觉、几何等模态,避免固定组合引入的噪声,在 ScanFacet 上观察到明确的模态-语义偏好模式(如空间关系类任务偏好点云,颜色类任务偏好 RGB)。
- 性能达到 SOTA:在五个 3D 基准上全面超越固定模态组合的 MLLM,说明模态适应性对 3D 场景理解至关重要。
- 计算效率提升:通过门控专家 MAGE 模块 实现模态特化推理,减少无关模态带来的计算浪费。
与基线对比解读
传统 MLLM(如 3D-LLM, LEO)将多种模态特征简单拼接后送入 LLM,忽略了不同查询对模态需求的差异。SmartMage 首次在统一框架内实现 查询感知的模态调度,不仅性能更高,还揭示了模态与任务之间的内在关联,为构建更高效、可解释的多模态 3D 理解系统提供了新思路。
行业影响
落地场景
SmartMage 的动态多模态路由机制适用于各类需要理解 3D 场景的交互式 AI 产品。典型落地场景包括:
- 具身机器人:在家庭服务或仓储物流中,机器人需根据语音指令动态融合 RGB、深度、点云等信息,避免无关模态干扰,提升抓取、导航精度。
- AR/VR 内容平台:虚拟助手根据用户自然语言查询,实时从 3D 场景中提取语义对象,提供沉浸式导览或维修指引。
- 自动驾驶仿真与标注:在数据闭环中,根据任务类型(如检测、问答、描述)自适应选择视觉与几何特征组合,提高自动化标注效率。
商业价值
- 降本增效:动态路由避免了固定全模态推理带来的冗余计算,尤其对边端设备(如机器人、AR 眼镜)可降低延迟与能耗。训练时通过语义指导的门控专家网络(MAGE) 实现参数稀疏激活,减少推理成本。
- 体验提升:任务感知的模态选择能过滤噪声,使回答更精准。例如,在“找出缺了腿的椅子”查询中,模型优先利用几何模态而非纹理,避免误判,直接提升用户满意度与信任度。
与现有产品/工作流的接口
- 模型即服务:可将 SmartMage 封装为微服务,通过标准 API 接收文本指令和多模态数据流(点云、图像序列),返回结构化答案。可插入现有 MLLM 编排层(如 LangChain),作为 3D 理解工具调用。
- 数据处理管线:已有的 3D 场景感知 pipeline 可复用文章中的多模态提取器(FoVSR 关键帧、BEV 投影等),并将静态的全特征拼接替换为 SMART 路由,以插件形式集成,无需重构全局架构。
具体落地 Use Case
- 智能仓储机器人:客户下达“移走托盘左上角的红色箱子”指令,机器人利用 SmartMage 动态匹配 RGB 与深度模态,忽略点云噪声,快速定位目标并规划无碰撞路径。
- 在线家装平台:用户上传房屋点云扫描,提问“如何调整布局让光线更好?”,模型激活几何与光照相关模态,忽略纹理细节,生成专业建议,提升设计辅助工具转化率。
局限
- **训练依赖多模态数据完整性**:**SmartMage** 在训练阶段需要所有候选模态(如 RGB、深度、点云)同时可用,以学习 **SMART** 路由与 **MAGE** 专家的联合优化。但在实际部署中,部分模态可能因传感器故障或场景限制而缺失,此时路由模块是否能稳定退化到可用模态子集尚不明确。论文未报告在模态缺失条件下的性能表现,也未讨论如何利用多任务学习或数据增强来提升对不完整输入的鲁棒性,这限制了其在资源受限的具身智能场景中的适用性。
- **路由机制的计算与决策精度权衡**:**SMART** 模块引入语义先验、文本-模态对齐与质量评估,增加了额外的推理开销。虽然声称动态选择可节省无关模态的计算,但路由网络自身的前向传播成本、以及潜在的多模态 token 拼接操作并未在实验中被量化(如 FLOPs、延迟)。如果采用软融合(soft-routing)代替硬选择,则依然需要处理所有模态,导致实际效率红利有限;若采用硬选择,又可能因路由错误而丢失关键信息,这一设计决策在工程落地时需谨慎评估。
- **诊断基准的生态效度与专家机制的浅层利用**:**ScanFacet** 提供了细粒度语义类别的模态偏好分析,但其覆盖的场景与语义种类有限,观察到的模态-语义关联规律能否直接迁移到大规模真实世界数据存疑。此外,**MAGE** 模块目前主要将模态类型标签作为引导信号来激活专家,未引入更丰富的模态内容特征(如不确定性估计、跨模态特征差异)进行更深层的自适应专家融合,限制了专家网络从模态互补性中学习更复杂推理策略的潜力。