损失不看基,但 Adam 看
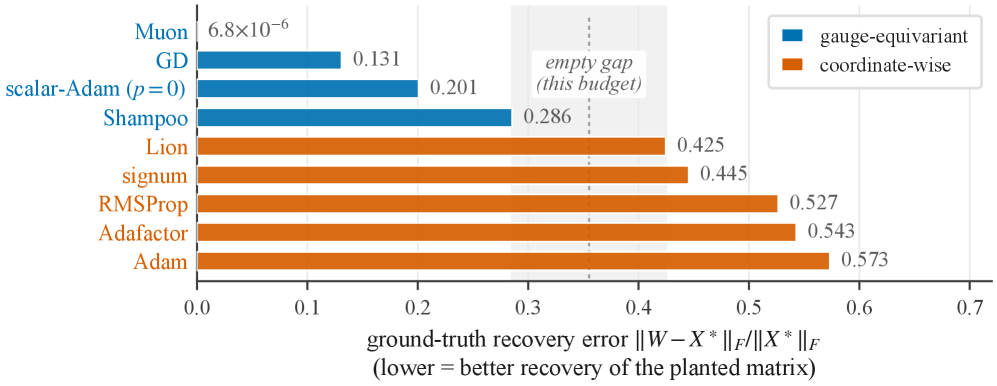
规范等变性 是优化器能否继承梯度流低秩偏置的关键。在因子化模型 W = UV^T 中,损失函数具有规范对称性,即在 (U, V) - (UQ, VQ) 下不变。梯度下降、动量、shared-scalar Adam、Muon、Shampoo 满足规范等变,而 Adam、RMSProp 等逐坐标方法不满足,因此从相同的小初始化出发,Adam 会偏离低秩解。 结构定理 表明,无记忆的等变规则恰好是 Gram 矩阵决定的左预条件算子;传递定理 将梯度流的路径性质推广到共享标量流。在欠定矩阵感知实验中,从逐坐标到共享标量预条件的一参数族单调地恢复低秩偏置,揭示各向异性是 Adam 失效的根源。spectral schedule 调和了关于 Muon 的矛盾结果:等速率更新能精确恢复低秩目标,但谱尾增长时优势消失。 在 Transformer 中,Adam 在第一步就区分两种规范等价的初始化,而等变优化器保持在浮点精度内;最终 WQ^T WK 的相对 Frobenius 距离相差 56%,无法通过逐头旋转消除。在两个高光谱数据集上,训练损失相同时,梯度下降在最低采样密度下将留出误差降低 43–44%,且有效秩更低。因此,基的选择不是调参细节,而是决定优化器选择哪种插值函数的决策。
论文精读
TL;DR 该研究证明 Adam 等坐标自适应优化器因缺乏 gauge 等变性而丧失低秩偏向,导致 Transformer 中注意力头分歧;而梯度下降等保持等变性的优化器能显著提升泛化,为优化器设计提供了新准则。
问题
问题背景
当前深度学习领域高度关注优化器在过参数化模型中的隐式偏差,尤其是它对解的结构(如低秩性)的偏好如何影响泛化。在因子分解模型 $W = UV^\top$ 上,这种偏差直接决定了模型在矩阵感知、Transformer 注意力等任务中收敛到哪种解。
现有方法局限
主流自适应优化器如 Adam、RMSProp 等采用坐标级(coordinate-wise) 预条件,这破坏了损失函数对基底变换的规范对称性(即 $(U, V) \mapsto (UQ, VQ)$ 下 $W$ 不变)。因此,即便从相同小初始化出发,它们也无法像 梯度下降 那样自然地导向低秩解。过去的工作虽然观察到 Adam 在因子化模型上缺乏低秩偏好,但缺乏一个统一的理论来解释哪些更新规则保持等变性、等变性与低秩恢复的精确关系,以及这一差异在真实 Transformer 训练中的定量影响。
为什么这个问题既难又重要
困难在于优化器动力学与模型的连续对称性相互纠缠:分析需要追踪更新规则在规范轨道上的行为,且等变性是低秩偏好的必要条件但非充分条件。重要性上,Transformer 自注意力头天然具有相同的规范对称性,这意味着在训练 $W_Q$、$W_K$ 等投影矩阵时,优化器的选择会深度影响每个注意力头的基底,进而决定 $W_Q^\top W_K$ 等规范不变量。这一差异在模型合并、微调或蒸馏时可能被放大——同一损失下、仅因优化器不同,模型可以收敛到互不可旋转等价的注意力结构,直接挑战了“损失决定一切”的直觉。
行业类比
类似在 LoRA 微调中,不同优化器可能驱动适配器矩阵 $A$、$B$ 学到不同基底,即使合并后的权重相近,在多任务融合时仍可能因内部结构差异导致干扰。
核心洞察
- 优化器的规范等变性决定了它能否继承低秩隐式偏置:梯度下降在因子化模型上自动偏好低秩解,而 Adam 等坐标自适应方法因打破了损失函数的规范对称性(gauge symmetry),导致这一偏置消失。不同于以往只从收敛速度或泛化角度比较优化器,本文从群对称性的角度严格区分了两类优化器:规范等变者(如 GD、Muon、Shampoo)能保持等秩更新轨迹,坐标方法则从第一步就产生分歧,这一视角为优化器选择提供了全新的理论依据。
- 各向异性的预条件化是破坏低秩偏置的根源:通过一个连续参数调整坐标级到共享标量的预条件化,实验表明低秩恢复能力单调恢复,直接隔离出坐标自适应方法的各向异性(anisotropy)是罪魁祸首。这解释了为何即使训练损失相同,不同优化器选出的解在基底上差异巨大,在 Transformer 注意力头上可达 56% 的相对 Frobenius 距离,说明基底选择不是调参细节,而是决定了优化器走向哪个插值解,对模型融合、蒸馏等实际工程有深远影响。
方法
本研究提出一种基于规范对称性 (gauge symmetry) 的框架,系统分析因子模型上优化器的隐式低秩偏向。
核心理论框架
输入:因子模型 W = UV^T,损失对规范变换 (U, V) → (UQ, VQ) 保持不变,其中 Q 为正交矩阵。
关键模块:
- 规范等变性定义:若优化器更新后参数在规范变换下的等价关系得以保持,则称该优化器是规范等变的。
- 分类定理:
- 梯度下降、动量、Shared-Scalar Adam、Muon、Shampoo 满足规范等变。
- Adam、RMSProp 等坐标自适应方法因各向异性预处理而破坏等变性。
- 结构定理 (Structure Theorem):无记忆的等变更新规则全部可表示为
U_{t+1} = U_t - η P(G) G,其中P为 Gram 矩阵G = U^T U(或类似) 决定的左预处理器。 - 转移定理 (Transfer Theorem):等变优化器的连续极限继承了梯度流的路径性质 (如低秩恢复)。
输出:优化器的等变性与否直接决定了其收敛解能否保持低秩结构。
实验验证设计
- 矩阵感知任务:在欠定条件下比较 9 种优化器,通过一维参数族 (从坐标级到共享标量预处理) 连续调节,证明各向异性是造成低秩偏向丧失的原因。
- Transformer 注意力实验:以规范等价的
W_Q,W_K初始化,Adam 从第一步开始分离两个初始化 (最终W_Q^T W_K相对 Frobenius 距离相差 56%),而等变优化器保持浮点精度下等价。 - 高光谱数据:相同训练损失下,梯度下降相比 Adam 将测试误差降低 43–44%,且解的有效秩更低。
- Muon 谱调度:针对频谱尾部长场景,提出等速率更新规则,调和此前关于 Muon 的矛盾结论。
与同类方法的差异点:本文首次将规范等变性作为优化器隐式偏差的分水岭,从对称性角度解释了坐标自适应方法失去低秩偏向的根本原因,而非仅视为调参细节。
实验
实验设计
论文围绕规范等变性是否影响优化器低秩偏好展开实验。主要设计包括:
- 在因子化矩阵感知任务中,对比9种更新规则(梯度下降、Adam、Muon、Shampoo等)的恢复误差。
- 在Transformer注意力头中,对两个规范等效初始化进行跟踪,测量优化后头不变量
W_Q^T W_K的相对Frobenius距离。 - 在两个高光谱数据集上,匹配训练损失比较梯度下降与Adam的测试误差和有效秩。
- 通过连续调节预条件各向异性,观察低秩偏差的单调恢复。
- 针对Muon的谱尾部相图,探究等变类内部行为差异。
关键发现
- 等变 vs. 非等变:坐标自适应优化器(Adam、RMSProp)打破规范等变性,丧失低秩偏差,在欠定回归中趋向于高秩解;而等变优化器(梯度下降、动量、Muon、Shampoo)保持偏差。
- 注意力头分离:Transformer中,Adam在第一步便使两个规范等效初始化产生显著差异,最终头不变量距离达56%,而等变优化器始终保持在浮点精度内。
- 高光谱泛化:训练损失相同时,梯度下降的测试误差比Adam低43-44%,并收敛到更低有效秩的解,说明优化器选择了不同的插值函数。
- 各向异性是元凶:通过共享标量预条件逐步替代逐坐标预条件,低秩偏差单调恢复,证实坐标级自适应是丢失偏差的核心原因。
与基线对比解读
传统观点认为自适应优化器加速收敛,但其隐式偏差可能根本不同。相较于梯度下降的确定性低秩解,Adam倾向于产生依赖坐标尺度的解,这在冗余参数化模型中造成表示分歧。例如,同一Transformer的不同初始化经Adam训练后,注意力头不变量差异巨大,无法通过头旋转对齐,这对模型合并、知识蒸馏等实践有直接负面影响。而等变优化器(包括Muon等结构化方法)保持规范不变性,解由损失景观决定,而非优化器人为引入的坐标系。但等变方法并非万能:当谱尾部能量较大时,其优势减弱,此时通过谱调度或部分共享标量(如FlowAdam-p)可在两者间权衡,为优化器设计提供了新维度。
行业影响
落地场景
该论文揭示的优化器规范等变性(gauge equivariance)差异,对大模型训练、低秩适应(LoRA)和矩阵分解推荐系统有直接指导意义。在Transformer类架构中,注意力头的权重矩阵存在规范对称性,Adam等坐标方向优化器会破坏隐式低秩偏向,导致不同初始化产生不可约的表示偏离。这一发现可应用于模型合并、稀疏化、蒸馏等需要对齐权重空间的场景,帮助工程师选择更合适的优化器以避免表示坍塌或对齐失败。在**矩阵感知(matrix sensing)**任务中,规范等变优化器(如梯度下降、Muon)能自动恢复低秩结构,降低采样复杂度,适合小样本场景。
商业价值
- 降本:通过强制隐式低秩偏向,可以在保持精度的前提下降低模型部署时的参数量(如权重矩阵隐式低秩),减少推理成本。
- 性能提升:在高光谱数据等真实任务上,梯度下降在匹配训练损失时将测试误差降低43–44%,直接提升产品指标。
- 模型合并可行性:当模型使用规范等变优化器训练时,不同微调分支的权重可通过对角旋转等简单方法合并,降低多任务部署的维护成本。
与现有产品/工作流的接口
现有训练框架(如PyTorch、JAX)已实现大多数所述优化器。工程团队可通过配置选择或自定义优化器来开关低秩偏向:对于需要低秩结构(如矩阵分解推荐、注意力头压缩)的任务,可选用Muon、Shampoo等规范等变优化器;对于需要稀疏或特征分离的任务,可保留Adam。论文提出的“谱调度(spectral schedule)”方法能调和两种需求,可作为优化器超参数的一部分直接接入训练脚本。诊断工具(如计算不同初始化下注意力头W_Q^T W_K的相对Frobenius距离)可集成到模型评估流水线,监控表示稳定性。
具体Use Case
- 电商推荐系统中的隐式反馈矩阵分解:使用Adam常需显式加低秩正则化以防止过拟合;改用Muon可能通过隐式偏差自动得到更简洁的低秩因子,减少超参数调试,提升冷启动下的泛化。
- 企业级多任务模型合并(如多领域NLP服务):各任务独立微调后,若均采用规范等变优化器,则可在基础模型上直接进行权重合并(如简单平均)而无需重新训练或昂贵的融合蒸馏,显著降低线上更新成本。
局限
- **理论充分性尚未闭合**:论文证明规范等变性是优化器传递低秩偏差的必要条件,但并非充分条件。即使在规范等变类内部,不同方法(如标准梯度下降、Muon、Shampoo)的恢复行为仍可能不同,文中提出的“谱调度”仅部分解释了这种差异,缺乏完整刻画何时能成功恢复低秩解的充分条件理论。
- **实验验证集中在诊断性场景**:多数结论在受控的矩阵感知任务、注意力头初始化对比及两个高光谱数据集上得出,尚缺乏在大规模实际任务(如十亿参数语言模型预训练、视觉大模型)上的验证。提出的共享标量 Adam 变体(FlowAdam)等尚未在真实大模型训练中与广泛使用的 Adam 进行充分对比,其实用性存疑。
- **工程落地代价不明确**:规范等变优化器(如 Muon、Shampoo)需要矩阵运算,增加了计算开销;共享标量调度需要额外调参,从 Adam 迁移到这类优化器面临工程复杂度与性能收益的权衡。论文未给出明确的迁移指导,对希望将理论应用于实践的 AI 工程师而言,仍缺少可操作的处方。