OPD-V:视觉在线策略自蒸馏与模态平衡
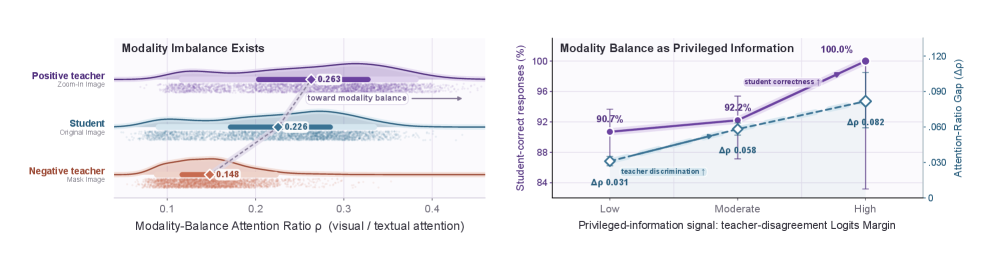
在线策略自蒸馏(OPSD)已成为提升多模态大语言模型(MLLMs)视觉推理能力的标准后训练方法。现有方法从多种输入源提取特权信息来引导自蒸馏,但忽略了MLLM推理中固有的模态失衡 问题。当文本信息主导生成时,模型无法充分整合多模态输入,精心设计的特权信息因此未被充分利用,限制了OPSD的效果。 为探究此限制,我们构建了正教师(使用放大图像)和负教师(使用遮罩图像),二者表现出不同程度的模态失衡。其推理正确性与token逻辑值的变化表明,模态平衡 本身即可作为特权信息。受此启发,我们提出OPD-V,一种视觉OPSD范式,通过正负教师实例化该信息。正模态平衡逻辑值边际 定义了模态平衡信任区域,用于选择进行自蒸馏的在线策略token。 在6个基准、4种MLLM主干和5种后训练方法上的实验表明,OPD-V持续提升推理性能,同时降低训练成本。
论文精读
TL;DR OPD-V 发现**模态平衡**本身可作为在策略自蒸馏的特权信息,通过正负教师定义**模态平衡信任区域**,高效提升多模态大模型的视觉推理性能并降低训练成本。
问题
问题背景
多模态大模型(MLLM)的视觉推理能力是当前 AI 研究的核心议题。为提升模型在视觉问答、图表理解等任务上的表现,On-Policy Self-Distillation (OPSD) 已成为主流的后训练范式。其本质是让模型从自身采样生成中学习,并利用额外的“特权信息”引导自蒸馏过程,以期突破监督微调的性能上限。
现有方法局限
现有 OPSD 方法虽尝试从多种输入来源抽取特权信息(如高质量标注、增强视图等),却普遍忽视了一个根本性障碍:模态不平衡 (Modality Imbalance)。在 MLLM 推理中,文本信号往往占据主导地位,导致模型习惯性依赖语言先验,而未能充分整合视觉输入。即使提供了精心设计的视觉特权信息,模型也可能因视觉通道被抑制而无法有效利用。这造成了“特权信息虚置”的困境:模型表面上接受了多模态指导,实际决策仍由文本侧驱动,限制了 OPSD 增益的上限。换言之,不解决模态不平衡,OPSD 就难以真正挖掘视觉推理的潜力。
技术挑战与重要性
模态不平衡源于 MLLM 架构中语言模块过强、视觉编码器相对薄弱的原生特性,同时训练数据中视觉-语言对齐不够精细,使得模型极易滑向文本捷径。克服该问题意味着必须设计一套机制,既能量化模态平衡程度,又能将其转换为可指导训练的信号。这在技术上挑战巨大:模态平衡本身不是显式标签,而是隐藏在 logit 分布中的动态属性。学术界与工业界对此高度关注,因为任何视觉指令执行、场景理解、跨模态事实性的提升,都依赖于模型是否真正“看见”而非“猜出”答案。该方向的突破将直接影响可信多模态系统的部署。
行业类比:这种困境类似自动驾驶感知系统:若模型过度依赖高精地图文本标注而忽视实时摄像头图像,在施工改道等动态场景下将产生致命误判——只有强制模型平衡多模态证据,才能实现稳健推理。
核心洞察
- **模态平衡本身是一种被忽视的特权信息**:传统 OPSD 方法从外部知识源抽取特权信息,却未关注 MLLM 内部因视觉信息不足导致的模态不平衡。OPD-V 通过放大和掩码图像构造正负教师,显式量化学模态平衡对推理正确性和 token logits 的影响,首次将模态平衡定义为可蒸馏的监督信号,而非依赖额外的文本知识或模型规模。
- **基于信任区域的 token 选择实现高效自蒸馏**:不同于全局蒸馏,OPD-V 利用正负教师的 logits 差异构建“模态平衡信任区域”,仅对区域内的 on-policy tokens 进行蒸馏。这种选择性策略既避免了在模态失衡 token 上引入噪声监督,又缩短了 rollout 长度,在提升推理性能的同时显著降低了训练步时,为资源受限场景提供了工程友好的自蒸馏范式。
方法
OPD-V 将On-Policy Self-Distillation (OPSD) 应用于多模态大模型 (MLLM) 的视觉推理任务,其核心创新在于将“Modalitiy Balance”本身作为特权信息来指导蒸馏过程。
输入与教师构建
给定图像-文本查询对,模型生成多个候选回答(on-policy sampling)。同时,对输入图像执行两种变换,构造两个教师模型:
- Positive Teacher:输入
Zoom-In Image,即对图像关键区域进行裁剪放大,强化视觉细节,使模型更依赖视觉信息进行推理。 - Negative Teacher:输入
Mask Image,即随机遮挡图像部分区域,人为削弱视觉信号,迫使模型主要依赖语言先验。
两个教师对同一问题分别计算输出 logits,其差异反映了每个 token 对视觉信息的依赖程度,即**“Modality Balance”的量化信号**。
模态平衡信任区域
计算 Positive Modality-Balance Logits Margins:正教师 logits 减去负教师 logits,并按 top-K 策略选取差异最大的 token 集合。这些 token 构成了Modality-Balance Trust Region,代表模型在推理时真正需要整合视觉信息的关键步骤。只有落入该区域的 token 才参与后续自蒸馏。
OPD-V 目标与训练
在信任区域内的 token 上,学生模型(即当前训练的 MLLM)被强制匹配正教师的 logits,使用标准的蒸馏损失(如 KL 散度)。对于区域外的 token,不施加蒸馏约束,避免引入噪声。这种选择性蒸馏使梯度更新集中于提升视觉-语言对齐的关键推理环节,同时减少对简单语言模式的过拟合。
计算效率
由于仅需生成短链式回答(而非长链思维),且教师输入构建轻量(Zoom-In/Mask 操作几乎无额外开销),OPD-V 比传统 OPSD 方法显著降低了单步训练时间。
与同类方法的差异:现有 OPSD 方法通常引入辅助信息源(如高分辨率图、思维链)作为特权信息,却未考虑模态不平衡导致这些信息被忽略;OPD-V 则通过正负教师对比直接“探查”模型的视觉依赖模式,将模态平衡信号转化为 token 级权重,无需额外监督即可强化视觉推理能力。
实验
实验设计
通过构建正教师 (Zoom-In Image) 与负教师 (Mask Image) 来量化模态不平衡,并在 6 个基准、4 个 Qwen 系列 MLLM 骨干 (Qwen3-VL-8B/4B, Qwen3.5-9B/4B) 上,对比了 5 种后训练方法。主要评估视觉推理性能、响应长度、策略熵及训练效率。
关键发现
- 一致性能提升: OPD-V 在所有基线和模型尺度上提升推理准确率,同时保持响应简洁,避免冗长。
- 模态平衡信任区域有效: 该方法定义的信任区域能稳定选择用于自蒸馏的 on-policy token,且训练中保持策略熵稳定,表明学习过程平稳。
- 计算效率提高: 更短的 rollout 和更高效的特权输入构造显著降低了训练步时。
- 互补监督: 正教师与负教师提供的梯度方向互补,且 Zoom-In + Mask 操作对在所有测试操作中效果最佳。
与基线对比
相比标准 OPSD 方法,OPD-V 将视觉模态平衡直接作为特权信息,克服了模态不平衡导致特权信息利用不足的难题。传统 OPSD 依赖多样化输入源,但未考虑视觉信息被文本主导时会被抑制;OPD-V 通过正负边距定义信任区域,仅选择对视觉平衡有利的 token 进行蒸馏,在不增加额外推理开销的情况下,更高效地注入视觉信号,因此训练成本更低且泛化更强。
行业影响
落地场景
OPD-V 针对多模态大模型(MLLM)的视觉推理后训练,可广泛用于需要精准融合图文信息的场景:
- 视觉问答 (VQA) 与 图像描述:在电商客服、内容平台中,用户上传图片并提问,模型需避免文本偏见,准确捕捉图像细节。
- 文档理解与信息抽取:金融、法律领域的扫描件分析,要求模型充分提取视觉元素(表格、签章)而非仅依赖OCR文本。
- 医疗影像辅助诊断:结合影像与病历,模型推测病灶时需平衡视觉特征与文本先验,OPD-V 的模态平衡机制可提升关键视觉信号的利用。
- 自动驾驶:多模态场景理解(路况图+传感器文本),强化视觉推理有助于减少幻觉,提升安全决策。
商业价值
- 降本增效:OPD-V 通过更短的 rollout 和高效的特权输入构建,降低训练步时,直接减少 GPU 成本;同时保持或提升模型性能,缩短后训练周期。
- 体验提升:在客服、搜索等交互产品中,更准确的视觉推理可直接提升用户满意度与转化率。
- 风险控制:在医疗、金融等场景,避免视觉信息被文本主导导致的误判,降低业务差错带来的合规风险。
与现有工作流的接口
OPD-V 作为视觉 On-Policy Self-Distillation (OPSD) 的增强范式,可无缝嵌入现有 MLLM 训练流水线:
- 即插即用:在 SFT 之后,代替或补充传统 OPSD(如 SPIN、Self-Rewarding)方法,只需额外构建 Zoom-In/Mask 两种图像操作。
- 兼容主流框架:与基于 logits 的蒸馏(如 KL 散度、Top-K 蒸馏)和 RLHF 流水线(PPO/DPO)兼容,可直接在训练循环中加入 Modality-Balance Trust Region 的 token 选择逻辑。
- 低侵入性:无需修改模型架构,仅在后训练阶段引入两个教师信号,对现有 MLLM 生态(如 Qwen-VL、LLaVA)友好。
具体落地用例
- 跨境电商多模态客服:用户拍摄商品瑕疵照片要求理赔。模型需根据图像(Zoom-In 可提供细节)判断问题,而非仅依赖文本描述。OPD-V 训练后的模型能更可靠地利用视觉证据,减少误判带来的客诉。
- 保险理赔定损:上传事故车辆照片,模型需结合图像与保单文本给出修理建议。OPD-V 的负向教师(Mask 图像)能抑制视觉信息不足时的文本幻觉,提升定损准确率,避免理赔金额高估。
局限
- **方法对视觉操作的依赖与泛化边界**:OPD-V 通过 Zoom-In 和 Mask 操作构建正负教师,但论文未在其他类型视觉扰动(如模糊、颜色变换、遮挡区域大小)上验证。不同数据集和推理任务的模态依赖模式可能差异显著,单一操作对可能无法在所有场景下保持最优的平衡信任区域,泛化性存疑。此外,纯文本 CQA 任务或文本占主导的推理中,视觉平衡信号的作用可能微弱,该方法可能不必要地增加计算成本。
- **信任区域超参数的敏感性与自动调优**:Modality-Balance Trust Region 依赖 logits margin 阈值来筛选 token,但论文未系统讨论阈值对性能的敏感度。不同模型规模、训练阶段可能需要动态调整,固定阈值可能导致早期丢弃过多有效 token 或后期包含噪声。实际落地时,可能需要额外验证集上搜索,增加了部署复杂度。同时,正负教师的推理开销虽声称降低,但在超大模型(如百亿参数以上)上的额外前向传递和 logits 计算仍可能成为资源瓶颈。
- **实验覆盖的模态不平衡场景有限**:论文在 6 个基准、4 种 MLLM 骨架上验证,但所选的视觉推理任务(可能为 VQA、Captioning 等)未必充分反映长尾、低资源视觉关系中的极端模态不平衡。另外,未与近期其他解决 MLLM 模态偏向的工作(如视觉对比解码、模态权重重校准)直接对比,因此 OPD-V 在更广泛的多模态场景下的相对优势尚不明确。未来需在更复杂的交错视觉-语言输入下评估其鲁棒性。