Adversarial Attacks for Good: 视觉内容全生命周期主动保护综述
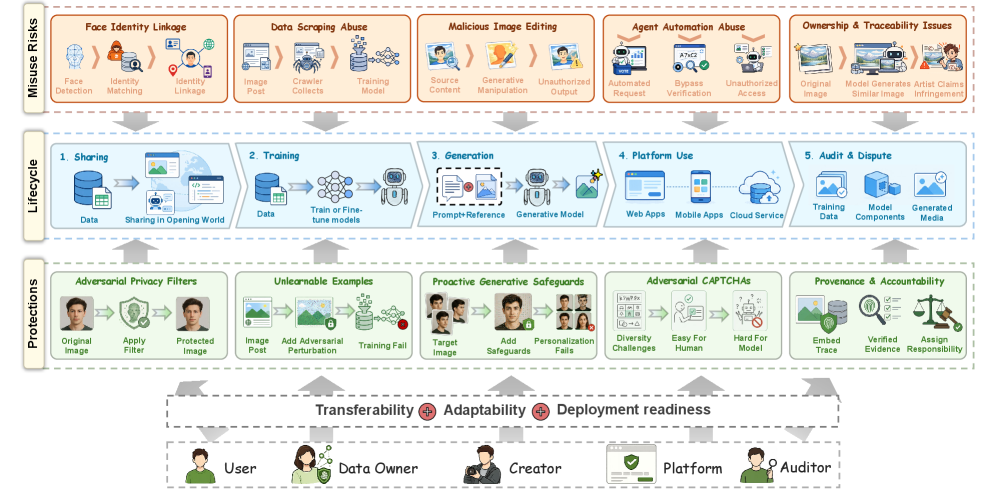
当视觉内容进入 AI 流程,所有者往往对其使用缺乏技术控制。法律与监管可事后追责,但许多技术干预需在内容发布或访问时提前执行。本综述聚焦这一干预点上的保护范式——adversarial attacks for good,即把原本用于攻击学习模型的扰动与结构化信号,反向用于干扰未授权自动化、支持后续问责。 五个研究社区几乎独立地发展出这一理念,覆盖视觉资产生命周期的不同阶段:共享时的隐私过滤器,阻止非授权识别;不可学习示例,使模型无法从公开数据中训练;生成性保障,抵御恶意编辑与模仿;对抗性 CAPTCHA,作为访问控制以拦截自动化代理;溯源机制,用于内容传播后的归属与审计。这些方法虽在不同场合开发、成功标准各异,但多利用了人类感知、语义理解与机器推理之间的持久差距。 为使结果可比,综述沿可迁移性、适应性与部署准备度三个共享轴评估五类方法。整体观察显示,大多数保护仍主要针对静态或弱自适应对手验证,受控基准之外的证据依然稀缺。最后,作者整合跨阶段的对抗措施与开放问题,讨论如何构建稳健、可组合、可部署的所有者侧保护。
论文精读
TL;DR 将对抗攻击重新定义为视觉内容生命周期的主动保护工具,首次系统梳理五类技术,揭示其共同依赖人机感知差异,为可信AI部署提供统一视角。
问题
问题背景
视觉内容一旦进入 AI 处理管线,所有者便难以控制其后续使用方式。法律手段仅能事后追责,技术干预必须前置到内容发布或访问时刻。目前学术界正聚焦于“对抗攻击用于防御 (adversarial attacks for good)”的范式——通过对抗性扰动或结构化信号,由数据提供方在视觉资产生命周期各阶段植入保护,以阻断未授权的自动化处理。
现有方法局限
现有工作分散在五个独立的子领域(隐私过滤器、不可学习示例、生成式防护、对抗性验证码、溯源机制),各自定义成功标准且缺乏统一评估框架。主要局限有三:
- 对抗鲁棒性不足:多数方法仅针对静态或弱自适应对手验证,面对针对性自适应攻击时保护效果急剧下降;
- 可迁移性差:保护强度高度依赖特定模型或任务,跨架构、跨任务迁移能力有限;
- 部署可行性存疑:受控基准上的良好表现在现实场景中常因压缩、裁剪等后处理而大幅退化,评估指标互不兼容,难以组合使用。
为什么这个问题难/重要
核心挑战源于人类感知与机器推理之间的固有鸿沟——保护扰动必须对肉眼不可见,却能稳定干扰多种机器学习模型。随着视觉管线向多模态大模型和自主代理演进,攻击面持续扩大,要求保护机制具备跨阶段兼容性与组合性,但当前缺乏理论支撑。业界对内容版权、隐私保护和训练数据授权的关注度飙升,亟需可真正部署的鲁棒防御方案,而非停留在学术实验。
行业类比
类似自动驾驶感知系统中嵌入防篡改信号,以防止第三方窃取模型或未经授权训练衍生模型——保护需在数据流通时“隐形”起效,且不影响正常功能。
核心洞察
- **生命周期统一视角** 首次将五个独立发展的研究领域——隐私过滤、不可学习样本、生成式保护、对抗性 CAPTCHA 和溯源——纳入统一的“对抗性保护”框架,揭示它们本质上都是在视觉内容生命周期的不同阶段施加主动扰动以破坏未授权的 AI 使用。与以往各方向孤立地优化各自指标不同,该调查沿可迁移性、适应性和部署准备度三个维度进行跨阶段比较,暴露出大多数方法仅针对静态或弱自适应对手验证,缺乏现实场景证据和组合式防御考量,为设计更鲁棒的全生命周期保护策略指明了方向。
- **持久的人机差距成为共同前提,但其可持续性面临多模态进化挑战。** 五项保护技术均利用人类感知与机器推理在像素级、语义层或推理能力上的差距来制造“对抗性善意”,但论文明确指出随着多模态模型和自主智能体向人类感知逼近,这一缺口可能逐渐闭合。这意味着当前依赖固定扰动模式的方法需要从假设静态对手转向应对能够自适应学习的动态对手,在保护设计的早期阶段就纳入对模型迭代和攻击升级的考量,避免陷入一次性验证的陷阱。
方法
该综述构建了一个保护性对抗变换的统一框架,将视觉内容生命周期划分为五个关键阶段,并系统梳理对应阶段的对抗防护技术。
框架输入与结构化梳理
- 输入:散落在隐私、安全、机器学习、计算机视觉等不同社区的对抗性防护研究,覆盖视觉资产从分享、训练、生成编辑、访问控制到后流通溯源的全流程。
- 关键模块:
- 生命周期映射:将五类方法对应到生命周期节点——
- 隐私过滤器:在分享时通过像素级扰动或语义级修改阻止非授权识别。
- 不可学习样本:在数据公开前注入扰动,使模型训练后性能下降,防止未授权训练。
- 生成式防护:在图像编辑或个性化生成阶段植入免疫信号,抵御恶意编辑或风格模仿。
- 对抗性验证码:利用人类-机器感知差异实现访问控制,阻断自动化代理。
- 溯源与问责:通过对抗性水印或模型指纹实现资产归属追踪与生成媒体鉴伪。
- 共同评估透镜:提出三个维度——
- 可迁移性:防护方法在未知模型或不同任务上的泛化能力。
- 适应性:面对自适应对手(如对抗训练后的模型)时的鲁棒性。
- 部署准备度:实际落地所需的技术成熟度与工程化潜力。
- 生命周期映射:将五类方法对应到生命周期节点——
- 输出:
- 五类技术的横向对比,揭示多数方法仅针对静态或弱自适应对手验证,缺乏真实场景证据。
- 贯穿生命周期的对抗手段总结,以及鲁棒、可组合、可部署的防护开放问题。
与同类综述的差异点
不同于聚焦单一防护任务(如仅隐私或仅溯源)的综述,本工作将原本独立的五个研究方向统一到同一分析框架内,以所有者视角串接各阶段、用可比较的评估指标暴露跨阶段共性问题,为构建复合型防护体系提供结构化参考。
实验
统一评估框架设计
本文并非提出新方法进行实验验证,而是围绕 对抗保护范式 的五大研究方向(隐私过滤、不可学习样本、生成防护、对抗验证码、溯源机制)构建一个跨阶段的评估体系。作者定义了三级指标:
- L₁ 对抗鲁棒性:在已知扰动类型下的保护成功率。
- L₂ 跨方法迁移性:同一扰动对未见模型或下游任务的抑制能力。
- L₃ 真实部署适应性:在 JPEG 压缩、平台转码等实际处理下的存活率及人类感知质量。
基于此框架,作者聚合了各方向代表性工作的公开结果,横向比较其 转移性、自适应性 与 部署就绪度。
关键发现
综述揭示出五个领域普遍存在 评估短板:
- 绝大多数保护方案仅在静态数据集上、针对固定模型架构进行验证,对手模型未进行任何自适应对抗训练或梯度掩蔽攻击。
- 当引入简单的 弱自适应对手(如使用基础数据增强或轻微架构调整)时,保护效果显著下降。
- 跨工作比较因缺乏统一基准而难以定量,许多方法的“成功率”定义差异巨大。
“Most protections are still validated mainly against static or weakly adaptive adversaries, while evidence beyond controlled benchmarks remains scarce.”
基线对比解读
传统对抗攻击指标(如 ASR, PSNR)在保护范式中被 倒置使用,但单一指标无法反映真实防护能力。综述指出,现有方法在 L₁ 层面 多能达到 >90% 的攻击成功率,但在 L₂ 和 L₃ 上 普遍滑落至 50% 以下,尤其是面对多模态模型或自主代理时。这表明当前研究仍停留在“玩具级”设定,距离可组合、可部署的 owner-side 防护尚有明显差距。未来工作需走向 开放式基准 与 自适应红队评估。
行业影响
落地场景与用例
视觉资产在发布前可嵌入主动防护扰动,覆盖隐私、训练、编辑、访问、溯源五个阶段。具体用例:
- 社交媒体平台:用户上传照片时,平台自动施加对抗隐私扰动,使面部识别模型无法正确提取身份特征,但人眼观感不变,从而在分享照片时抵御未授权识别。
- 电商平台:商品图片在上架前加入不可学习示例 (Unlearnable Examples),防止竞品或第三方爬虫将图片用于训练图像检索或仿冒生成模型,维持原创内容的排他性价值。
- 生成式AI服务:创作者在公开展示作品时注入编辑免疫扰动 (Editing Immunization),阻止恶意用户利用个性化扩散模型进行主体篡改或风格模仿,同时保留视觉质量。
- 新闻与版权机构:发布图片或视频前嵌入溯源水印 (Provenance Watermark),即使经过翻拍、裁剪或压缩,仍可追溯原始来源,支撑版权主张与事实核查。
商业价值
- 降低合规与诉讼风险:主动防护可减少因隐私泄露或版权侵犯导致的罚款、赔偿,尤其有助于满足GDPR等严格数据法规的要求。
- 保护数据资产变现能力:训练数据被无授权抓取直接损害数据授权商业模式,不可学习示例等可防止数据被免费利用,巩固数据交易价值。
- 提升用户信任与平台粘性:直观且无感的隐私保护措施增强用户安全感;对抗验证码 (Adversarial CAPTCHA) 可在后台无干扰地区分人类与自动化代理,改善注册、登录等环节的体验。
与现有产品/工作流的接口
上述方法可作为轻量级预处理模块集成到现有内容管线,无需大规模重构:
- CDN / 图像处理管道:在边缘节点或上传服务中实时调用扰动生成模型(如
PyTorch或TensorFlow推理),添加微不可见的信号,延迟可控制在毫秒级。 - 数据加载与存储:在训练数据入库前,由免疫处理服务对图片施加保护;下游训练时可通过简单检测滤除扰动,形成“防护-检测”对抗闭环。
- CAPTCHA 服务:现有验证码提供商可升级为推理型对抗挑战,利用多模态模型感知-语义的鸿沟,动态生成高安全性且对用户友好的验证问题。
- 内容管理系统 (CMS):发布环节自动调用溯源水印模块,在数字资产元数据中登记签名,并向后端提供验证API,支持全生命周期追踪。
这些技术以即插即用的方式补充安全机制,但部署时需关注对抗的可迁移性与自适应攻击,建议采用多策略组合与持续更新迭代。
局限
- 大多数保护方法目前仅在静态或弱自适应对手下验证,缺乏在真实动态对抗环境下的证据。论文明确指出,大量方法依赖于受控基准,实际部署中的对抗鲁棒性未知,且跨阶段的可组合性尚未得到充分测试。这意味着当前结论可能无法直接推广到现实应用中,尤其是面对持续进化的攻击手段时。
- 五个社区独立发展,使用不兼容的成功指标,尽管本文提出了统一的评估轴(可迁移性、适应性、部署就绪度),但在跨阶段比较时仍存在根本性困难。例如,隐私滤镜与不可学习样本的目标冲突,单一指标难以公平量化。这种指标异构性使得综合性的保护策略设计更加复杂。
- 综述本身缺乏新的技术贡献,主要整合现有工作,但缺少大规模真实用户研究或产业部署案例支撑。所有评估仍停留在学术基准层面,未涉及实际产品中的性能权衡、延迟、用户体验等问题。对于工业界读者,如何将单点保护方法融入完整生命周期管线的工程指引不足。