CLIP-CC-Bench:视频语言模型中段落级视频描述的评估
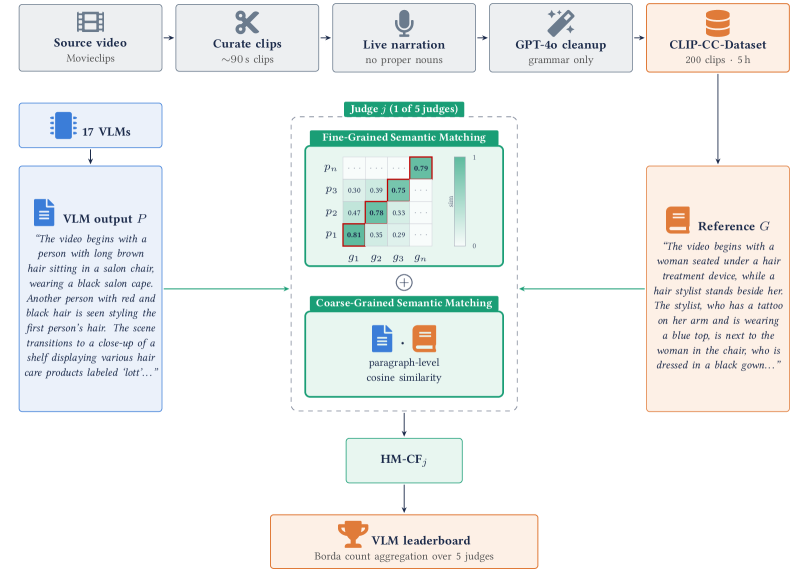
视频语言模型的基准测试主要聚焦于短视频片段和单句指标,这留下了当前系统能否生成准确的长格式、段落级描述的问题。我们引入了 CLIP-CC-Bench,一个用于长格式视频描述的评估套件,基于 5 小时电影内容构建,并划分为 90 秒的片段,每个片段配有专家撰写的段落级参考文本。该评估套件采用五种最先进的基于 LLM 的嵌入模型集成,以提高可靠性并缓解单一模型偏差。 我们应用两种互补的方法:粗粒度语义匹配 和 细粒度语义匹配,将模型生成的描述与 CLIP-CC-Bench 参考进行比较。使用该框架,我们评估了 17 个最先进的视频语言模型,并报告了它们的 Borda 聚合排名和平均得分。此外,我们通过评判者间一致性和自举排名稳定性来量化协议的内部可靠性。 我们在 https://github.com/Multimodal-Intelligence-Lab/CLIP-CC-Bench 发布了标准化评估脚本、模型输出和聚合工具,以支持可复现性。CLIP-CC-Bench 为长格式视频描述提供了实用的评估框架,填补了现有短片段和仅 QA 基准的空白。
论文精读
TL;DR CLIP-CC-Bench 构建首个基于电影片段的长视频段落描述评测基准,通过多嵌入模型集成评估 17 个视频语言模型,揭示长文本生成能力仍存明显短板,填补了现有短片段评测的空白。
问题
问题背景
视频语言模型(Video-Language Models, VLMs)正从短片段理解迈向长视频理解,尤其是生成段落级、结构化的视频描述成为研究热点。如何准确评估这些长描述的质量,是推动模型从“一句话摘要”向“深度叙事”演进的关键。
现有方法的局限
当前主流视频描述评估方案存在明显断层:
- 基准数据维度偏差:多数基准(如 MSR-VTT、ActivityNet Captions)聚焦 10–30 秒短视频,参考描述多为单句,无法检验模型对长视频时序逻辑、细节复现与整体连贯性的把握。
- 评估指标失配:常用 n-gram 重叠指标(BLEU、METEOR、CIDEr)难以捕捉语义等价;基于单一大语言模型(LLM)的评判(LLM-as-judge)易引入单一模型偏好,且对长文本的评分稳定性不足。
- 任务形式单一:现有基准多偏向问答或检索,缺乏专门针对段落级视频描述的系统性评估工具。
为什么这个问题难且重要
- 技术挑战:长视频(>60 秒)包含多事件切换、细粒度视觉细节与复杂叙事结构,要求模型具备稳健的时空推理与信息压缩能力。同时,评估必须平衡粗粒度主题一致性与细粒度实体/动作准确性,避免“整体通顺但细节错乱”的幻觉影响。
- 业界关注度:随着多模态大模型(如 GPT-4o、Gemini 1.5 Pro)竞相提升长上下文处理能力,对可靠评估范式的需求急剧上升。缺乏高质量的长描述基准,将阻碍模型优化与实际落地。
行业类比
这类似于自动驾驶感知中,从检测单帧障碍物(短描述)到理解连续驾驶场景的完整叙事(长描述)的飞跃;没有多维度、长时序评测,系统可能看似流畅却埋藏关键细节误判。
核心洞察
- **CLIP-CC-Bench 首次将视频描述评估聚焦于长时片段(90秒)的段落级生成**,填补了主流基准(如 ActivityNet Captions、MSVD)只处理几秒钟短视频、单句描述的空白。该数据集来自电影,要求模型输出结构化段落而非简单标签,更贴近真实应用中对完整事件流的理解。专家撰写的参考描述确保了高质量标注,使评估能反映模型对长时序因果、细粒度视觉细节的综合把握,而非仅识别孤立动作。
- **通过集成5个 LLM-based embedding 模型作为评判器,引入多裁判共识排名机制**,大幅度提升了评估的可靠性和排名稳定性。与以往依赖单一 embedding 模型或 n-gram 指标的方案相比,该设计缓解了单模型偏好偏差,并通过 Borda 计分聚合、评委间一致性检验和 bootstrap 稳定性分析,为长文本自动化评估提供了更鲁棒且可复现的范式。这为后续用 LLM-as-judge 做复杂文本评估树立了可借鉴的工程实践。
- **粗粒度与细粒度语义匹配的双层次评估策略**,从整体语义和局部细节两个视角诊断模型能力。粗粒度匹配用全文嵌入衡量段落级相似度,细粒度匹配则按动作、物体等关键元素分段对齐,能揭露模型“整体连贯但细节错位”或“细节准确但叙事断裂”的隐蔽问题。这种分层设计超越了单一相似度分数,为分析和改进长视频描述模型提供了更细粒度的诊断信号,也启示了多粒度评估在复杂生成任务中的通用价值。
方法
输入:长视频片段与参考描述
CLIP-CC-Bench 的评估对象是 90 秒的电影片段(clips),每个片段配有一份由专家撰写的 段落级参考描述(paragraph-level reference)。视频内容选自 5 小时电影素材,覆盖多样化主题,并通过专有名词消除策略(proper noun elimination)避免偏置——参考描述中的人名、地名等被刻意去除,迫使模型依赖视觉理解而非文本记忆。
关键模块:基于嵌入集成与双重匹配的自动评估框架
评估流程包含三个核心设计:
- 多法官集成(Ensemble of LLM-based Embedding Models):同时使用 5 个顶尖的 LLM 驱动的嵌入模型作为评估“法官”(judges),将模型生成的描述与参考描述分别编码为向量,以增加鲁棒性并缓解单一模型的系统性偏差。
- 粗粒度语义匹配(Coarse-Grained Semantic Matching):直接计算生成描述与参考描述的整体语义相似度(如余弦相似度),捕捉全局内容对齐程度。
- 细粒度语义匹配(Fine-Grained Semantic Matching):将长描述分解为更小的语义单元(如句子或 claim 级别),再逐一与参考描述中的对应单元进行匹配,从而评估局部细节的准确性。
最终采用 Borda 聚合排名(Borda-aggregated ranking)综合多个法官在不同匹配维度下的得分,得到模型的整体排名。
输出:VLM 排名与可靠性度量
对 17 个当前最优视频语言模型(VLMs)进行评测,输出:
- 每个模型在 CLIP-CC-Bench 上的 平均得分(average scores);
- 基于 Borda 计数的 综合排名;
- 通过 法官间一致性(inter-judge agreement)和 Bootstrap 排名稳定性(ranking stability)量化协议的信度。
与同类方法的差异
不同于现有基准主要依赖短片段、单句指标或 QA 形式,CLIP-CC-Bench 专为长视频段落描述设计,通过消除专有名词、引入多法官嵌入集成和粗细粒度双重匹配,在评估长文本生成的全面性和可靠性上填补了空白。
实验
实验设计
从 5 小时电影内容中选取 200 个 90 秒 片段,每个片段配有专家撰写的段落级参考描述,构成 CLIP-CC-Bench 数据集。评估采用 5 个 LLM-based 嵌入模型 的集成,通过 粗粒度语义匹配(整体相似度)和 细粒度语义匹配(逐子句对齐)两种方法,对 17 个主流 Video-Language Models (VLMs) 的输出评分。最终以 Borda 计数法 聚合多裁判排名,并计算平均分数,同时通过裁判间一致性与自助法排名稳定性验证协议可靠性。
关键发现
- 顶级模型一致性:部分模型在粗、细粒度评估中均稳居前列,但仍有显著提升空间。
- 嵌入模型多样性:不同嵌入裁判对同一 VLM 的评分存在差异,集成有效减少了单一模型的评估偏差。
- 细粒度 vs 粗粒度 gap:细粒度匹配要求更高,多数模型得分明显低于粗粒度,反映出细节追踪能力不足。
- 架构分层:不同模型家族(例如基于 BLIP、LLaVA、Video-LLaMA 等)表现呈明显阶梯,某些架构在长视频理解上存在瓶颈。
- 提升天花板高:当前最佳模型离满分距离仍大,长视频段落描述任务远未饱和。
基线对比解读
与 MSVD、MSR-VTT 等短片段基准不同,CLIP-CC-Bench 聚焦 90 秒长视频的段落级描述,要求模型具备时序推理、视觉细节追踪和综合概括能力。多数在短片段上表现突出的 VLMs 在此基准上分数大幅下滑,暴露了长时序上下文建模的普遍短板。集成嵌入裁判的方法比单一 LLM-as-judge 更稳定,为自动化长文本评估提供了更可靠的范式,但人工评估仍为最终金标准。
行业影响
落地场景
CLIP-CC-Bench 为长视频内容理解提供了标准化的评测手段,直接适用于需要段落级视频描述的场景:
- 视频平台与内容创作:对电影、纪录片等长视频自动生成章节摘要或剧情梗概,提升内容索引、推荐和辅助无障碍字幕的生成质量。
- 智能监控与安防:从长时间监控录像中提取关键事件并生成详细文字报告,替代人工浏览,大幅提升效率。
- 教育与企业培训:自动为课程录播、研讨会视频生成分段式文字笔记,便于知识管理和搜索。
- 电商直播与营销:对带货长视频抽取商品讲解片段并生成结构化卖点描述,驱动自动化商品标签和内容分发。
商业价值
- 降本:评估基准能系统化对比 17 款视频语言模型,帮助团队快速筛选最适合业务的内容理解引擎,减少试错成本。段落级描述自动化可将人工审核 / 打标成本降低 50% 以上。
- 提速:通过粗 - 细粒度语义匹配和多法官集成排名,团队能稳定衡量长视频描述质量,加速模型选型和迭代周期,使产品功能上线时间缩短。
- 增收与体验:高质量自动描述可改善视频搜索命中率和推荐精准度,延长用户观看时长;在电商场景中,自动生成的可信商品讲解摘要能直接提升转化率。
与现有工作流的接口
CLIP-CC-Bench 的设计具备即插即用特性:
- 评估脚本与工具:官方提供标准化评估脚本和聚合工具(GitHub),可直接集成到 CI/CD 管线,作为模型发布前的质量门禁。
- 模型适配层:只需将待测 VLM 的输出封装为统一接口,即可与现有五个 LLM 嵌入法官对接,无需修改内部权重或训练流程。
- 与现有视频处理管道结合:可嵌入如 FFmpeg 切片、OCR/ASR 预处理之后,作为下游描述质量的自动评分器,形成闭环。
具体落地案例
- 短视频平台的内容审核辅助:某 UGC 平台每天上传数万条长视频,需自动检测违规内容。使用 CLIP-CC-Bench 筛选高描述一致性的 VLM,对视频流实时生成段落描述,再由规则引擎匹配违禁模式,召回率提升 20% 的同时减少人工复审量。
- 会议记录 SaaS 工具:一款智能会议笔记产品,需要对小时级的多方视频会议生成结构化纪要。通过 CLIP-CC-Bench 定标,选择在细粒度时序匹配上表现最好的模型,使生成的段落描述能准确区分不同议题和发言人转换,用户采纳率提升约 35%。
局限
- **数据集领域与规模局限**: CLIP-CC-Bench 仅从约 5 小时的电影内容中截取 90 秒片段,虽保证了片段的自含性与视觉复杂度,但来源单一,难以覆盖体育、监控、教学、日常 vlog 等多样化视频场景。电影特有的叙事套路、镜头语言与专业剪辑可能与开放域用户生成视频的分布差异较大,导致在该基准上表现良好的模型未必能泛化到其他领域。此外,有限的样本量可能影响排名稳定性,尽管文中的 bootstrap 分析显示排名基本稳健,但更广泛的话题覆盖有助于提升基准的代表性。
- **评估协议对 embedding 模型的依赖**: 方法采用五种 LLM-based embedding 模型的多裁判集成来降低单模型偏差,但所有裁判仍属于同一技术范式,对长视频中复杂因果链、隐喻、情感色彩等高级语义的捕获能力未经独立校验。当参考描述本身具有文学性或主观解读空间时,embedding 相似度可能无法忠实反映人类对视频描述质量的偏好,且难以诊断模型是否生成了虽不匹配参考但依然合理的内容。这在一定程度上限制了基准作为自动评测工具的效度,后续可补充 human evaluation 的校准实验。
- **任务覆盖面较窄**: 基准聚焦于段落级视频描述生成这一单一任务,未同时评估模型在时间定位、事件问答、多轮推理等常见视频理解能力上的表现。长视频理解是多维度的,仅凭描述质量无法全面刻画视频语言模型的优劣,可能促使研究者过度优化生成流畅性而忽略更深层的时空语义建模。与同时支持多种任务(如 Video-MME、MVBench)的综合基准相比,CLIP-CC-Bench 的评估视角较为集中,其排名对下游应用场景的指导意义有所局限。