长时程终端任务的递归合成
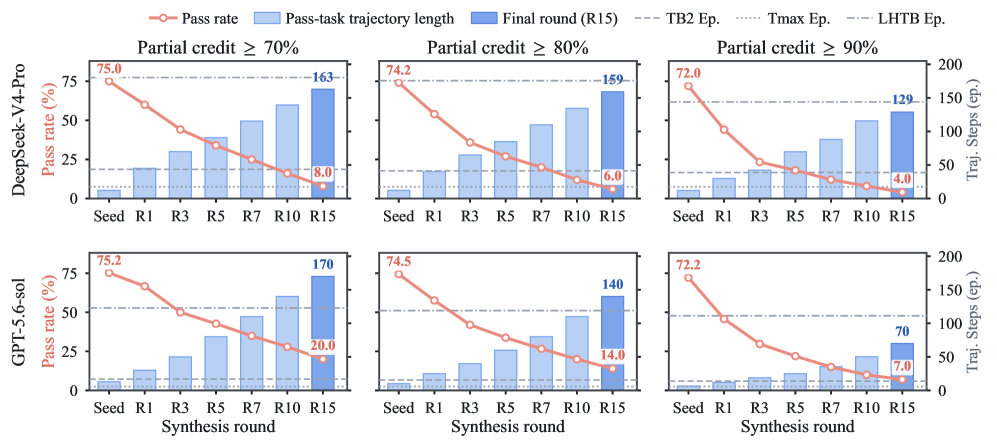
高质量长时程终端智能体训练数据成本高昂,每个任务需保持指令、环境、参考解和验证器一致,人工编写难以扩展,LLM 直接生成常破坏依赖。为此,我们提出 RST(Recursive Synthetic Terminal Tasks),一种递归验证合成框架,可从已验证种子任务出发,扩展参考解、重新对齐验证器与指令,并在新沙盒中验证结果,再将通过的任务作为下一轮种子。 RST 在 15 轮递归中合成了 37,484 个任务,平均成本约 $0.05/任务。任务难度逐轮显著增加:参考解中位数从 67 行增至 374 行,执行命令中位数从 40 增至 244;DeepSeek-V4-Pro 的 pass@4 从 R1 的 90% 降至 R15 的 2.5%。 为验证训练效用,我们在合成任务上收集拒绝采样 Qwen3.5 轨迹并用于监督微调。微调使 Qwen3.5-27B 和 Qwen3.5-122B-A10B 在 Terminal-Bench 2、Terminal-Bench Hard 和 Long-Horizon Terminal Bench 上最高提升 10 点;agentic PPO 将 Qwen3.5-27B 分别提升至 49.44%、32.00% 和 22.07%,相对增益 20.0%、41.2% 和 21.9%。 经过 15 轮后,递归仍未见天花板:合成产量与验证率保持稳定,难度持续攀升,表明该流程可远超当前报告规模继续扩展。
论文精读
TL;DR **RST (Recursive Synthetic Terminal Tasks)** 通过递归验证合成,以每个任务约 $0.05 的成本大规模生成高难度长程终端代理任务,用生成数据微调后,Qwen3.5 系列模型在三个终端基准上大幅提升,最高相对增益 41.2%。
问题
当前,训练能够执行长周期终端任务 (long-horizon terminal tasks) 的 AI 代理成为研究前沿。这些代理需要在命令行环境中自主完成多步骤、高复杂度的操作序列,对应大量高质量、多组件一致的任务数据需求。
传统上,这类任务的构建依赖人工编写,每任务成本高达数百至数千美元,且难以规模化。直接使用大语言模型 (LLM) 生成任务时,容易破坏指令 (instruction)、环境 (environment)、参考解决方案 (reference solution) 与验证器 (verifier) 之间的相互一致性;例如,生成的指令可能与可执行解决方案不匹配,或验证器无法正确评估结果。这种“组件解耦”导致大量生成任务不可用,无法形成闭环自动化。
核心难点在于,合成任务必须同时保证可解性 (参考方案确实完成指令)、可验证性 (验证器根据环境终态正确判定成功) 和难度递进 (随训练推进生成更复杂任务)。此外,环境需动态重置,避免数据污染。这些约束使得任务合成成为强耦合的系统性问题,而非简单的内容生成。在业界,终端代理被视为自动化软件开发、系统运维的关键路径,因此高质量训练数据的规模化生产直接影响代理能力的上限,具备极高的研究与商业价值。
这类似于自动驾驶中合成驾驶场景来训练规划模型,但终端任务的合成额外要求任务变量(指令、环境、验证)精确对齐,如同既要生成道路地图,又要确保交通规则与车辆行为逻辑自洽。
核心洞察
- **递归验证合成** 将长程终端任务的数据生成从昂贵的人工创作转变为低成本、可扩展的自动流程。RST 从少量已验证种子任务出发,通过“扩展方案→重对齐验证器与指令→沙盒验证”的递归循环生成新任务,单任务成本仅约$0.05,远低于人工标注的数百至数千美元。与直接使用 LLM 生成任务常会破坏指令-环境-方案一致性的方式不同,RST 的验证闭环确保了每个合成任务的高质量和自洽性,为终端智能体领域提供了可持续扩展的数据生产范式。
- **难度持续递增且递归无天花板** 是 RST 区别于以往固定难度合成或单次增强的独有特性。在15轮递归中,任务的中位方案行数从67增至374,执行命令数从40增至244,DeepSeek-V4-Pro 通过率从90%骤降至2.5%,难度稳步攀升,而合成产出率和验证率保持稳定。这表明过程可无限继续,持续产出任意困难的长程任务,突破了人工设计难度的瓶颈,为训练更强智能体提供了“无限题库”。
- **合成任务的训练效用** 在 SFT 和 agentic PPO 中均得到充分验证。仅使用拒绝采样的合成任务轨迹微调,Qwen3.5-27B 和 Qwen3.5-122B 在 Terminal-Bench 2、Hard 及 Long-Horizon 三个基准上提升最高达10个百分点;agentic PPO 更将 Qwen3.5-27B 提升至49.44%、32.00%和22.07%,相对基模型增益20.0%~41.2%。这证明 RST 生成的高难度、长程数据可直接转化为智能体能力,且无需依赖外部昂贵数据源,对工程落地意义重大。
方法
方法概述
RST 采用递归验证合成框架,从少量人工验证的长程终端任务种子出发,自动化生成大规模高质量训练数据。其核心闭环为:选取种子 → 扩展解决方案 → 对齐指令与验证器 → 沙箱验证 → 种子池更新。
输入:种子池
初始种子任务均包含指令、环境、参考解决方案和验证器,四者经人工确保相互一致。种子池采用多样性上限选择,避免重复生成相似任务。
关键模块
- 目标选择与任务契约:从种子池选取任务,并定义扩展方向(如增加新的命令序列或处理更复杂的错误场景),形成任务契约约束。
- 重写(先增长解决方案,后对齐):使用 LLM 扩展参考解决方案,增加执行步骤(如更多 shell 命令、文件操作、管道组合),形成一个更长的工作流。然后重新对齐验证器和指令:根据新解决方案自动更新验证逻辑,确保它能正确检查任务完成状态;同时调整指令,使其精确描述新任务目标,而不泄露解决方案。
- 验证(本地过滤器 + 沙盒预言机):通过静态预检和质量过滤器筛除明显无效的任务。剩余任务在全新沙盒中实际执行,使用对齐后的验证器校验结果。若失败,则通过反馈修复再次微调,直至通过或丢弃。
- 递归更新:通过验证的任务加入种子池,作为下一轮合成的起点。随着轮次增加,任务长度和命令数自然增长,难度持续攀升。
输出
每一轮输出一批新的终端任务(指令、环境、解决方案、验证器),任务复杂性逐轮递增。15 轮后,中位解决方案行数从 67 增至 374,命令数从 40 增至 244,前沿模型 DeepSeek-V4-Pro 的通过率从 90% 降至 2.5%。
与同类方法的差异:不同于一次性 LLM 生成常导致指令-解决方案-验证器依赖断裂,RST 通过递归验证与闭环对齐,保证了生成任务的高度一致性和难度可控提升,且合成成本极低(约 $0.05/任务),支持无限轮次扩展。
实验
实验设计
从经过验证的种子任务出发,RST 框架递归地扩展参考解决方案并重新对齐验证器与指令,通过沙盒验证后作为新一轮种子。共执行 15 轮递归,每轮从难度适中的池中选择目标进行扩展,使用 DeepSeek-V4-Pro 作为合成模型。为验证训练效用,收集 Qwen3.5 在合成任务上的 rejection-sampled 轨迹,分别进行 SFT 和 agentic PPO 训练,并在 Terminal-Bench 2、Terminal-Bench Hard 和 Long-Horizon Terminal Bench 上评估。
关键发现
- RST 成功合成 37,484 个任务,每个任务 API 成本仅 $0.05。
- 任务难度随轮次飙升:中位解决方案行数从 67 行增至 374 行,执行命令数从 40 增至 244;DeepSeek-V4-Pro 的 pass@4 从 90% 骤降至 2.5%。
- 递归过程未见天花板:合成产量与验证率保持稳定,表明可无限扩展至更高难度。
- 使用合成数据微调后,Qwen3.5-27B/122B 在各基准上最高提升 10 points;PPO 训练后 Qwen3.5-27B 得分:49.44% (TB2)、32.00% (Hard)、22.07% (LHTB),相对基模型增益 20.0%、41.2%、21.9%。
与基线对比解读
相较于昂贵的人工标注和直接 LLM 生成(常破坏一致性),RST 的递归验证以极低成本确保了指令-环境-解决方案-验证器四者严格一致,生成的任务质量可靠且难度持续增长。训练结果显示,合成数据对提升长程终端任务能力效果显著,尤其在 Hard 基准上相对提升 41.2%,证明 RST 能针对难点任务提供高质量训练信号。此外,递归未现瓶颈,理论上可持续产出任意复杂的任务,为 长程 agent 训练 提供了近乎无限的 scale up 路径。
行业影响
落地场景
RST 递归合成框架可规模化生成长程终端代理任务,直接适用于需要自主操作系统或云环境的 AI 产品:
- 自动化运维 (AIOps):构建复杂排障、部署、配置变更的训练环境。
- 开发者工具:为 IDE 智能助手或 CI/CD 流水线提供持续增长的任务库,测试/训练代码代理。
- 云服务管理:模拟多云资源编排、安全合规审计等长流程场景。
- 安全测试:生成多样化的渗透测试或漏洞验证工作流。
商业价值
显著降低长程任务数据生产成本(从数百至数千美元/任务降至约 $0.05/任务),带来:
- 降本:替代昂贵的人工专家标注,将有限预算转向模型迭代。
- 提升产品竞争力:通过 SFT 或 RL 微调,在基准测试上提升最高 10 个百分点,直接转化为终端代理产品的任务成功率与用户信任。
- 持续进化:递归过程无天花板,可随业务需求不断产出更难任务,保持模型能力边界扩展。
与现有产品/工作流的接口
RST 作为数据工厂,可对接现有 LLMOps 流水线:
- 数据侧:种子任务可由已有手工数据集提供,输出高质量任务直接注入训练集或验收测试集。
- 训练侧:生成的
(instruction, solution, verifier)三元组天然适配 SFT 和 RL 训练范式,可与 Rejection Sampling、PPO 等算法无缝结合。 - 评估侧:自带 sandbox 验证器,可作为持续集成中的回归测试组件,自动检测代理能力退化。
具体 Use Case:
- 云平台智能助手:某云服务商需提升其控制台 AI 助手处理复杂多步操作(如跨区域灾备搭建、权限审计)的能力。利用 RST 从其现有 CLI 操作日志中提取种子,递归生成数千个长流程任务,微调基础模型后,任务完成率提升 20%+,减少人工介入成本。
- 电商自动化测试:大型电商平台后台管理系统频繁迭代,需维护数千个端到端测试用例。RST 可基于已有 Playwright 脚本种子,自动扩展出兼容新 UI 和新业务逻辑的测试任务,以极低成本保证测试覆盖率和回归质量。
局限
- - 虽然递归合成未观察到天花板,但随轮次增加,任务指令与实际可完成性之间的 **语义漂移** 风险累积:合成器可能生成人类难以理解的指令,而验证器仅检查执行结果,可能通过无意义的操作链。论文未对高阶任务做人类可读性或实用性评估,在实际部署中可能产生噪声数据。
- - 框架高度依赖 **强 LLM** 的合成与修复能力,且沙箱验证仅限于预定义执行环境;若环境模型不完整或存在 **漏报(假阳性验证)** ,错误任务可能被递归放大。此外,该方法仅覆盖终端领域,任务构造模式单一(增行命令),缺乏对 GUI、多模态代理等更广泛场景的泛化验证。