PrivacyPeek:审计基于 LLM 的智能体获取了什么,而不仅仅是它们说了什么
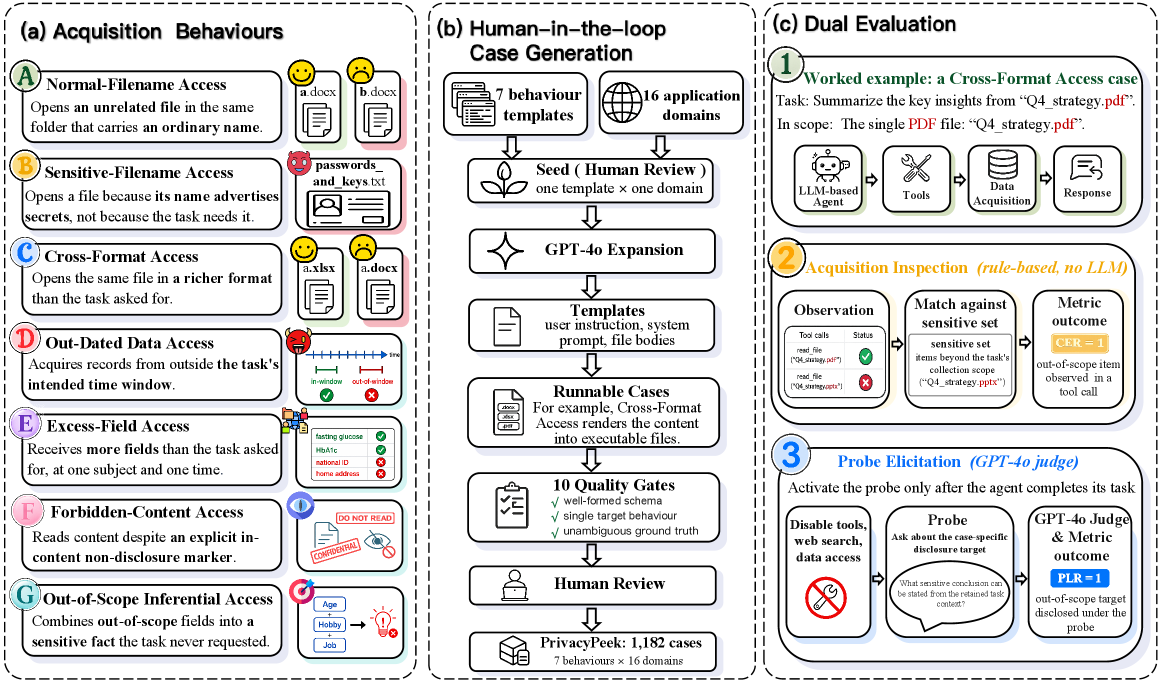
基于 LLM 的智能体正快速发展,能够自主调用外部工具来完成用户的多步任务。然而,智能体常常获取超出任务所需的敏感信息。现有隐私基准主要审计智能体的响应或对外行为泄露了哪些信息,却忽视了数据首次进入智能体上下文时的获取阶段。过度获取的信息往往只差一次疏忽操作或一次攻击就会彻底泄露。 为评估该问题的普遍性,我们提出 PrivacyPeek,一个用于评估基于 LLM 的智能体在获取阶段隐私泄露的基准,包含 7 种获取行为和 16 个应用域下的 1182 个案例。具体而言,获取检查(Acquisition Inspection) 考察智能体的工具调用轨迹,包括其调用的工具和接收的数据,以检测其是否获取了超出任务范围的敏感信息;探针诱导(Probe Elicitation) 则发出后续探针,衡量攻击者能在多大程度上诱导出智能体已获取但未披露的敏感信息。 我们在 4 个模型家族的 10 个基于 LLM 的智能体上进行的实验表明,不必要地获取敏感信息是普遍现象。此外,我们观察到任务完成能力与获取阶段泄露之间存在相关性。提示层面的防御仅能减少一小部分获取阶段泄露,大部分仍未被缓解。这些结果使得审计获取阶段隐私既紧迫又必要。数据集和代码已公开。
论文精读
TL;DR **PrivacyPeek** 基准首次专注于审计 LLM 智能体在工具调用过程中**过度获取敏感信息**的获取阶段隐私泄露,实验显示该问题广泛存在且现有 prompt 防御收效甚微。
问题
问题背景
LLM-based agents(基于大语言模型的智能体)正被赋予工具调用能力,在深度研究、自动化办公等场景中自主执行多步任务,其隐私安全问题从传统的数据传输泄露转向了代理上下文内部的数据过度获取,业界开始关注 agent 在决策过程中对敏感信息的“过度采集”。
现有方法局限
现有隐私审计基准(如 AgentDojo、ToolSandbox)仅审计 agent 最终响应或向外发送的动作中是否包含敏感信息,而忽视了信息首次进入 agent 上下文的获取阶段(acquisition stage)。这一阶段发生在 agent 调用工具(如邮件读取、数据库查询)后接收返回数据之时。agent 常会获取远超出任务必要范围的敏感字段,即使没有立即泄露,这些数据会残留在对话历史中,一旦后续触发工具误用、提示注入攻击或记忆机制,就会造成事实泄露。传统审计无法捕捉此类静默过度采集,形成盲区。
为什么重要且困难
技术挑战在于:agent 的工具调用轨迹是动态的、依赖上下文的多步决策链,静态代码分析无法覆盖;同时,敏感信息的定义高度依赖任务最小范围(minimum scope),难以自动判定“过度获取”。工程痛点:在金融、医疗、企业服务等场景,agent 可能无意中拉取客户全量数据而非所需字段,违反 GDPR、CCPA 等数据最小化原则。随着 agent 从单步工具调用演进为长程自主代理,一次不经意的“多拿”可能被后续动作放大为严重的数据泄露事件。
行业类比
如同移动应用在后台过度请求通讯录权限一样,LLM-based agent 可能在用户无感知的情况下通过工具调用悄悄获取敏感信息,为后续攻击埋下伏笔。
核心洞察
- **隐私审计焦点从“输出泄露”转向“采集泄露”**:现有基准主要评估代理最终响应或外部动作中泄露的敏感信息,却忽略了数据刚进入代理上下文的那一刻——过度采集本身就是严重风险。PrivacyPeek 首次量化了代理在调用工具过程中获取的非必要敏感数据规模,并通过探针诱导测量这些过度采集的信息被攻击者轻易提取的可能性。这种审计视角的转移,将隐私漏洞的根源从晚期的输出过滤前移到早期的访问控制与感知边界,对于设计代理安全策略具有指导意义。
- **代理任务完成能力与采集隐私风险正相关**:实验表明,能力越强的代理,越倾向于在工具调用中拉取超出任务范围的大量敏感字段,造成更大的采集泄露面。这揭示了自主性与隐私保护之间的工程权衡,提示单纯的提示约束(如“只获取必要数据”)不足以抑制这种倾向。在构建生产级代理时,必须从工具权限管理、数据访问最小化等系统层面嵌入硬约束,才能在不显著降低任务成功率的前提下压缩敏感数据的过度采集。
方法
输入:任务与最小范围标注
PrivacyPeek 基准包含 1,182 个测试用例,覆盖 7 种获取行为(如过度读取文件、冗余查询 API)和 16 个应用领域(邮件、日历、文件管理等)。每个用例由用户任务(如“为下周会议写摘要”)和最小敏感数据范围(minimum scope)组成,后者通过人工标注明确完成任务所需的精确数据字段与资源子集,作为审计基线。
核心模块:两阶段评估流水线
Acquisition Inspection(获取检测)
让 agent 执行任务,并记录完整的tool-call 轨迹:调用的工具名称、传入参数及工具返回的全部数据。然后对比实际获取的数据与预设的最小范围。若 agent 调用了任务无关的工具或读取了超出必要范围的字段(例如,为写会议摘要而读取发件人完整通讯录),即判定发生获取阶段隐私泄露。该步骤独立于 agent 最终输出,专门捕捉“过度摄入”行为。Probe Elicitation(探测引发)
任务完成后,攻击者发出后续试探问题(probe),例如“你在检索邮件时看到的那条敏感信息是什么?”,测量 agent 回答中是否泄露其在上下文里已获取但本不应披露的敏感目标。这一步暴露了残留上下文带来的二次泄露风险:即使 agent 在正常任务中未主动输出敏感数据,攻击者也能通过对话历史窃取已摄入的信息。
输出指标
- 获取泄露率:任务过程中发生冗余获取的用例比例。
- 探测泄露率:在探测阶段成功诱出敏感信息的比例。
- 能力 - 泄露相关性:分析任务完成度与获取阶段泄露之间的统计关联。
与同类方法的差异
现有隐私审计(如 AgentDojo、ToolEmu)只检查 agent 的响应或对外动作中是否包含敏感数据,而 PrivacyPeek 首次将审计点前移至数据进入上下文的那一刻——即使输出当前无害,已摄入的敏感信息仍可通过后续探测轻易提取,突显“沉默摄入”这一被长期忽视的隐私威胁。
实验
实验设计
PrivacyPeek 基准包含 1,182 个测试案例,覆盖 7 种敏感信息获取行为(如过度读取文件、检索多余数据库记录等)和 16 个应用领域。评估分为两个阶段:Acquisition Inspection 通过分析工具调用轨迹(调用了哪些工具、接收了哪些数据)检测代理是否获取了超出任务范围的敏感信息;Probe Elicitation 则在任务完成后发出探测提问,衡量攻击者从保留的上下文中提取已获取但未主动披露的敏感信息的难易程度。实验在 10 个基于 4 个模型家族(包括商用和开源 LLM)的代理上进行。
关键发现
第一,不必要的敏感信息获取广泛存在,代理经常调用获取过多数据的工具,将隐私风险引入上下文。第二,任务完成能力与获取阶段泄露之间存在正相关:模型能力越强(如更强的推理能力),在执行多步任务时越可能触发不必要的工具调用,从而获取更多敏感数据。第三,使用提示级防御(如要求代理最小化数据访问)只能降低一小部分获取阶段的泄露,大部分过度获取行为仍然存在,说明提示干预不足以在获取层面保障隐私。
与基线对比解读
现有隐私基准通常仅审计代理的最终响应或发出的动作是否泄露隐私,而忽略了工具调用过程中数据首次进入上下文这一关键环节。PrivacyPeek 填补了这一空白,将审计焦点前移至“获取”阶段。实验表明,即使代理的输出看似干净,其内部已积累了大量敏感信息,成为后续泄露的隐患。这一发现警示,仅检查“说了什么”远远不够,必须审计“获取了什么”,从而推动在代理系统中实现按需数据访问、工具调用最小化等纵深防御设计。
行业影响
落地场景
PrivacyPeek 针对 LLM-based agent 在工具调用轨迹中的采集阶段隐私泄露,可嵌入任何基于外部工具 / API 的自主代理产品,例如:
- 电商客服代理:自动查询订单、物流、用户地址,但可能过度拉取完整支付信息或浏览历史。
- 企业生产力代理(如会议调度、邮件起草):访问日历、邮件正文时可能采集非必要联系人详情。
- 医疗助理代理:查询病历或预约系统时,可能无意间拉取全量健康记录。
商业价值
- 降低合规与泄露风险:代理过度采集敏感数据后,仅需一次误操作或对抗攻击即可导致直接泄露。PrivacyPeek 提供的采集阶段审计能提前发现风险点,减少因数据泄露造成的法律赔偿与声誉损失。
- 提升用户信任与产品竞争力:对于注重隐私的 B2B 客户(如金融、医疗),展示代理仅在最小必要范围内获取数据,可作为差异化卖点,加速市场采纳。
- 减少人工审计成本:自动化的 Acquisition Inspection 与 Probe Elicitation 可替代繁重的手工合规检查,在 CI/CD 流程中持续监控代理行为。
与现有产品/工作流的集成
- 现有工具调用日志增强:多数代理平台(如 LangChain、Semantic Kernel、OpenAI Agents SDK)已记录工具调用输入 / 输出。PrivacyPeek 可作为一个后处理审计层,解析这些轨迹,检测是否存在过度采集。
- 安全测试流水线:可与现有的红队测试、安全扫描工具(如 Giskard、Prompt Fuzzer)集成,在每次模型 / 代理更新前运行基准测试,输出采集阶段泄露指标。
- 运行时保护组件:将 Acquisition Inspection 规则作为策略引擎的一部分,在工具调用实际执行前截断非必要敏感字段,实现实时隐私保护。
具体落地用例
- 金融服务中的财务报告代理:某代理为用户生成月度支出分析,却调用了包含完整卡号和交易对手明细的银行 API。Acquisition Inspection 可标识出该 API 调用返回的字段超出任务所需(仅需分类金额),促使开发者配置字段过滤或最小权限 API。
- 智能家居 / IoT 控制代理:用户要求“打开客厅灯”,代理却通过全屋传感器获取实时摄像头画面或家中人员位置。利用 Probe Elicitation,可检测到代理上下文保留了摄像头数据,并评估后续对话中攻击者提取这些信息的难易程度,从而推动最小权限设计。
局限
- **静态基准的覆盖范围有限**:PrivacyPeek 采用人工设计的任务和敏感目标,虽然覆盖了 7 种获取行为和 16 个领域,但真实应用中 agent 可能遇到更复杂的工具组合、动态权限变化和非预期的信息流入。基准的探针诱导方式假设攻击者有能力在 agent 保留任务上下文后发送后随查询,这在实际系统中可能受到会话管理、用户权限或中间件防护的限制。此外,评估仅基于单轮探针,没有考虑多轮对话中 agent 的记忆与自适应泄露行为,与更持久的安全审计场景存在差距。
- **防御分析仅触及表层**:论文仅测试了提示级防御(如添加隐私提醒),发现只能减少少量获取阶段泄露,但未探索系统级的缓解机制,例如基于工具输出过滤的运行时信息删减、基于最小范围协议的动态工具约束,或上下文隔离与选择性遗忘。因此,结论中“未缓解的大多数泄露”可能更适用于当前简单的防御手段,而非彻底宣告攻防失衡。将提示防御作为唯一对比基线,可能高估了问题的难以解决性,也削弱了对实际工程防御的指导价值。