World Modeling 何去何从?
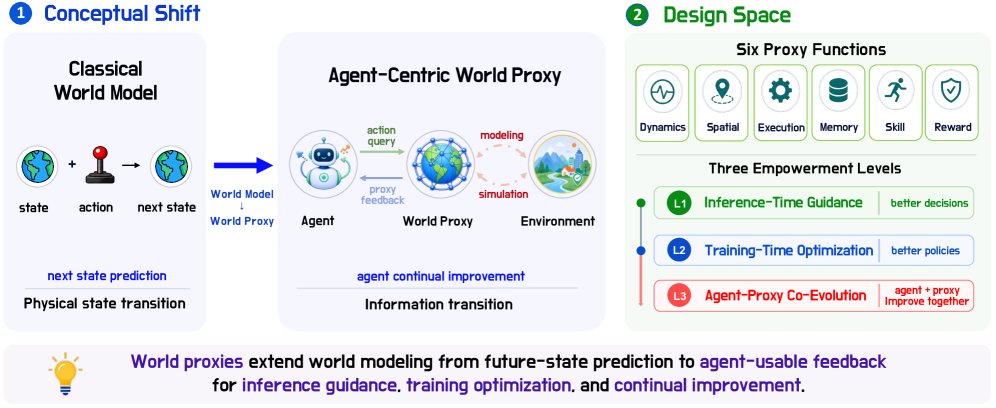
持续改进的智能体需要动态交互反馈,但直接真实环境交互成本高、速度慢、不安全且难以并行。世界模型提供了低成本的中间代理,但经典世界模型仅预测未来物理状态,对于需要可操作反馈的智能体而言过于狭窄。 本文提出 Agent-Centric Interactive World Proxies(以智能体为中心的交互式世界代理),将范式从物理状态转移转向智能体可用信息转移,如执行结果、检索经验/技能、验证信号等。根据反馈模态,将世界代理分为六种功能形式:dynamics(动态)、spatial(空间)、execution(执行)、memory/experience(记忆/经验)、skill(技能)、reward/verification(奖励/验证)代理。 进一步分析这些代理在三个渐进层次上赋能智能体:L.1 Inference-Time Guidance(推理时引导)、L.2 Training-Time Optimization(训练时优化)、L.3 Agent-Proxy Co-Evolution(智能体-代理共同进化)。最终,该工作将世界建模重塑为以智能体为中心的范式,为构建世界代理提供路线图,助力智能体更好规划、更快学习、持续进化。
论文精读
TL;DR 将世界建模重新定义为以智能体为中心的交互式世界代理,从物理状态预测转向智能体可操作的信息转换,提供六类反馈功能与三级赋能路径,实现推理、训练与协同进化。
问题
问题背景
当前,自主代理在持续改进过程中越来越依赖与环境的动态交互反馈,以弥补静态监督信号的不足。然而,直接与真实环境交互成本高、速度慢、存在安全风险且难以大规模并行化,这迫使研究者寻求更高效的反馈机制。
现有方法局限
传统的 World Model 主要扮演物理状态转移预测器的角色:给定当前状态与动作,输出下一时刻的状态或观测。这种范式存在两个核心局限:
- 反馈模态单一:仅提供原始物理状态(如像素、关节角),但代理决策常需要更抽象的、可直接用于策略改进的信息,例如动作的执行结果(成功/失败)、可复用的技能片段或外部验证信号。
- 代理视角缺失:经典世界模型不区分“环境如何演变”与“代理需要知道什么”,导致代理必须在每次决策时自行从状态转移中推导任务相关信号,降低了学习效率和推理速度。
为什么这个问题难/重要
难点在于需要从根本上重新定义世界模型的功能边界:从“模拟物理规律”拓展到“为代理生成可用的信息转移”。这涉及多个技术挑战:
- 如何结构化地组织不同模态的代理反馈(动态、空间、执行、记忆、技能、验证);
- 如何让世界代理在不同阶段(推理时引导、训练时优化、协同进化)为代理提供恰如其分的支持;
- 如何保证代理世界代理本身的可更新性,使其随代理能力增长而持续进化。
业界正积极构建通用代理系统(如具身智能、自动驾驶、机器人操作),对能够加速学习、提高决策安全性的世界建模方案需求迫切。这项工作将世界建模从“环境模拟器”升级为“代理可交互的智能代理”,为下一代持续学习代理提供了理论框架。
行业类比
类似自动驾驶系统中,除了预测车辆运动,代理还需理解交通参与者的意图、校验行为是否符合交通规则,并从历史驾驶经验中提取安全策略——这正是对多模态世界代理功能的直观需求。
核心洞察
- **范式转变:从物理状态转移到智能体可用的信息转移**。本文跳出传统世界模型仅预测未来观测或状态的局限,提出“以智能体为中心的交互式世界代理”,其输出从原始感官信号拓展为执行结果、检索经验、技能序列、验证信号等“智能体可用信息”。这种视角上的拓宽使得世界模型不再只是模拟器,而是能为决策、学习和持续改进提供多模态、可操作反馈的代理层,直接弥合了预测与行动之间的鸿沟,为构建更高效的 AI 系统提供了新方向。
- **系统化的设计空间与三层赋能框架**。论文将世界代理按功能归纳为六类(动力学、空间、执行、记忆/经验、技能、奖励/验证),并映射到三个递进的赋能层级:推理时引导、训练时优化、代理-代理协同进化。这一分类不是简单的罗列,而是揭示了不同反馈模态在智能体生命周期中的具体作用机制和工程落点,为后续研究者和工程团队选择或组合世界代理提供了清晰的路线图,避免了以往世界模型研究碎片化的问题。
- **代理-代理协同进化:从静态先验到持续共演**。文章提出的 L3 层级强调真实环境证据能同时更新世界代理和智能体策略,形成闭环的互促进化。与多数工作将世界模型视为固定预训练部件不同,该视角允许代理在部署中不断自我校正和成长,解决了离线模型分布偏移和老化问题,为构建可终身学习的具身智能、机器人控制等系统提供了理论基础和工程范式。
方法
方法核心:从世界模型到代理中心式世界代理
论文重新定义了世界建模的范式,提出代理中心式交互世界代理(Agent-Centric Interactive World Proxies),旨在为持续提升的智能体提供低成本、可控且多样化的交互反馈。
输入:代理在与真实环境交互前,对某种未来状态或结果信息的查询意图(如“若执行动作 a,会发生什么?”或“类似任务过往的经验是什么?”)。
关键模块——六种功能形式的世界代理:
- 动力学代理(Dynamics Proxy):类似经典世界模型,预测原始物理状态转移,但更强调对代理后续决策有用的紧凑表示。
- 空间代理(Spatial Proxy):提供环境的空间结构或几何约束信息,帮助代理高效导航或操作。
- 执行代理(Execution Proxy):模拟动作执行后的结果状态(如代码执行结果、机械臂运动轨迹),直接产出可验证的执行效果。
- 记忆/经验代理(Memory/Experience Proxy):检索并合成过往经验或情景记忆,作为历史信息的实时浓缩。
- 技能代理(Skill Proxy):将复杂动作序列抽象为可复用的技能或选项,支持分层规划。
- 奖励/验证代理(Reward/Verification Proxy):直接生成奖励信号、评判或验证标签,用于策略评估与安全约束。
这些代理将世界建模的核心对象从物理状态转移变为代理可用信息转移,输出内容可以是状态预测、经验摘要、技能调用、奖励值等,覆盖多种反馈模态。
输出与赋能层级:世界代理的输出在不同层级上增强代理能力:
- L1 推理时引导:将代理输出作为上下文信息,直接改善即时决策质量。
- L2 训练时优化:利用代理产生的奖励、合成轨迹等,进行策略学习或离线强化学习。
- L3 代理-代理协同进化:真实环境反馈持续更新世界代理与智能体,形成闭环演化。
差异点:相比传统世界模型仅聚焦下一帧物理预测,本工作将世界建模扩展为六类功能代理,并系统化其与代理训练的集成方式,使世界建模从静态环境模拟升级为主动的、代理驱动的信息基础设施。
实验
实验设计说明
本文是立场性论文,未提出新模型或进行独立实验;其核心贡献在于重新定义世界模型为智能体中心的世界代理(Agent-Centric World Proxy),并给出分类框架与赋能路径。文章通过系统梳理现有工作,将世界代理按反馈模态分为六种功能形式(dynamics, spatial, execution, memory/experience, skill, reward/verification),并分析其如何在三个层级(推理时引导、训练时优化、代理-代理共同进化)上提升智能体。
关键发现
- 范式转移:从“物理状态转移预测”转向“智能体可用信息转移”,例如执行结果、检索经验、验证信号等,使世界代理输出直接服务于决策与学习。
- 六类功能代理 覆盖了智能体所需的多样性反馈:动力学代理继承传统世界模型;空间代理提供布局理解;执行代理模拟动作后果;记忆/经验代理封装历史;技能代理封装可复用能力;奖励/验证代理提供评判信号。
- 三层赋能路径 递进式地利用代理增益:L.1 丰富上下文信息(如合成 rollout 嵌入 prompt);L.2 生成训练信号(奖励、批评、合成轨迹用于策略优化);L.3 代理与代理共同适应,真实环境数据持续更新代理模型,形成闭环进化。
对比传统世界模型
传统世界模型(如 Dreamer, SimPLe)局限于像素/状态预测,反馈类型单一,且多为离线训练后固定不变。本文提出的代理-代理共同进化理念(L.3)代表了最大差异:代理不再是一次性训练的静态模拟器,而是随智能体与环境交互动态更新,实现双向适应。此外,将奖励/验证代理显式纳入世界建模范畴,使反馈直接对齐任务目标,避免了从物理状态间接推导的困难。这些设计为未来构建可扩展、更高效的智能体训练基座提供了清晰路线,但尚需在具体任务上进行大规模验证。
行业影响
落地场景
论文提出的 Agent-Centric Interactive World Proxies 框架可直接嵌入需要智能体持续交互学习的业务,例如:
- 机器人操控与自动驾驶:利用 dynamics proxy 和 spatial proxy 构建高保真仿真,替代真实物理测试。
- 对话与代码助手:execution proxy 和 reward/verification proxy 可模拟工具调用或代码执行结果,提供即时验证信号。
- 推荐与内容分发:memory/experience proxy 可检索历史交互模式,为排序策略提供上下文增强。
商业价值
- 降本:将大量试错从昂贵的真实环境(如路测、沙盒实验)迁移至虚拟代理,节省硬件、运维和风险成本。
- 增效:支持快速并行训练与推理时引导,缩短模型迭代周期,尤其适合需要频繁在线学习的场景。
- 体验提升:通过 L.1 Inference-Time Guidance 实时注入高信息量反馈,使智能体决策更精准,减少对真实用户的干扰。
与现有工作流的接口
世界代理可以轻量级集成到现有 MLOps / RL 训练栈中:
- 数据层:代理输出可作为额外的特征源或奖励函数,与真实交互数据混合使用。
- 训练层:L.2 Training-Time Optimization 生成的合成轨迹可直接送入策略优化算法(如 PPO),替代或补充真实经验。
- 部署层:提供统一 API,智能体在决策前先查询代理,实现 L.3 co-evolution,代理随真实反馈持续更新模型参数。
具体用例
- 电商搜索排序:使用 execution proxy 模拟用户对搜索结果的点击、加购行为,为排序模型提供低成本在线评估信号,代替部分线上 A/B 实验,降低对真实流量的依赖。
- 自动驾驶感知迭代:利用 spatial proxy 生成多样化传感器数据,结合 dynamics proxy 预测场景演化,在仿真环境中完成感知模型的闭环训练与验证,加速算法落地。
局限
- **缺乏实验验证和定量对比:** 论文提出的 Agent-Centric Interactive World Proxies 框架目前仍停留在概念和分类层面,未在具体任务或环境中进行实验。六种代理形式和三个赋能层次的有效性仅通过理论分析说明,缺少与现有世界模型方法(如 Dreamer、Genie)的性能对比或案例研究,削弱了框架的实用说服力。
- **代理形式之间的关联和融合不足:** 虽然将世界代理划分为 dynamics、spatial、execution 等六类,但对这些代理如何协同工作、是否存在信息冗余或冲突缺乏深入讨论。实际应用中,智能体可能需要同时利用多种代理,论文未给出组合策略或统一接口设计,导致框架的实施指引不够清晰。
- **对真实部署的约束考虑较少:** 论文强调 world proxy 可替代真实环境交互以降低成本,但未分析代理模型自身的构建和维护成本(如训练数据获取、模型更新频率),也未讨论代理与真实环境之间的分布偏移(distribution shift)对智能体策略迁移的影响。在持续进化场景中,代理模型的过时或偏差可能导致误导性反馈,这一潜在风险未被充分评估。