Knowledge-Geometry Decoupling: Refreshable Pretrained Transfer for Streaming Recommendation
工业推荐系统日益采用预训练-迁移范式,但行为分布漂移引发两个问题:从行为序列中学到什么,以及如何在预训练模型持续刷新时迁移所学知识。为此,我们提出 Knowledge-Geometry Decoupling (KGD)。 关于学什么,传统 next-token 预测将相邻项视为依赖,可能编码跨无关会话的虚假转换。我们引入 Behavioral Multi-Token Prediction (BMTP),仅保留协同或语义相关的未来项作为监督,从而获得更干净、更可迁移的行为知识。关于如何迁移,预训练知识与任务特定几何对共享参数施加冲突的优化需求。为解决该问题,KGD 将它们分配到独立参数集:可刷新的编码器持有行为知识,而任务学习器通过只读交叉注意力读取上下文编码器状态,并通过与预训练嵌入正交的 Anchored Calibration Residual (ACR) 写入任务特定几何。这种解耦所有权使知识持续刷新,而不受任务梯度干扰或使下游适应失效。 KGD 在八个公共基准上比强预训练-迁移基线提升 4-12%,并在 90 天生产流中保持优势,而基线无增益。KGD 已在 Shopee 全面部署。在 Shopee 主页搜索的在线 A/B 测试中,它使每用户 GMV 提升 1.75%,广告收入提升 1.53%,展示了高实用价值。核心实现见 https://github.com/FuCongResearchSquad/KGD4REC。
论文精读
TL;DR KGD 将预训练知识与任务几何解耦,通过 BMTP 清洗行为信号,实现可刷新的迁移学习,在流式推荐中持续提升效果,并在 Shopee 搜索场景带来 GMV 与广告收入的显著增长。
问题
问题背景
流式推荐系统逐渐采用 预训练-迁移学习范式(pretrain-then-transfer),希望借助大规模行为序列预训练来提升下游任务性能。然而,用户行为分布随时间持续漂移,使得预训练模型需要频繁刷新,但下游适配如何同步更新仍是一个开放问题。
现有方法局限
- 监督信号选择粗糙:传统 next-token prediction (NTP) 将序列中的邻接关系直接等同于行为依赖,会编码大量跨会话的虚假转移(spurious transitions),导致学到的知识噪声高、可迁移性差。
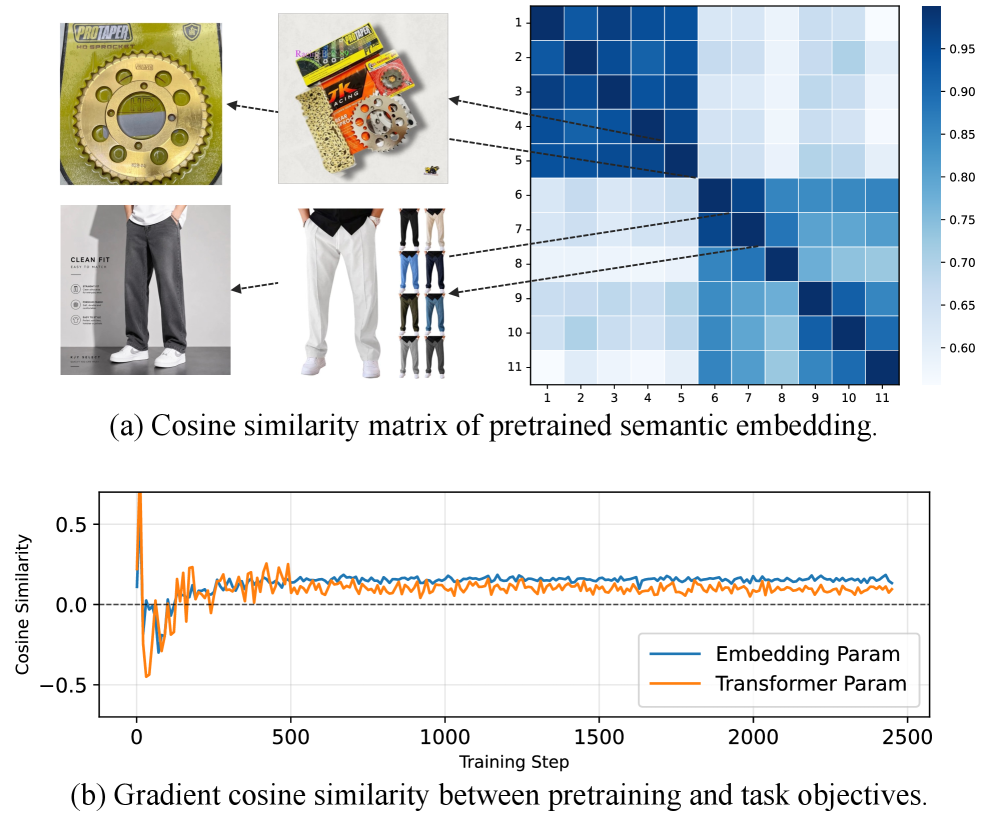
- 参数复用带来优化冲突:常规做法让同一个 encoder 既承载可刷新的行为知识,又承载下游任务特定的几何结构(task-specific geometry)。当预训练模型持续刷新时,下游梯度会干扰新知识的编码,而旧的任务几何也可能失效,难以实现持续的增量刷新。
问题难度与重要性
- 技术挑战:一方面要设计出能区分真实依赖与噪声的预训练目标,提取更纯净的可迁移行为知识;另一方面需要将知识编码与任务几何解耦,使两者可以独立更新而不相互破坏。这要求模型架构在参数所有权(ownership)上做出根本性调整。
- 业界关注度:大型工业推荐系统(如电商搜索推荐)的业务收益与模型对行为漂移的适应速度直接相关。若无法持续刷新预训练模型,线上效果会随分布漂移而衰减。该问题在流式推荐、在线广告、内容分发等场景中普遍存在,具有高商业价值。
行业类比
类似于大语言模型通过 RLHF 持续对齐人类偏好,但推荐模型面临的是行为分布的非平稳性,需要架构层面的知识-几何解耦,才能像刷新模型权重一样安全地吸收新行为模式。
核心洞察
- 传统预训练使用 next-token 预测,将序列中的邻近交互视为依赖,但行为序列中跨 session 的相邻项常为虚假关联,导致学到的知识噪声大、迁移性差。本文提出 Behavioral Multi-Token Prediction (BMTP),仅保留与当前行为具有协同过滤或语义相关性的未来 token 作为监督信号,从源头提升预训练知识的纯度,使迁移学习更高效、更鲁棒。这与纯序列建模方法(如 SASRec、BERT4Rec)有本质区别,将依赖关系的定义从“位置邻近”转向“语义/协同邻近”。
- 在流式推荐场景中,推荐模型需持续从新行为中更新预训练知识,而下游任务优化又要求模型几何稳定,两者在共享参数上形成冲突。KGD 通过参数所有权解耦解决这一矛盾:刷新式编码器持有行为知识,任务学习器通过只读交叉注意力读取编码状态,并通过 Anchored Calibration Residual (ACR) 在正交方向写入任务专属几何,确保编码器持续刷新时既不干扰下游适应,也不丧失预训练收益。相比常规的冻层微调或渐进式更新,这种解耦机制从根本上避免了知识干扰与灾难性遗忘,为流式推荐中的持续迁移提供了可行架构。
方法
输入:用户行为序列
KGD 的输入为包含多会话(session)的用户行为序列,如点击、购买等隐式反馈。传统预训练范式常采用 next-token prediction,强制模型学习相邻物品的转移关系,但相邻未必具备真实依赖——不同会话间的边界可能引入大量伪相关。
关键模块一:行为多 token 预测(BMTP)
BMTP 在预训练阶段重构监督信号:对序列中的每个位置,不从全部序列中截取下一物品,而是基于协同过滤或语义相似性,从未来物品中筛选出具有真实依赖关系的多个 token 作为监督目标。该策略过滤了跨会话的噪声转移,使编码器学到更纯净、可迁移的行为知识。预训练损失仅作用在筛选后的目标上,模型不再被强制记忆无意义的邻接模式。
关键模块二:知识-几何解耦(Decoupled Read–Write Ownership)
预训练知识与下游任务特定的表示几何(geometry)若共用同一组参数,优化方向冲突明显:刷新知识会扭曲任务几何,反之微调任务会遗忘已学知识。KGD 将参数拆分为两个独立角色:
- 可刷新编码器(refreshable encoder)拥有行为知识,可随流式数据持续更新;
- 任务学习器(task learner)通过只读交叉注意力(read-only cross-attention)消费编码器的上下文化状态,同时通过 ACR(Anchored Calibration Residual) 模块写入任务特定几何。ACR 保证其产生的残差与预训练嵌入正交,即任务适配不侵入编码器的知识空间。
这种读写所有权分离的设计,使得编码器可按一定频率刷新,而任务学习器保持冻结或仅轻量微调,彻底避免梯度干扰。
输出:下游推荐预测
经过解耦架构,任务学习器输出最终推荐结果(如下一物品的概率)。在流式推荐场景,编码器不断吸收新行为数据,而下游适配层无需重新训练即可受益于知识刷新,实现了可持续的在线迁移。
差异点
与常规 pretrain–transfer 方法(如参数共享 + 周期全量微调)相比,KGD 通过所有权解耦将知识刷新与任务适配严格分离,既允许知识持续进化,又保障下游模型稳定,解决了长期存在的刷新遗忘与梯度冲突难题。
实验
实验设计描述
- 离线评估:在 8 个公共推荐基准数据集(如 MovieLens, Amazon 等)上对比强预训练-迁移基线,同时使用 90 天实时生产流数据进行流式场景验证。
- 在线评估:在 Shopee 首页搜索进行 A/B 测试,衡量对关键业务指标的影响。
- 核心基线:传统 next-token prediction 预训练 + 共享参数的迁移学习范式。
关键发现
- KGD 在公共基准上带来 4–12% 的相对提升(如 Recall@K, NDCG@K),显著优于基线。
- 在 90 天生产流中,基线性能无正向收益,而 KGD 持续保持优势,证明其在分布漂移下的鲁棒性。
- 在线 A/B 测试:每用户 GMV 提升 1.75%,广告收入提升 1.53%,验证了实际业务价值。
- 消融实验表明,BMTP 与参数解耦设计各自贡献明确,联合效果最佳。
与基线的对比解读
- 知识学习:传统预测将序列相邻视为依赖,易引入跨会话噪声;BMTP 仅利用协同或语义相关的未来物品作为监督,产出更纯净、可迁移的行为知识。
- 知识迁移:共享参数导致预训练目标与下游任务优化冲突;KGD 通过刷新编码器与只读任务学习器解耦,并利用 ACR 在预训练嵌入正交方向写入任务几何,彻底消除梯度干扰,使持续刷新不失效下游适配。
行业影响
落地场景
KGD 直接适用于采用 预训练‑迁移 范式的流式推荐系统,尤其是行为分布随时间剧烈漂移的场景。典型的落地产品包括:
- 大型电商搜索与推荐信息流(如 Shopee Homepage Search),物品规模和用户兴趣变化快,需要模型持续更新;
- 短视频或社交媒体内容推送,热点快速转移,不同下游任务(点击率、时长、广告)共用底层表示;
- 新闻或音乐流媒体服务,用户口味实时变化,且多任务(如推荐、去重)要求解耦。
KGD 的 BMTP 过滤了会话间的虚假转移,产出的预训练知识更干净、更可迁移;而解耦读写所有权则让预训练编码器能被独立刷新,下游任务模型无需重新微调,从根本上解决了知识刷新与任务几何冲突的矛盾。
商业价值
- 增收:在线 A/B 测试证明 GMV 上涨 1.75%,广告收入提升 1.53%。在亿级用户的电商平台,这个相对提升可转化为巨大的绝对收入增量。
- 降本:传统预训练‑迁移范式中,刷新编码器往往需要重新微调所有下游模型,耗时且消耗大量算力。KGD 通过参数解耦实现 zero‑cost model refresh,下游任务模型保持不变,大幅节省 GPU 资源和工程师维护成本。
- 体验提升:模型更快适应新的行为分布,推荐结果更贴合近期偏好,提升用户粘性和转化率,同时保持多任务间的稳定协同。
与现有产品/工作流的接口
KGD 可作为现有推荐训练栈的插件式升级:
- 离线预训练:用 BMTP 替代常规的 next‑token prediction 作为监督信号,生成预训练编码器。
- 任务模型训练:下游任务模型通过 read‑only cross‑attention 和 ACR 从编码器中读取上下文表示,并写入任务特定几何(与预训练嵌入正交)。
- 在线服务:编码器与任务模型分开部署;刷新时只需更新编码器参数,任务模型保持冻结。这兼容常用的参数服务器(Parameter Server)和模型服务系统(如 TensorFlow Serving),可直接嵌入现有 CI/CD 管道,实现低摩擦的持续集成。
具体落地实例
跨国电商平台的搜索推荐:平台每日产生数十亿用户行为,使用 KGD 后,中心化预训练的编码器持续吸收最新交互模式,而不同市场的排序模型仅通过轻量 ACR 适配几何。全球各区域无需分别全量重训,保证了模型时效性,同时避免区域间的梯度冲突,显著降低延迟和运维成本。
社交媒体短视频推荐:用户兴趣热点迅速迁移,平台同时运行点击率优化、创作者激励、广告投放等多个目标。KGD 的解耦机制让编码器定时刷新,所有下游任务模型共享更新后的表示,而不会互相干扰。当流行话题变更时,仅刷新编码器即可让所有业务目标受益,保障用户体验与广告变现效率。
局限
- **计算与存储开销增加**:KGD 的解耦设计引入了独立的 task learner 和交叉注意力机制,以及锚定校准残差的正交化约束,这会增加训练时的参数量和计算复杂度。尽管论文在工业部署中证明了收益,但未详细对比推理延迟与显存占用,对于资源受限的实时推荐系统可能构成负担。
- **长期漂移适应性的理论保障不足**:KGD 假设定期刷新 encoder 可适应行为分布漂移,但 task learner 的只读访问和正交约束依赖于初始预训练嵌入的锚定。当分布发生剧烈变化时,过时的 task learner 与不断更新的 encoder 之间可能出现语义不匹配,论文缺乏对长期运行中模型一致性的理论分析或实验验证。
- **预训练任务与下游任务的通用性**:BMTP 通过协同或语义相关性筛选未来 item 作为监督,依赖于协同过滤信号或语义相似度。当切换到全新领域或冷启动物品增多时,相关性估计可能不准确,影响知识质量。论文未在跨域迁移或低资源场景下评估 KGD 的鲁棒性。