Hunyuan3D-Buffalo 1.0: 面向可扩展3D生成、理解与编辑的统一多模态模型
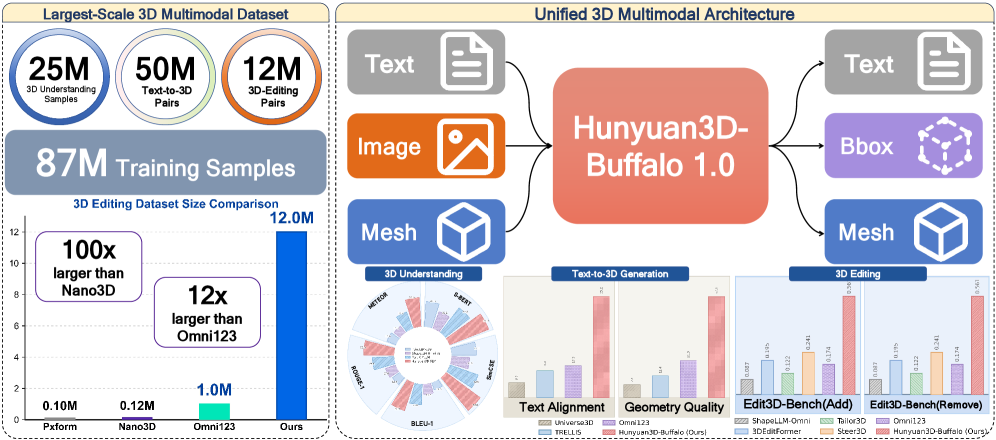
近期图像生成领域的进展证明,整合理解、生成与编辑的统一多模态模型具有巨大潜力。然而,统一3D建模仍受限于多模态数据稀缺,尤其是缺乏大规模且几何一致的编辑数据。为此,我们提出 Hunyuan3D-Buffalo 1.0,一个在单一架构中支持3D理解、文生3D、指令引导的3D编辑以及文本驱动的部件生成的统一框架。 为实现可扩展训练,我们构建了87M规模的3D多模态语料库,包含25M理解样本、50M文生3D对,以及利用 Nano3D-v2 生成的12M编辑对。架构上,该框架结合 Hunyuan3D-VLM(负责语义、结构与空间理解)与 Hunyuan3D DiT(负责高保真3D合成)。VLM为生成提供多模态语义条件,而编辑与部件生成则额外以源物体表示作为扩散过程的条件,以保留其整体结构及未编辑区域。 大量实验表明,Hunyuan3D-Buffalo 1.0 在文生3D与3D编辑基准上达到最先进或领先性能,同时展现出强大的理解与部件生成能力。我们的分析进一步显示,生成与理解相互促进编辑效果,验证了统一3D多模态训练的有效性。
论文精读
TL;DR Hunyuan3D-Buffalo 1.0 是一个统一多模态框架,将 3D 理解、文生 3D、指令编辑和部件生成整合到单一架构,并基于 87M 规模数据实现可扩展训练,在多项 3D 任务达到领先水平。
问题
近年来,图像生成领域通过统一多模态模型 将理解、生成与编辑融为一体,而 3D 内容生成仍被任务割裂所限制:理解模型(如点云分类、3D VQA)、生成模型(如文本到3D 扩散)和编辑模型独立工作,无法共享形状先验与语义知识。
现有方法的局限集中体现在数据侧:
- 任务割裂:3D 理解、生成和编辑各自训练,导致特征复用率低,多任务需维护多个专用模型,工程开销大。
- 编辑数据极度稀缺:构建几何一致的 3D 编辑对 需保证未编辑区域结构不变,传统合成流水线难保证大规模产出,现有数据集常因形状操作引起非编辑区域变形。
- 文本到3D 数据质量瓶颈:多样性与几何保真度难以兼顾,粗粒度合成导致形状失真或纹理模糊。
这一问题的挑战性与重要性在于:需自动化合成 8700 万规模的高质量多模态数据,并在统一架构中融合 VLM 的语义理解与 DiT 的生成能力,实现多任务联合训练而不牺牲单项性能。统一 3D 模型可大幅降低内容生产中的模型切换与人工修正成本,推动 3D 工业流程的范式升级。例如,类似 Stable Diffusion 3 将文本到图像与图像编辑统一在扩散架构内,3D 领域的统一模型正成为游戏资产、电影特效等应用的基础引擎。
核心洞察
- **统一多模态3D架构** 将理解、生成、编辑与部分生成融合于单一模型,突破了此前各任务独立建模的范式。该工作表明,共享的语义理解和生成模块可以通过多任务训练相互增强——例如理解能力提升编辑的指令遵循,生成数据改善对几何结构的隐式建模。与只做生成或编辑的模型相比,这种紧耦合设计更贴近真实应用场景,为构建通用 3D 基础模型提供了可行路径。
- **87M 规模的 3D 多模态数据构建流程** 系统化地合成了 25M 理解样本、50M 生成对和 12M 编辑对,解决了统一 3D 模型训练中数据稀缺与不一致的问题。关键创新在于使用 Nano3D-v2 自动生成高质量、几何一致的编辑数据,并通过五阶段管线严格控制语义对齐与几何质量。这种数据驱动方法使得大模型训练成为可能,而不再依赖昂贵的人工标注或零散的多源数据。
方法
Hunyuan3D-Buffalo 1.0 采用“输入→双分支处理→任务特定条件化→输出”的统一管线,支撑 3D 理解、文本生成 3D、指令编辑、文本接地部件生成 四类任务。
输入与整体架构
- 文本描述 驱动生成与部件生成;源 3D 对象 + 编辑指令 驱动编辑;3D 对象 + 自然语言问题 驱动理解。
- 核心由两大组件构成:
- Hunyuan3D-VLM:一个 3D 感知的视觉语言模型,接收多视角渲染图或 3D token,输出语义、结构与空间理解隐状态,提供多模态条件。
- Hunyuan3D DiT:基于扩散 Transformer 的 3D 生成主干,从噪声中逐步去噪生成 3D 隐表示(再解码为网格/纹理)。
条件化与任务流
- 文本→3D 生成:VLM 将文本编码为隐状态,直接注入 DiT 作为条件,指导扩散过程生成与描述一致的 3D 形状。
- 3D 编辑:额外引入 源对象条件化。先将源 3D 对象通过 VLM 或其他编码器得到结构表示,在扩散去噪每一步与编辑指令条件拼接,约束未编辑区域与整体结构不变,只修改指定属性。编辑流程包含锚视角选择、体素编辑、细粒度几何纹理优化等步骤,确保局部编辑的几何一致性。
- 部件生成:类似编辑,但条件为文本指定的部件语义,扩散过程聚焦在生成特定部件,同时保持物体其余部分不变。
- 3D 理解:VLM 直接作为问答模型,对 3D 场景进行语义推断,无需 DiT。
训练策略
分 4 阶段递进:先单独训练 VLM(3D 理解基础),再预训练纯文本到 3D 的 DiT,然后联合多任务进行 Omni 预训练 让 VLM 与 DiT 对齐,最后继续预训练扩大数据规模。该策略缓解了多模态数据异构带来的优化冲突。
与同类方法差异:传统方案往往将理解、生成、编辑独立建模,本工作首次在单一架构中统一四类 3D 任务,并通过 源对象条件化 解决了编辑中非目标区域保真度难题,使得生成与理解能力能相互增强编辑效果。
实验
实验设计
模型在四个任务维度进行评估: 3D 理解 (语义、结构、空间推理)、文本到 3D 生成 (消融训练数据量的影响)、指令引导的 3D 编辑 (基于 Edit3D-Bench 的定量对比与局部一致性分析) 以及 文本地基的部分生成。框架采用分阶段训练策略, 涵盖 3D-VLM 预训练、单任务生成预训练、全任务混合训练及持续预训练。
关键发现
- 统一架构在文本到 3D 生成与 3D 编辑 两大基准上均达到 SOTA 或领先水平, 且额外展示了强大的 3D 理解与部分生成能力。
- 消融实验表明: 增加训练数据量 显著提升生成质量, 而将文本到 3D 数据扩展 还能进一步改善形状编辑的一致性。
- 多模态统一训练中,生成与理解任务相互促进, 进而提升编辑性能, 验证了联合建模的有效性。
基线对比解读
与之前的单任务或分离式模型相比, Hunyuan3D-Buffalo 的核心优势在于通过 VLM 为扩散模型提供语义条件, 并在编辑和部分生成时额外注入源物体表征以保持未编辑区域的结构稳定。这使得模型在编辑任务中比仅依赖文本或图像的基线具备更强的局部精准编辑能力和几何一致性。尽管具体数值未披露, 但摘要中强调的“最优或领先”表现暗示其已超越现有 3D 生成编辑分离方案, 为统一 3D 多模态模型提供了新的基准。
行业影响
落地场景
Hunyuan3D-Buffalo 1.0 作为统一的多模态 3D 模型,可同时覆盖理解、生成与编辑,直接赋能以下方向:
- 数字内容生产:游戏与影视行业的 3D 资产创建,通过文本或图像提示快速生成高质量模型,并支持局部编辑与部件级控制。
- 电商与交互式展示:商品 3D 模型的自动生成与实时修改,提升在线购物体验,降低手动建模成本。
- 工业设计与数字孪生:结合 CAD 数据的部件理解与生成,辅助原型设计、虚拟仿真与维护培训。
- 教育、医疗可视化:根据教学需求动态生成 3D 解剖、机械结构等示意模型,并支持交互式标注与编辑。
商业价值
- 降本增效:87M 规模的高质量训练数据与统一架构减少了多模型维护开销,单次推理即可完成生成或编辑,将专业 3D 美术师数小时的工作压缩至秒级,显著降低人力与时间成本。
- 体验升级:指令引导的编辑与部件生成允许非专业用户进行语义级修改,拓展了 UGC 创作工具的用户群;一致的多视角几何提高 AR/VR 沉浸感。
- 数据飞轮:通过统一训练,理解和生成能力互相促进,模型迭代后可快速适应新风格与新资产类型,形成可持续竞争优势。
与现有产品/工作流集成
- 3D 引擎与 DCC 工具插件:模型可封装为 REST/gRPC 服务,或通过 ONNX/TensorRT 部署后以插件形式嵌入 Blender、Unity、Unreal Engine,在编辑器中接收自然语言指令生成或修改对象。
- 云端管线:支持接入 AWS Sagemaker、NVIDIA Omniverse 等平台,作为
Mesh Generation、Scene Understanding等管线节点,与现有的NeRF、photogrammetry流程互补。 - 开放协议对接:输出标准
glTF/USDZ格式,可直接导入 Web 3D 引擎(如 Three.js)或移动端 AR 系统,实现跨平台复用。
具体落地 Use Case
- 电商 3D 商品展示:某家具电商平台利用 Hunyuan3D-Buffalo,根据商品标题自动生成多视角 3D 模型,并允许运营通过“将沙发颜色改为深蓝”等指令实时编辑,大幅减少外包建模次数,同时提升 AR 试摆的转化率。
- 独立游戏开发:小型游戏团队在项目原型阶段,用文本描述批量生成场景道具(如“魔法书”、“齿轮装置”),并对已有资产进行细节调整(“给剑柄添加龙纹雕刻”),加速内容迭代,将更多精力集中在玩法设计上。
局限
- 依赖合成数据:论文所构建的87M规模数据集主要通过自动化流程及Nano3D-v2生成,尽管设计了多级过滤与质量评分,合成数据仍可能与真实世界3D资产分布存在偏差,尤其是编辑数据中的几何一致性可能受voxel精度限制,导致模型在面对复杂或非典型编辑指令时产生结构失衡或纹理失真。
- 训练流程与架构复杂性:Hunyuan3D-Buffalo 1.0 结合了3D-VLM与DiT,并采用四阶段序列训练,工程实现与超参调优成本较高,不利于快速复现与部署;此外,推理时需同时运行VLM和扩散模型,计算开销可能限制其在低延迟场景的应用。
- 编辑能力的边界:虽然方法支持指令引导的局部编辑并保留未编辑区域,但在大幅几何变形或跨类别属性编辑(如将椅子变为飞机)时,源目标条件机制可能无法保持语义一致性;论文未充分评估极端编辑场景或对抗性指令下的鲁棒性。