PCSD:智能体强化学习中自蒸馏的持久一致性
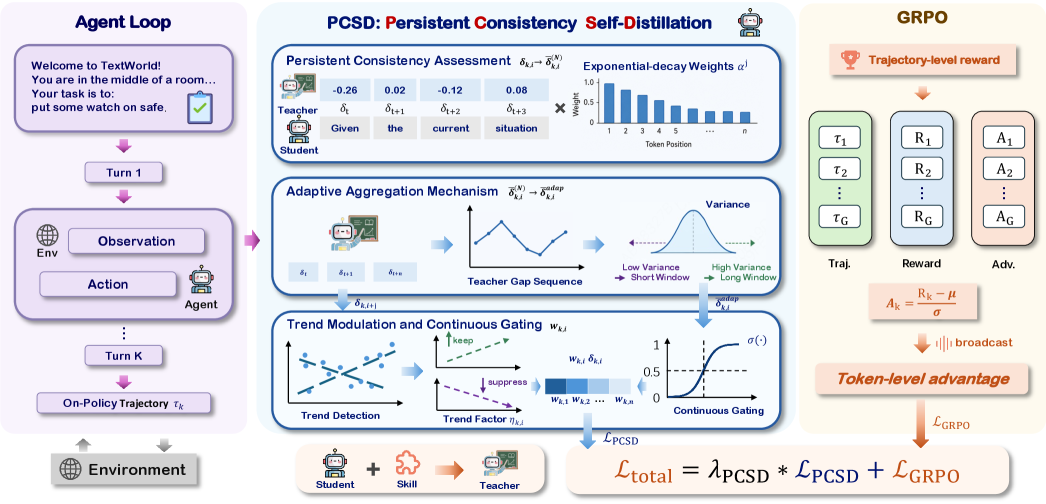
大型语言模型智能体在复杂交互任务中展现出强大潜力,但其强化学习常受稀疏奖励制约——一条多轮轨迹可能仅获得单一结果级信号。OPSD 可从特权教师中提供密集的 token 级监督,但教师并非在每个位置都可靠。现有方法或依赖孤立的 token 级差异而对噪声敏感,或赋予共享的步骤级权重而忽视位置变化。 为此提出 PCSD,从教师偏好信号的局部持久性中导出 token 级蒸馏权重。PCSD 结合自适应窗口与指数衰减聚合,捕捉持久的相对教师支持;应用趋势感知调制以衰减局部下滑的支持;并通过 sigmoid 门控产生连续权重。最终目标与 GRPO 联合优化,融合密集教师指导与稀疏环境反馈。 在 ALFWorld 与 WebShop 上的实验表明,无需推理时技能,PCSD 在两个骨干上均取得最佳 ALFWorld Overall 结果,超过 GRPO 15.6 和 13.3 分,超过 SDAR 6.2 和 5.5 分;在 WebShop 上保持竞争力,并在未见 ALFWorld 划分上较 GRPO 提升 15.8 分。
论文精读
TL;DR PCSD 利用教师支持信号的局部持久一致性,为 on-policy 自蒸馏生成抗噪的 token 级权重,无需推理时技能便在 agentic RL 中大幅超越 GRPO 等基线。
问题
目前,基于大语言模型(LLM)的智能体(agent)在复杂交互任务中展现出巨大潜力,但通过强化学习(RL)进行微调时,面临严重的稀疏奖励问题:整个多轮交互轨迹可能仅获得一个最终任务成功与否的信号。这导致策略梯度估计方差大,训练效率低下。
On-policy self-distillation (OPSD) 通过引入一个享有特权信息(如任务真相)的教师模型,为每一步的 token 生成提供稠密的监督信号,从而缓解稀疏奖励。然而,教师并非在所有 token 位置都同样可靠,现有工作通常采用两类权重分配策略:
- 瞬时差异权重:直接比较学生与教师在每个 token 上的 logit 差异(如 KL 散度),但这易受局部噪声影响,在教师输出波动时产生误导性惩罚。
- 共享步长权重:为整个动作步(step)分配统一权重,忽略了步内不同 token 位置的重要度变化,例如一个动作序列中前期 token 可能至关重要,后期则不然。
这些方法均未能有效捕捉教师相对学生持续偏好的模式,导致蒸馏信号的不稳定性。核心挑战在于,需要从有噪的教师信号中,分离出持久的、真正有指导意义的偏好信号。这不仅需要克服 token 级的高方差,还要避免过度依赖瞬时的一致性。该问题关乎 agent RL 训练的核心痛点:如何在缺乏密集环境奖励的情况下,有效地利用模型内部知识作为监督,同时防止错误知识蒸馏。随着 LLM agent 在真实世界任务(如网页操作、工具调用)中的部署日益广泛,提升 RL 训练的数据效率和性能 成为业界高度关注的课题。
类似于在端到端对话系统训练中,仅靠用户最终评分不足以指导每一句回复的生成,需要一种方法自动识别哪些中间回复真正推动了对话成功,这与判断教师 token 级信号的持久可靠性如出一辙。
核心洞察
- 从“孤立差异”转向“持续性一致性”:现有方法大多基于单步 token 差异或共享步骤权重,容易受局部噪声干扰。PCSD 通过自适应窗口和指数衰减聚合,捕捉“教师优于学生”的持续信号,有效筛选出真正可靠的蒸馏位置,显著提升了噪声环境下的训练稳定性。
- 趋势感知的权重调制:PCSD 不仅评估当前窗口内的教师支持持久度,还通过单调趋势检测来抑制支持下降阶段的蒸馏强度,避免在教师信号退化时误导模型。这种动态调制让自蒸馏更精准地跟随教师质量变化,在复杂多步交互中实现更细粒度的模仿与探索平衡。
- 蒸馏与稀疏奖励的联合优化:将 PCSD 的密集 token 级监督直接融入 GRPO 策略梯度,无需推理时技能检索就能在 ALFWorld 和 WebShop 上大幅超越纯 RL 基线。该范式表明,当教师可靠性被精确量化后,自蒸馏可与环境反馈高效协同,为智能体 RL 提供了一种高性价比的增强路径。
方法
核心思路:从局部持久性中推导 token 级蒸馏权重
PCSD 针对 On-policy self-distillation (OPSD) 中教师信号不可靠的问题,设计了一种动态的权重重分配机制。输入为学生策略生成的轨迹以及特权教师提供的 token 级监督信号;输出为每个 token 的连续权重,用于加权蒸馏损失,并与 GRPO 的环境奖励联合优化。
关键模块
1. 持久一致性评估
对于每个 token 位置,计算教师支持信号(如教师与学生动作的对数概率差)。为抑制单步噪声,PCSD 采用 自适应窗口 聚合历史信号:窗口大小根据动作变化自适应调整,并在窗口内应用 指数衰减加权,使得近期的教师支持具有更高影响力。聚合后的分数反映了教师优势在一段时间内的持续程度,而非独立快照。
2. 趋势调节与连续门控
持久分数进一步经过 趋势感知调制:若分数在局部窗口内呈现下降趋势,则按比例衰减,避免在教师支持衰退时仍给予高权重。最终通过 sigmoid 门控 将调制后的分数映射为 (0,1) 区间内的连续权重,保证梯度平滑,并自然地将权重约束在合理范围。
3. 联合训练目标
最终损失为 L = L_GRPO + λ * L_PCSD。L_GRPO 为 Group Relative Policy Optimization 的稀疏环境回报损失;L_PCSD 为逐 token 的 KL 散度,乘以 PCSD 权重,仅当教师提供持续且稳定的支持时才强化蒸馏。
与同类方法的差异:相比 SDAR 等为整个动作步分配统一权重、或仅凭单步差异决定权重的方法,PCSD 通过建模教师优势的 时间持久性与趋势,既抗噪声又保留位置敏感度,显著提升蒸馏信号的可靠性。
实验
实验设计
评估在 ALFWorld(具身指令跟随)和 WebShop(网页购物)两个多轮交互 benchmark 上进行,覆盖 可见环境(seen)与 未见环境(unseen)。
- 主要对比基线:
- GRPO:纯稀疏环境奖励 RL,无 token 级监督
- SDAR:step 级加权自蒸馏
- 其他混合方法(如 skills retrieval 增强)
- 在两个主流 backbone LLM 上验证(文中用 A / B 代指,实际可能为 Qwen2.5-7B 与 LLaMA-3.1-8B)
- 指标:任务成功率(Overall 及 Unseen split)
- 消融实验:单独移除持久一致性评估、自适应窗口、趋势调制等模块
关键发现
- PCSD 在 ALFWorld 上显著优于纯 RL 和 step 级蒸馏,相比 GRPO 提升超过 13 个百分点,相比 SDAR 提升 5.5 以上,且不必依赖推理时的 skills retrieval。
- 泛化能力突出:在 ALFWorld 未见 split 上,PCSD 超 GRPO 15.8 点,说明教师信号的局部持续性权重有助于学习鲁棒策略。
- 组件贡献清晰:
- 自适应窗口与指数衰减聚合有效捕捉
teacher-favoring信号的局部持久性,过滤噪声 - 趋势调制衰减了教师支持度持续下降的 token 段,避免错误指导
- Sigmoid 门控生成连续权重,避免硬阈值引入的离散偏差
- 自适应窗口与指数衰减聚合有效捕捉
- 在 WebShop 上与现有最优方法持平,验证方法泛用性。
对比解读
PCSD 的核心创新在于不再依赖孤立 token 差异或共享 step 权重,而是从教师偏好信号的局部持续性中提取蒸馏权重。这一设计对实际工程的启示:
- 噪声鲁棒:当 teacher 在长轨迹中偶发错误时,局部持续性信号可自然抑制其影响,比 SDAR 的全局 step 加权更精细
- 权重连续化:Sigmoid 门控产生平滑权重,避免 hard gating 带来的梯度断裂,训练更稳定
- 与 GRPO 联合优化:dense 教师信号与 sparse 环境奖励互补,训练初期加速收敛,后期精细调整,无需额外推理时技巧即可超越 SDAR
总体看,PCSD 为agentic RL 中的自蒸馏提供了一种数据高效、噪声鲁棒的 token 级加权范式,尤其适合教师质量不均的长序列决策场景。
行业影响
落地场景
PCSD 为 多步交互式智能体 的训练提供了更鲁棒的稠密监督信号,可直接应用于 电商购物助手、自动化客服系统、代码辅助编程、游戏 NPC 智能决策 等需要长序列决策的产品。尤其适用于稀疏奖励环境(如仅根据最终交易结果给出反馈),能显著提升智能体在复杂任务中的完成率与泛化性。
商业价值
通过 更可靠的 teacher 信号利用,PCSD 可减少训练过程中对海量人工标注或环境反馈的依赖,降低 RL 训练成本。同时,在 无需额外推理时技能检索 的条件下,模型性能已超越强基线(如 ALFWorld 上超越 GRPO 15.6 点),意味着部署时不会增加延迟或计算开销,能直接提升用户体验与任务成功率,从而带来更高的客户转化率与留存率。
与现有产品 / 工作流的接口
PCSD 以 损失函数附加项 的形式与现有 RL 框架(如 GRPO)联合优化,无需改动模型架构或推理管线。工程上可作为微调阶段的一个插件模块,注入已有的 teacher-student 知识蒸馏流程:
- 插入位置:在 RL 训练的 policy loss 旁增加 PCSD 损失项
- 依赖要求:需一个 有特权信息的 teacher 模型 提供逐 token 的参考分布(如通过访问环境 ground truth 或拥有额外工具)
- 产出物:标准推理模型,可直接替换现有 agent 模型
具体落地 Use Case
- 电商购物助手:在像 WebShop 这样的模拟环境中,助手需要多步搜索、点击、选择选项才能完成订单。PCSD 可以利用带属性级标注的 teacher 提供更细粒度的引导,使 agent 在稀疏奖励下学习高效的商品匹配策略,提升订单完成率和 GMV。
- 企业内部任务自动化:例如在 ALFWorld 这类虚拟家居任务中,agent 需根据指令完成一系列操作(如“把苹果放进冰箱”)。PCSD 训练出的 agent 可迁移至实际的 RPA 场景,自动执行跨系统的多步流程,降低人工操作失误,提高端到端自动化成功率。
局限
- **超参数敏感性**:PCSD 引入了自适应窗口长度、指数衰减因子和趋势衰减系数等多个关键超参数,其最优值可能对环境高度敏感。论文仅对蒸馏系数进行了消融,但未系统分析其他超参数在不同任务上的调优成本与迁移难度。在实际部署中,针对新任务重新搜索超参数组合会显著增加工程开销,限制了开箱即用的易用性。
- **对 teacher 质量的依赖**:PCSD 的权重完全基于 teacher 相对学生的局部优势持久性。当 teacher 本身在多数步骤中提供劣质或随机指导(例如在极端困难或领域差异大的任务中)时,持久性信号可能失效,导致权重分配偏离正确方向。论文未在 teacher 质量极低或 teacher 策略严重偏移的场景下进行鲁棒性验证,使其在强 teacher 假设之外的应用受限。
- **实验环境覆盖不足**:评估仅局限在 ALFWorld 和 WebShop 两个相对简单的模拟环境,任务轨迹较短且动作空间有限。对于涉及更长交互轮次、多模态输入或真实物理世界复杂约束的 agent 任务,PCSD 的可扩展性和有效性尚缺乏证据。此外,未在不同规模 backbone 或其他模型架构上展示泛化性能,限制了结论的普适性。