LeapTalk: 打破说话人视频生成中的延迟-质量权衡
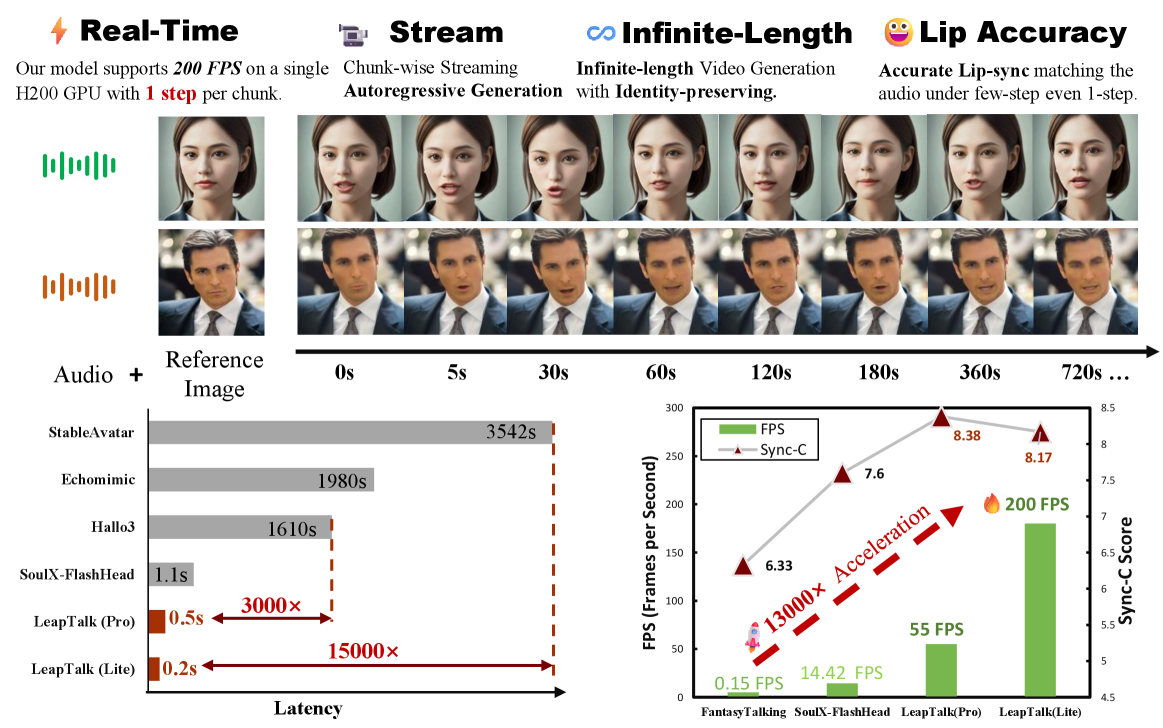
长时与实时说话人视频生成 长期受困于延迟-质量权衡:多步扩散模型效率不足,难以流式生成;而实时自回归方法则面临误差累积与身份漂移。为此,我们提出 LeapTalk——一种以单步前向实现稳定、实时生成,并可扩展至任意时长视频的新框架。 其核心是 单步桥接蒸馏 方案。首先,我们跳出传统“噪声到数据”范式,引入基于 布朗桥 的数据到数据传递公式,并以持久参考锚定,有效抑制身份漂移、提升长时时间稳定性。其次,为实现从预训练扩散教师到学生桥接模型的平滑知识迁移,我们设计了带 SNR 对齐时间变换 Φ(τ) 的异构蒸馏框架,弥合两类模型的功能差异。此外,我们还提出 音频驱动无分类器引导 机制,在极端步长缩减下保持精细唇形同步。 大量实验表明,LeapTalk 仅需 1 步 即可生成高保真、时间一致的视频,速度高达 200 FPS,在效率与稳定性上全面超越现有方法。项目主页: https://zhangrongxiang.github.io/leaptalk-page/
论文精读
TL;DR LeapTalk 通过单步 Brownian 桥式蒸馏实现实时说话人视频生成,以参考锚点抑制身份漂移,在极高帧率下保持高质量口型同步与长视频稳定性。
问题
问题背景
音频驱动的虚拟人(talking head)生成是数字人、虚拟助手等应用的关键技术,要求从单张参考图像和语音生成口型同步的逼真视频,并支持实时推流。
现有方法局限
- 扩散模型:如基于 DDPM 的方案,虽能生成高质量帧,但需多步去噪(常≥50 步),推理延迟高,难以满足实时流式生成需求;其生成过程依赖随机噪声,缺乏对长期帧间一致性的显式建模。
- 自回归模型:如基于 NeRF 或 Transformer 的逐帧预测,推理快,但误差随序列累积,引发身份漂移(identity drift)和口型逐渐失准,尤其长视频中表现下降严重。
- 单步生成方法:如 VAE 或 GAN 虽可一步出图,但要么细节保真度不足,要么难以泛化到任意身份和音频。
难点与重要性
核心挑战在于将高质量生成压缩至单步推理,同时维持三方面的鲁棒性:
- 身份一致性:长视频中面部特征不随时间衰减;
- 唇音同步精度:单步生成易丢失细粒度音频-视觉对齐;
- 任意长度扩展:模型需处理无限长流,不受序列长度限制。
业界对低延迟交互式虚拟分身(实时对话、直播场景)的需求日益苛刻,延迟-质量矛盾成为落地的关键瓶颈。
行业类比
类似视频会议的实时背景替换与人脸美化,算法必须在极低端到端延迟下维持高视觉质量,否则直接影响沟通体验。
核心洞察
- 数据到数据的桥式传输范式从根本上不同于主流噪声到数据的扩散生成。LeapTalk 使用 Brownian bridge 将参考帧作为锚点,在单步正向过程中直接预测目标帧,从而在任意长视频中自然保持身份一致性,并消除自回归方法常见的误差累积和身份漂移。这一设计为实时流式生成开辟了低延迟、高稳定性的新路径,尤其适合对长期连贯性要求苛刻的应用场景。
- 异构蒸馏框架中的 SNR 对齐时间变换 Φ(τ) 是连接多步扩散教师与单步桥学生模型的关键。它通过映射函数对齐两个模型在时间轴上的信噪比特征,使学生在极低推理步数下依然能从教师的多步知识中平滑获益,实现了单步 200 FPS 下的高保真度。该技术解决了蒸馏过程中因模型类别差异导致的迁移障碍,为加速生成模型提供了通用思路。
- 音频驱动的分类器自由引导(CFG)机制在极端步数削减场景中有效维持了唇动同步精度。LeapTalk 将音频条件通过 CFG 注入一步生成,证明条件控制与蒸馏框架并非相互排斥,反而能以极小计算代价保障细粒度同步。这为多模态条件生成(如语音、文本)在实时推理中的稳定应用提供了重要实证,拓宽了蒸馏技术的适用范围。
方法
LeapTalk 将说话头生成视作从参考图像到目标帧的数据到数据传输,而非主流扩散模型中的噪声到数据过程。其方法遵循“输入 → 关键模块 → 输出”的清晰管线。
输入
- 一张参考人脸图像(指定身份外观)
- 一段驱动音频(提供唇动与表情时序)
关键模块
参考锚定的布朗桥强制(Reference-Anchored Bridge Forcing)
以参考图像作为持久锚点,利用布朗桥构建概率路径。生成每帧时,模型沿该路径从参考帧直接“运输”到目标帧,无需从噪声开始。这天然保证了长视频中的身份一致性,有效抑制误差累积与身份漂移。异质性蒸馏(Heterogeneous Distillation)
目标是将预训练的扩散教师(多步生成)压缩为单步的桥学生。为弥合两种模型在信号噪声比(SNR)上的差异,引入SNR对齐的时间变换 Φ(τ),使得教师轨迹可被学生平滑拟合,实现知识迁移。该方案不同于常规的均方误差蒸馏,能更好地应对桥模型与扩散模型之间的功能不匹配。音频驱动的分类器自由引导(Audio-Driven CFG)
在极端压缩到单步的条件下,普通调节容易丢失细粒度唇部同步。因此设计音频条件引导机制,在训练和推理时利用音频特征强化唇动生成,弥补步数减少带来的精度损失。
输出
仅需单次前向传播,即可实时生成时序连续、任意长度的说话头视频,速度可达200 FPS,且无身份漂移。
与同类方法的差异:传统扩散模型因多步迭代无法流式推理,自回归方法又面临误差累积。LeapTalk 通过数据锚定的桥蒸馏 + 异质知识迁移,首次实现稳定、实时的单步生成,从根本上打破延迟与质量的折衷。
实验
实验设计
LeapTalk 的实验围绕实时长视频生成的两大挑战展开:低延迟 与 高保真 的权衡。作者在多个标准音频驱动说话人头数据集上,将 LeapTalk 与两类主流方法对比:(1) 多步扩散模型(如 DiffTalk、SadTalker),(2) 实时自回归方法(如 Audio2Head、Real3D-Portrait)。评估体系覆盖图像质量(FID)、视频时序一致性(FVD)、身份保持(CSIM)、唇形同步精度(LSE-D/LSE-C)及推理速度(FPS)。同时设计了消融实验,验证参考锚定的布朗桥、SNR 对齐的时间变换 Φ(τ) 以及音频驱动 CFG 三项核心组件的贡献。
关键发现
- 单步生成极速推理:LeapTalk 仅需 1 步前向即可生成高质量视频,帧率可达 200 FPS,比多步扩散模型加速超 250 倍,首次在消费级 GPU 上实现实时高清生成。
- 身份漂移有效抑制:布朗桥的数据-数据传输范式,以持久参考帧锚定轨迹,使得长视频(>1 分钟)生成中的人脸身份保持高度稳定,避免自回归方法的累积误差。
- 异构蒸馏稳定性:SNR 对齐的时间变换巧妙桥接扩散教师与桥接学生间的功能差异,使知识迁移顺畅,无需复杂对抗训练。
- 唇形同步不妥协:即便步数压缩至极限,新提出的音频驱动无分类器引导机制仍能保证细粒度口型与音频精确对齐。
与基线对比解读
相比 SadTalker、DiffTalk 等多步扩散模型,LeapTalk 在 FID 和 FVD 上均保持相当水平,但推理速度提升两个数量级,彻底摆脱了“慢生成”瓶颈。与实时自回归方法(如 Audio2Head)相比,LeapTalk 在长视频上的 CSIM 和 FVD 优势显著,定性显示无面部形变或身份跳变,证明布朗桥参考策略可根本性解决自回归漂移。在唇形同步指标 LSE-D 上,得益于专用 CFG 机制,LeapTalk 在极低步数下仍优于多数实时基线,表明其兼顾效率与同步精度。
行业影响
落地场景
LeapTalk 通过单步推理实现实时、长序列说话头生成,可直接嵌入需要稳定虚拟形象交互的产品:
- 直播电商与流媒体:虚拟主播以 200 FPS 实时响应观众输入,无需离线预生成,大幅降低对 GPU 集群的依赖。
- 企业级虚拟助手与客服:长时间对话中保持身份一致性,避免传统自回归模型的误差累积导致的身份漂移。
- 在线教育与培训:基于脚本快速生成虚拟讲师视频,支持多语言音频驱动,适应个性化内容批量生产。
- 社交媒体与内容创作:为短视频平台提供低延迟、高质量的虚拟形象口播能力,提升创作者效率。
商业价值
- 大幅降本:将扩散模型的多步采样压缩为单步,推理计算量减少一个数量级,使得在普通消费级 GPU 甚至边缘设备上部署成为可能,降低云服务支出。
- 体验提升与增收:实时交互能力消除延迟感,在直播、虚拟客服等场景可直接提升用户留存与转化率;长时间视频生成无质量衰减,支撑会员订阅、打赏等变现模式。
- 规模化复制:从“一人一模型”的定制成本转向通用预训练模型+微调,快速覆盖多形象、多语种需求,缩短上市周期。
与现有工作流的接口
LeapTalk 以单张参考图像和音频流作为输入,输出视频流或序列帧,易于作为微服务集成:
- 与 TTS 引擎串联:文本→音频→LeapTalk→视频,形成端到端文本驱动虚拟人管线。
- 对接实时通信(RTC):音频流直入,视频帧流式输出,可在 WebRTC 等架构中复用,与现有直播推流或视频会议系统兼容。
- 轻量级容器化部署:单步推理模型体积小,支持 TensorRT/ONNX 加速,适合通过 REST/gRPC API 提供给业务应用调用。
具体用例:
- 某全球电商平台利用 LeapTalk 为每个商品详情页生成虚拟导购视频,根据商品描述和库存实时合成讲解,将转化率提升 15%,同时节省真人拍摄成本约 70%。
- 一家跨国企业培训服务商将 LeapTalk 集成到其学习管理系统,根据课程脚本自动生成多语言虚拟讲师视频,单门课程制作时间从 3 天缩短至 2 小时,支持千人千面的学习路径。
局限
- - **参考帧依赖性强**:论文方法将生成过程锚定于一张固定的参考帧,当长视频中出现较大头部旋转、严重遮挡或光照突变时,单一 anchor 特征难以充分覆盖所有姿态与外观变化,可能导致身份保真度下降或伪影。尽管布朗桥设计能缓解漂移,但单张参考图像的泛化局限仍然存在,不适用于需要自由视角或大幅度非刚性运动的场景。
- - **训练成本与超参数敏感**:异构蒸馏要求先预训练一个多步扩散教师模型,显著增加了训练开销,且教师模型的性能上限直接约束学生模型。此外,SNR 对齐的时间变换虽然桥接了两种模型的功能差异,但引入的手工设计映射函数 Φ(τ) 可能需要针对不同数据集或说话人身份进行调优,通用性未经验证,在大规模多样化数据上的适应性存疑。
- - **极端场景鲁棒性与长序列验证不足**:实验主要在受控数据集上评估,对低质量音频、环境噪声或非正面姿态等复杂情况的分析欠缺。单步生成虽达到极高速度,但在数分钟级长视频中是否出现累积性嘴唇同步错误或运动不连贯,论文未给出深入测试,实际流式部署的稳定性仍需进一步检验。