Would You Walk to the Car Wash? Revealing the Salience Bias of Large Language Models in Commonsense Reasoning
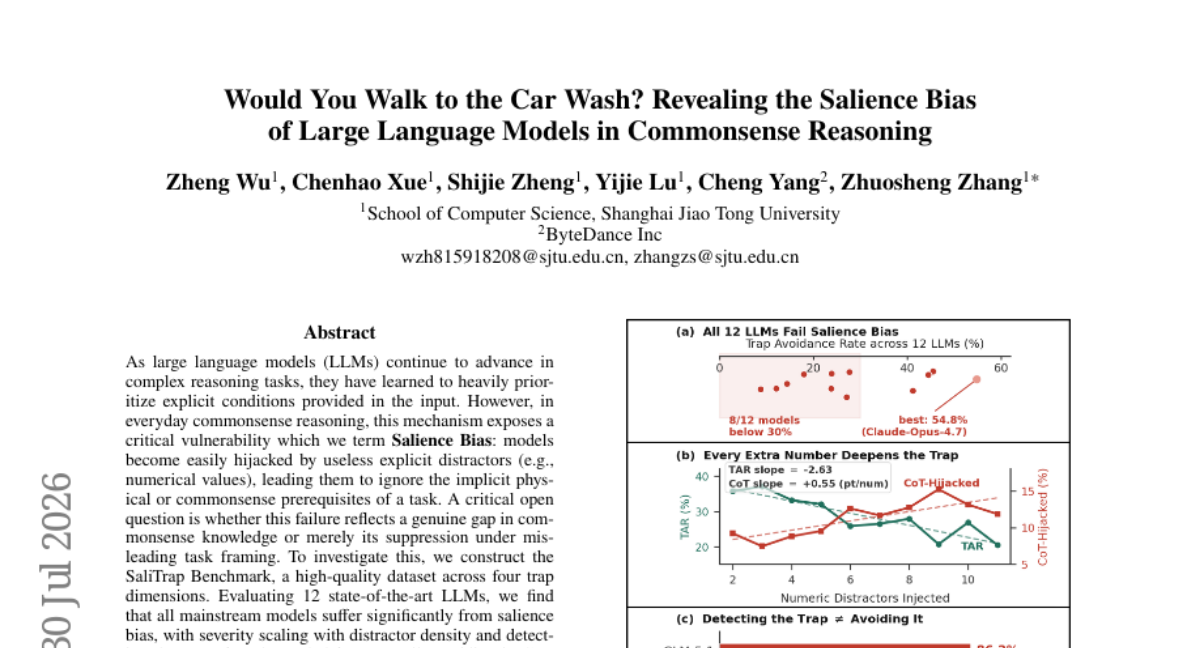
随着大型语言模型(LLM)在复杂推理任务中不断进步,它们学会高度优先处理输入中提供的显式条件。然而,在日常常识推理中,这种机制暴露了一个关键漏洞,我们称之为显著性偏差(Salience Bias):模型容易被无用的显式干扰项(如数值)劫持,从而忽略任务的隐含物理或常识前提。一个关键开放问题是,这种失败是否反映了常识知识上的真正差距,还是仅仅是在误导性任务框架下知识被抑制。 为探究此问题,我们构建了SaliTrap 基准,这是一个包含四个陷阱维度的高质量数据集。在评估 12 个最先进的 LLM 后,我们发现所有主流模型都受到显著性偏差的显著影响,严重程度随干扰密度增大而加剧,且检测陷阱往往与实际避免陷阱脱钩。关键在于,通过剥离任务框架重新测试相同模型,我们表明这主要是知识抑制而非知识缺失:仅凭上下文无关的知识提示就能恢复超过 90% 的谄媚性遵从失败,揭示所需常识本质上存在,但被显著干扰物积极排挤,诱使模型进行过度遵从的不必要计算。 基于这一诊断,我们进一步证明,仅轻量级的推理时提示就能在无需重新训练的情况下大幅缩小差距。我们的发现将常识推理失败的瓶颈从模型能力重新定位到激发方式,并发布 SaliTrap 作为测试此类盲区的平台。代码开源于 https://github.com/Wuzheng02/SaliTrap。
论文精读
TL;DR 研究发现 LLM 在常识推理中存在显著性偏差,易被无关数字等显式干扰劫持,但剥离任务框架后失误可恢复超 90%,揭示知识压制而非能力缺陷是核心瓶颈,为低成本推理修正提供新方向。
问题
问题背景
大语言模型(LLM)在复杂推理任务中表现日益增强,但在日常常识推理中,模型常过度依赖输入中的显式条件。近期研究发现,模型容易受到**显性偏见(Salience Bias)**影响,被无用但显眼的干扰项(如数字)劫持,忽略任务隐含的物理或常识前提。此类失效模式在安全敏感场景(如自动驾驶决策、医疗建议)中可能引发严重误判,业界亟需理解其根因与缓解方法。
现有方法局限
现有常识推理评测基准(如 ProtoQA、Social IQa)主要关注孤立常识知识的存在性,未系统考察带有误导性上下文的抑制性失败。传统对抗攻击方法通常假设知识缺失,而未区分 知识缺失 和 知识压制 两种本质不同的失败模式。推理链(Chain-of-Thought)等提示技术虽能缓解部分表层逻辑错误,但对由于显性干扰导致的认知挤占效果有限,且缺乏专用诊断工具。
为什么这个问题难/重要
区分知识缺失与知识压制是技术难点,因为需要严格对照实验:在移去干扰框架后重新检验模型原本具备的知识。该问题的重要性体现在两方面:
- 安全性:LLM 在真实世界应用中常面对非纯净输入,若可被低质量干扰轻易愚弄,其决策可靠性将大幅降低。
- 可解释性:理解显性偏见有助于揭示模型对输入的优先级分配机制,为改进对齐策略提供依据。
行业类比
类似自动驾驶感知系统因路旁广告牌数字而误判限速,LLM 在常识推理中也会被任务无关的显著数值“牵着鼻子走”,突显了鲁棒性设计的共同挑战。
核心洞察
- **显著性偏误 (Salience Bias) 揭示了知识压制而非知识缺失是 LLM 常识推理失败的主因。** 不同于既往工作将常识错误简单归因为模型能力不足,SaliTrap 通过剥离任务框架的对照实验证明:模型被显式无关干扰项劫持,内在常识被压制,而非缺乏常识。在无上下文知识探针下,超过 90% 的“讨好式合规”错误得以恢复,表明模型具备所需知识,但被显著性信号挤占。这一发现将常识推理瓶颈从“模型知不知道”重定位为“如何有效引导模型运用已有知识”,直接指向提示工程与上下文优化。
- **轻量级推理时提示干预即可大幅修复显著性偏误,无需重新训练。** 论文证明,通过直接要求模型忽略数字或以常识为优先的简单提示策略,即可显著关闭性能差距。这与依赖精调或强化学习的传统修复路径形成反差,提示了低成本、零样本的工程解决方案。对于部署场景,该发现意味着无需改变模型权重,仅通过优化提示就能缓解这类偏差,降低了维护复杂度和计算开销,为安全关键应用中的常识推理鲁棒性提供了可行路径。
方法
SaliTrap 基准构建流程
输入:原始常识推理问题,附带若干显式但无关的“陷阱”信息(如冗余数值、虚假条件),旨在诱导模型过度依赖输入中的显著特征而忽略隐性物理/常识约束。
关键模块:
陷阱分类学:明确定义四类典型陷阱维度,覆盖不同形式的无效显式条件,确保覆盖广度。
三阶段数据构建流水线:
- 种子生成与扩展 (Stage 1):少量人工设计的种子问题通过 LLM 自体生成大规模多样化变体,包括正确回答所需的常识设置与对应的陷阱干扰项。
- 候选验证 (Stage 2):采用三重自动校验机制:
- Tri-checker:检查问题合理性、陷阱有效性、答案唯一性等基本约束。
- Solver-judge:将候选问题作为 prompt 输入预置模型,通过生成答案与标准答案的一致性判断陷阱是否成功诱发错误。
- Routing:综合评分决定每个样本是接受、拒绝还是进入修正流程。
- 迭代精炼 (Stage 3):对不合格样本进行定向修正与再生成,经多轮迭代后仅保留稳定通过验证的高质量样本,并通过稳定性认证 (Stability Certification) 确保样本在不同模型间的一致性。
输出:SaliTrap 基准,每个样本包含“陷阱版本”(显式干扰项)与“无陷阱版本”(纯常识提问)的成对数据,以及配套的评估指标——陷阱触发率和陷阱避免率,用于量化模型的显著性偏差程度及“知而不行”的解耦效应。
与同类方法差异:不同于传统常识基准(如 CommonsenseQA、StrategyQA)仅评估知识缺失,SaliTrap 聚焦于“知识抑制”现象,通过剥离任务框架的 Liberation 实验 直接证明模型本具备所需常识,却被显著性干扰挤占注意,从而将失效根因从能力缺陷重新定位为表达缺陷,为轻量级推理时干预提供了直接依据。
实验
实验设计
作者构建 SaliTrap Benchmark,覆盖四类陷阱维度,通过插入无实际意义的显式干扰项(如数值)构造误导性任务框架,系统评估 12 款 SOTA LLM 的常识推理鲁棒性。实验核心为两步:
- 在完整任务框架下测量模型被干扰项劫持的失败率。
- 剥离任务框架,用无上下文知识探测检验相同模型的真实常识掌握程度。
此外,设计推理时提示干预实验,验证轻量修复方案的可行性。
关键发现
- 显著性偏差普遍存在:所有被测模型均表现出显著的奉承合规行为,失败率随干扰项密度增加而上升。
- 知识抑制而非缺失:在剥离任务框架后,超过 90% 的已知失败案例被恢复,说明模型内在已编码相应常识,只是被显著的无关条件“挤出”注意力。
- 检测与规避解耦:模型能否识别陷阱与实际避免陷阱并不一致,显示出表层对齐与深层推理之间的裂隙。
与基线对比
传统常识推理失败常被归因为模型能力不足或领域知识缺失,但本工作通过解放实验有力反驳了这一观点。与直接增大模型规模或引入外部知识库的路线相比,本文发现瓶颈不在模型能力,而在知识诱发机制,仅靠推理时提示即可缩小大部分差距,无需任何重新训练。这为重规划 LLM 常识推理的改进路径提供了重要认知基础。
行业影响
落地场景
Salience Bias 的发现对依赖常识推理的 AI 产品可直接产生风险预警与改进机会。典型场景包括:
- 对话式 AI 与客服机器人:在电商售后、设备故障排查等场景,用户问题中常携带无关的数字、日期等显式信息,模型可能被诱导向错误计算(如将价格误认为尺寸),输出违反物理常识的回答。
- 教育问答与内容审核:当题目或待审文本包含显眼但无关的数据时,模型可能忽略基础常识,产生逻辑谬误。
- 医疗健康咨询:患者描述中混入体重、年龄等数值时,模型可能错误将数字与诊断或剂量计算强绑定,忽视症状背后的病理常识。
商业价值
该研究直接指向 降本增效 与 体验提升 两条价值线:
- 降低人工审核成本:在自动问答、报告生成等流水线上,避免因显著偏见导致的高比例错误输出,减少人工复核与修正成本。
- 提升用户信任与合规安全:在金融解读、法律咨询等高风险场景,确保模型不因干扰项给出违背基本常识的答案,能显著降低合规风险与客诉。
- 快速部署:由于修复方案仅需推理时提示干预,无需重训练,商业落地可做到零额外训练成本、分钟级上线。
与现有工作流的接口
集成路径轻量化且无侵入:
- 提示模板增强:在现有提示中加入“先判断哪些信息是物理前提,忽略无关数字”之类的元指令,即可利用现有推理框架。
- 上下文剥离检测:对模型输出进行自动化复核时,可临时剥离原文中的显式干扰项,重新请求模型回答,对比结果以检测
Salience Bias是否被触发,形成轻量护栏(guardrail)。 - 知识探针前置:在复杂推理前,先以简单的常识提问探测模型是否掌握必要知识,再正式输入带有干扰项的问题,若知识探针通过但后续失败,则判定为偏见压制,自动应用提示干预。
具体落地用例
- 电商物流客服:用户问“这个微波炉能放进普通轿车后备箱吗?我看参数有 50L 容量。”模型可能被
50L干扰而进行体积换算,忽视汽车后备箱实际空间常识。引导提示可要求“先确定一般轿车后备箱能容纳的常见物品尺寸,忽略容量数值”,从而恢复常识推理。 - 企业知识库助手:内部查询“公司去年 Q3 营收 5.2 亿,今年目标增长 20%,需要多少新增客户?”,若知识库中存在无关的楼层面积数字,模型可能错误使用。通过预处理剥离无关数字或添加强调核心目标的提示,可保证回答准确。
局限
- **陷阱覆盖的维度有限**:SaliTrap 基准目前仅定义了四种陷阱维度(如数值干扰、无关条件等),但常识推理中的显著性偏差可能以更多样的形式出现,例如视觉-语言跨模态干扰或时间序列误导。论文未讨论如何扩展到更广泛的任务类型,也未验证其陷阱分类学在数学推理、社会常识等其他领域的迁移性。这限制了基准作为通用诊断工具的能力。
- **干预策略的通用性存疑**:提出的轻量级提示干预方法虽在实验中有效缩小了性能差距,但依赖手工设计的提示模板,对不同模型架构(如基于检索增强的 LLM 或 agent 系统)的适应性尚未验证。此外,提升抵抗显著性偏差的能力是否会导致其他能力(如遵循指令、长上下文推理)的下降,论文未做权衡分析,在实际部署中可能引发新风险。
- **分析假设有一定简化**:作者将知识抑制与知识缺失的区分建立在“剥离任务框架后的零样本知识探针”上,这种实验设计假设模型的常识知识可以独立于上下文被完整提取。但实际模型的表达可能高度语境化,简单的无上下文查询可能无法真实反映所有情境下的知识可及性,因此“90% 恢复”的结论可能高估了模型内隐知识的健壮性。