Qwen-UI-Agent 技术报告:迈向下一代以真实世界为中心的GUI基础智能体
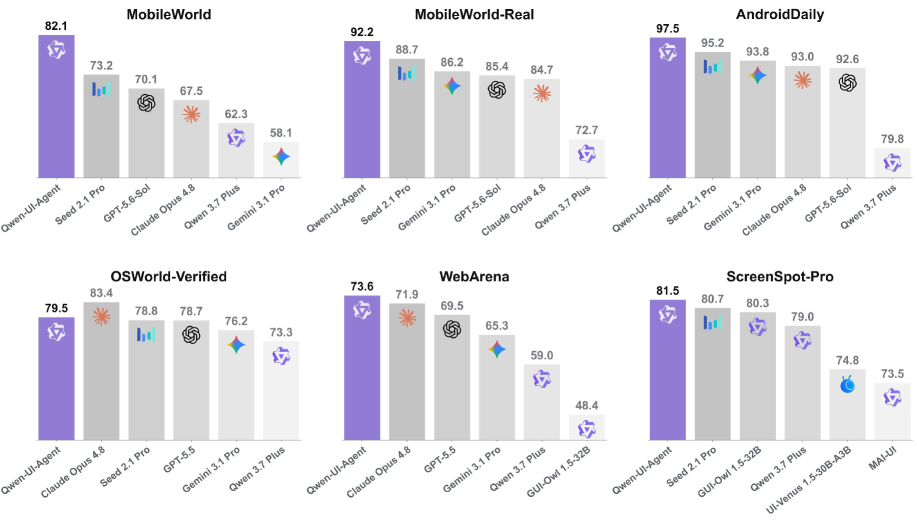
GUI智能体有望成为现有数字设备上的通用执行器。为了推动其向真实世界应用发展,我们设想智能体能够在真实设备上可靠运行、跨平台执行工作流、将GUI交互与CLI执行相结合、完成长时任务、主动发起有用服务,并以最少的人力自主提升能力。 基于这一愿景,我们提出 Qwen-UI-Agent,一个以真实世界为中心的GUI基础智能体,覆盖移动端、电脑使用、网页和 DeepSearch 环境。该智能体将多样化的沙盒环境与大规模真实设备移动运行时相结合,其统一动作空间可交错执行GUI操作与CLI命令,并在单个模型回合中生成批处理动作。一种 AutoResearch 风格的数据飞轮利用智能体构建任务和环境、诊断失败并规划后续迭代。在线强化学习支持超过100轮轨迹的训练,超过10,000个并发环境加速数据收集。轻量级工具层支持主动服务启动和跨移动端与电脑的状态化工作流。 在广泛的评测套件中,Qwen-UI-Agent 在移动端使用基准上取得了最先进性能,同时在电脑和浏览器任务上展现出与前沿模型相当的水平(包括 Opus 4.8、Gemini 3.1 Pro 和 GPT-5.6 Sol)。具体指标:移动端 MobileWorld 82.1%、MobileWorld-Real 92.2%、AndroidDaily 97.5%;电脑端 OSWorld-Verified 79.5%,OSWorld-v2 部分进展得分 40.0%;浏览器与GUI grounding 方面,WebArena 73.6%,ScreenSpot-Pro 81.5%。
论文精读
TL;DR Qwen-UI-Agent 是一个面向真实设备的通用 GUI Agent,混合 GUI 操作与 CLI 执行,通过真实移动端运行时、规模化数据飞轮和万级并发在线 RL,在移动、电脑、网页等任务上取得领先性能。
问题
问题背景
GUI 代理被视为通用数字执行器,有望在真实设备上自主完成跨应用、长周期任务。当前研究聚焦于提升代理在开放环境中的可靠性、跨平台能力以及自我进化能力。
现有方法局限
早期工作多基于仿真沙盒,与真实设备存在显著分布差异,导致代理对界面变化、系统弹窗等现实干扰极度敏感,失败率陡增。动作空间通常仅限于 GUI 点击/滑动,无法融合 CLI 命令处理复杂文件操作或系统级控制,且单步执行模式效率低,难以应对需要批量操作的长任务。数据获取依赖人工示范,成本高、覆盖窄,难以规模化。训练过程缺乏在线交互与自我纠错,代理会重复陷入相同错误模式,且不具备主动服务能力,无法根据通知等信号自主发起任务。
为何困难且重要
真实设备环境的多样性(不同 OS 版本、品牌定制界面、网络波动)带来长尾挑战,要求代理具备极强的泛化与鲁棒性。长任务中每一步错误都可能传导放大,需要跨步骤的规划、验证与动态调整能力。混合 GUI+CLI 动作空间的协调决策、批量动作的原子性保证,以及大规模并发训练环境的高效构建,都是工程与算法上的难点。业界正将 AI Agent 视为下一代人机交互核心,可靠的真实世界执行能力是商业落地的关键瓶颈。
行业类比
类似于自动驾驶从仿真向真实道路的跨越,GUI 代理也需要在真实设备的海量长尾场景中完成闭环训练,才能实现鲁棒的自主服务。
核心洞察
- **大规模实机移动运行时与代理驱动数据飞轮** 打破了 GUI 代理从仿真到真实设备的 sim2real 壁垒。以往工作几乎只在仿真环境(如 AndroidEnv)中训练,导致在真实手机上错误率剧增;Qwen-UI-Agent 部署了超过 100 台真机的运行时,并通过模型自身生成任务、合成验证器、分析失败并迭代的飞轮,实现了在真实场景中的持续进化,在 MobileWorld-Real 等 benchmark 上取得 92.2% 的准确率,远超仅依赖仿真的方案。
- **统一 GUI+CLI 行动空间与单轮批量动作生成** 赋予了代理在长程任务中跨模态高效决策的能力。传统 GUI 代理只能逐步发出一个操作,难以协调界面点击与命令行执行;Qwen-UI-Agent 允许单次推理输出一批操作(可混合 GUI 与 CLI),并能动态交错使用两种模态,将 bash 当作执行工具、GUI 当作感知反馈,使得在 OSWorld 等计算机使用任务中步骤延迟和错误传播显著降低,形成了「CLI 为手、GUI 为眼」的协作模式。
- **在线 RL 结合模型自适应课程与万级并发环境** 使代理能在超长轨迹(>100 步)中稳定学习。先前方法多为纯监督微调,难以应对动态环境中的错误累积;Qwen-UI-Agent 通过超过 10,000 个并行的在线 RL rollout,根据模型当前表现自动调节任务难度,避免了早期随机探索导致的灾难性失败,让代理从实际轨迹的错误中自我纠正,进而维持长时约束并涌现出鲁棒的跨模态协调行为,为生产环境部署提供了实用路线。
方法
输入
任务由自然语言指令定义,同时提供当前环境状态,包括屏幕截图、UI 树、通知等上下文信息,可跨移动端、桌面、浏览器等多种平台。
关键模块
环境基础设施:构建可弹性扩展的沙箱平台(模拟器/虚拟机),并引入大规模真实设备移动运行时,以收集真实世界分布的数据,解决模拟器与真机的鸿沟。
统一动作空间与批量执行:将 GUI 操作(点击、滑动、文本输入)与 CLI 命令(bash 脚本)融合为统一动作空间,模型单轮即可生成多个动作(最多数十步),减少交互轮次并提升效率。通过统一接口屏蔽不同平台的差异,实现同一代理跨环境工作。
Agent 驱动的数据飞轮:包含知识感知的任务合成、代理自主构建环境与验证器、步骤级细粒度评判用于 SFT、可执行验证用于 RL,以及失败分析驱动的迭代优化,形成自动化数据生产与能力提升的闭环。
三阶段训练:
- SFT 采用滑动窗口处理长轨迹,结合领域条件专家训练保留通用能力;
- Action RL 专门针对高频动作错误模式构造纠偏数据,通过动作级奖励修正重复错误;
- Online RL 利用万级并发环境进行上百步的长程 rollout,配合模型自适应任务课程,学习复杂决策。
Harness 服务层:监听移动端通知,主动触发工作流(如预订、提醒);支持跨设备有状态任务,例如手机触发后由电脑端继续执行。
输出
模型输出批量动作序列(GUI+CLI 混合),执行后可获取新状态并进入下一轮决策,同时 harness 层支持主动发起服务与跨平台任务延续。
与纯 GUI 代理相比,本工作将 CLI 深度纳入动作空间,支持批量动作生成与跨平台有状态执行,并通过真实设备在线学习闭环实现远超模拟器训练的真实场景性能。
实验
实验设计
Qwen-UI-Agent 在 移动端(MobileWorld、MobileWorld-Real、AndroidDaily)、计算机端(OSWorld-Verified、OSWorld-v2)、浏览器端(WebArena)和 GUI 定位(ScreenSpot-Pro)上进行系统评估。移动端引入真实设备基准 MobileWorld-Real,使用 AutoJudge 进行轨迹级自动评分。模型先通过领域条件 SFT 和动作级 RL 训练,再在 10,000+ 并发环境中进行在线 RL,学习长时程决策。
关键发现
- 移动端全面领先:在 MobileWorld 上达 82.1%,MobileWorld-Real 上 92.2%,AndroidDaily 上 97.5%,均创 SOTA,证实真实设备训练的价值。
- 跨平台竞争力:计算机端 OSWorld-Verified 上获 79.5%,与前沿专有模型(Opus 4.8、Gemini 3.1 Pro)相当;浏览器端 WebArena 上 73.6%,接近顶尖水平。
- 在线 RL 带来质变:轨迹长度超 100 轮,模型学会主动使用 CLI 辅助 GUI 操作、维持长时程约束,错误自主恢复能力增强。
基线对比深度
- 移动端:相比仅靠模拟器训练的方法,Qwen-UI-Agent 在真实设备基准 MobileWorld-Real 上大幅领先,证明其真实环境数据飞轮的有效性。
- 计算机端:与 Opus 4.8 等模型竞争时,Qwen-UI-Agent 通过统一的 GUI+CLI 动作空间展现出更灵活的跨应用工作流能力,部分失败案例来自真实设备交互的不确定性(如系统弹窗)。
- 浏览器端:WebArena 结果(73.6%)略低于专有模型最优已报告结果,但考虑到模型主要面向移动端和系统级操作优化,该表现仍具竞争力。整体而言,Qwen-UI-Agent 在保持通用能力的同时,在 GUI 代理任务上达到或超越当前最先进的专有和开源模型。
行业影响
落地场景
Qwen-UI-Agent 作为跨移动端、桌面端、浏览器和深度搜索的基础 GUI 代理,可直接嵌入以下产品与业务:
- 移动设备智能助理:基于通知的主动服务(如行程规划、账单提醒自动处理)和复杂跨应用工作流(如从邮件提取信息并填入表单)。
- RPA 与企业自动化:在客服、金融审核等场景中,结合 GUI 操作与 CLI 执行,完成跨系统数据搬运、报表生成等长尾任务。
- 电商与内容平台:自动化商品上架、竞品监控、多平台价格同步;内容审核流中协同多工具完成截图取证与规则配置。
- 医疗与教育:辅助病历录入、多系统检查结果归集;智慧教室中自动配置软件环境与分发教学材料。
商业价值
- 降本增效:通过批处理动作和在线 RL 对 100+ 轮长轨迹的优化,减少人工在重复性 GUI 操作上的投入,显著降低 RPA 开发和维护成本。
- 体验升级:主动服务触发机制可将被动应用升级为主动助手,提升用户粘性(如自动比价下单、会议记录归档)。
- 新收入渠道:以 API 形式提供“GUI 执行即服务”,赋能中小商家自动化运营,或作为底层能力集成到现有产品中收取许可费。
与现有产品/工作流的接口
Qwen-UI-Agent 提供轻量 Harness 层,可:
- 通过统一接口适配 Android 真实设备、桌面 OS、浏览器沙箱,无需为每种环境构建独立适配器。
- 利用 CLI+GUI 混合动作空间,与现有命令行工具、数据库脚本无缝协作,直接融入 DevOps、数据处理流水线。
- 支持 模型自适应任务课程 和 失败分析驱动的数据飞轮,企业可将自有任务样本注入飞轮,持续提升领域专用性能,无需从头训练。
具体落地 Use Case
- 电商大促自动化:代理监控商家后台通知,自动提取降价信息,跨平台比价并执行补货操作;结合 CLI 调用库存预测脚本,批量更新多店铺 SKU,出错时根据轨迹反馈自动修正。
- 医疗影像中心工作流:代理从 RIS 系统弹窗通知中获取新检查任务,自动登录 PACS 系统检索影像、调用 CLI 脚本进行预处理,再将结果回填至诊断报告界面,全程记录操作轨迹供审计。
局限
- 真实设备经验有限导致鲁棒性不足。尽管 Qwen-UI-Agent 部署了大规模真实设备移动运行时,但其行为分析显示在界面延迟、网络波动等现实噪声下仍出现执行失败(Real-world Scenario Challenges)。作者指出模型对真实设备交互的暴露量仍不足以覆盖所有动态变化,限制了在非受控生产环境中的即用性。
- 训练资源需求庞大,复现门槛高。系统依赖超过 10,000 个并发环境进行在线 RL rollout,并需要持续的任务‑验证器合成与奖励设计。这种规模的算力与工程维护开销对多数研究团队及中小企业难以承受,不利于开源社区的二次开发与验证。
- 批量动作生成可能牺牲反应性。Qwen-UI-Agent 允许在单次模型调用中输出多个动作(batched actions),虽然提升了效率,但在动态 UI 场景下容易忽略中间状态的反馈,导致动作链偏离实际界面演变。尽管在线 RL 可进行轨迹级校正,但该设计理念上放弃了一部分闭环交互的鲁棒性。