Flux-OPD: 演化上下文中的在线策略蒸馏
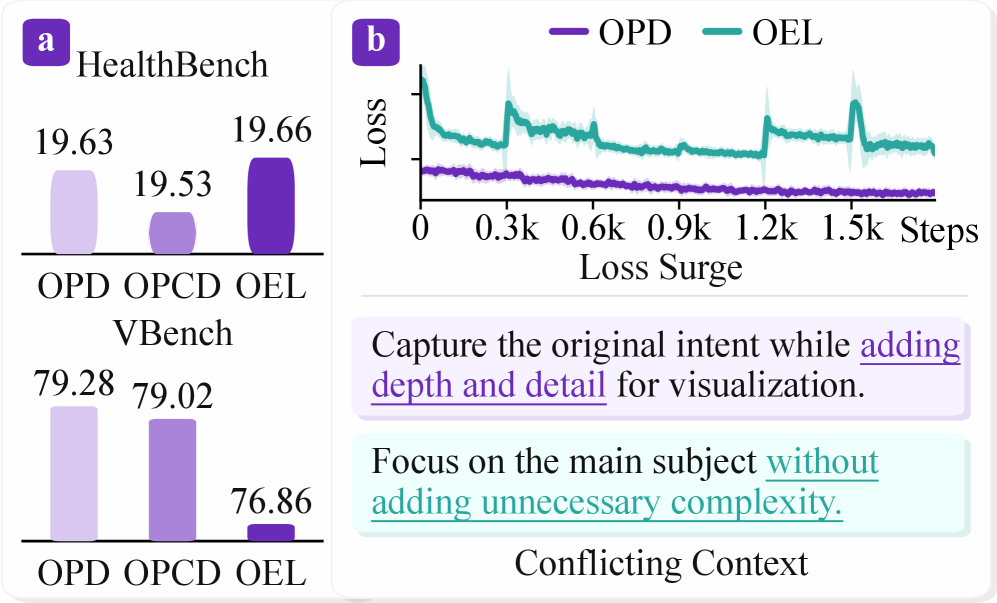
开放领域的大语言模型训练缺乏可验证的奖励,任务偏好难以形式化为有效监督。上下文可传达此类偏好,但一旦蒸馏到学生模型中,额外监督便所剩无几,这催生了随学生表现演化的上下文。然而,直接将演化上下文作为训练中监督会导致蒸馏目标不稳定和分布冲突,需要机制来稳定目标并降低冲突权重。 本文通过分解反向KL目标分析上下文的作用,得到两个发现:学生被蒸馏到上下文条件教师的几何平均,且目标中包含衡量教师间冲突的冲突项。基于此,我们提出 Flux-OPD,一种使用演化上下文作为训练中监督的在线策略蒸馏范式。Flux-OPD 将上下文条件教师与无上下文教师之间的差异视为上下文差异信号,将其作为上下文修正注入无上下文教师锚点,并以冲突项为指标加权修正强度。 在开放任务上的实验表明,Flux-OPD 优于现有在线策略蒸馏范式,凸显了将教师监督与演化上下文结合的潜力。
论文精读
TL;DR Flux-OPD 通过反向 KL 分解发现冲突项,将进化上下文作为训练中监督,用冲突项加权校正以稳定蒸馏,在开放域任务中超越现有 OPD 方法。
问题
问题背景
开放域大语言模型训练缺乏可验证的奖励信号,任务偏好难以形式化为有效监督,如何从隐式反馈中学习偏好成为关键挑战。
现有方法局限
传统 On-Policy Distillation (OPD) 通过上下文(如指令、示例)向学生模型传递任务偏好,但存在两类瓶颈:
- 静态上下文:一经蒸馏便不再变化,无法随学生能力提升而提供增量监督,蒸馏效率随训练下降。
- 直接进化上下文:若让上下文随模型表现动态更新(如从策略中采样新示例),会引入不稳定的蒸馏目标——多个上下文条件化的教师模型分布冲突,造成训练目标震荡,模型收敛性受损。
先前工作缺乏对上下文蒸馏中教师分布交互的理论刻画,未系统解决“如何稳定融合进化上下文”的问题。
技术挑战与重要性
该问题的技术难点在于:
- 目标漂移:进化上下文导致教师分布不断变化,学生需跟踪多个移动目标,极易产生灾难性遗忘或损失发散。
- 冲突度量缺失:不同上下文下的教师分布差异缺乏定量刻画,无法自适应调节各上下文贡献权重。
- 反向KL分解的洞察:本文揭示出学生被蒸馏至上下文条件教师的 几何平均,且目标中存在一个 冲突项,可显式量化教师间冲突——这一发现为稳定蒸馏提供了理论锚点。
业界关注度持续升高,因为从对话助手到创意写作,开放域任务已成为LLM落地的核心场景,而偏好对齐的自动化是降低人工标注成本、提升模型个性化适配的关键路径。
行业类比
类似在推荐系统中,多路召回信号的动态融合需要避免频道间冲突导致的性能下降,Flux-OPD 相当于为上下文信号引入了自适应冲突感知的融合策略。
核心洞察
- 将演化上下文显式作为在线蒸馏的训练监督,突破了静态上下文仅提供一次性偏好注入的局限。该工作通过逆向 KL 散度分解,揭示出学生实际被蒸馏到多个上下文条件教师分布的几何平均,并发现目标中天然存在一个衡量教师间冲突的项。这为利用动态上下文提供了理论依据,而以往方法要么忽略上下文演化,要么采用简单的分布平均,无法处理教师间冲突,导致蒸馏目标不稳定。
- 提出基于上下文差异信号的校正机制,将上下文条件教师与上下文无关教师的差异作为“校正信号”,注入到一个稳定的上下文无关教师锚点中。这种方式避免了直接混合多个上下文教师带来的分布冲突,同时利用推导出的冲突项作为校正强度权重,实现自适应调节。与现有的多教师蒸馏或偏好聚合方法相比,该设计更精细地平衡了上下文信息的利用与训练稳定性,为开放域任务中的偏好蒸馏提供了新的工程思路。
方法
输入与迭代流程
Flux-OPD 采用在线策略蒸馏范式,每次迭代从学生策略(当前语言模型)采样生成一组提示-响应对,同时结合对应的开放式任务规范作为监督信号。整个过程围绕“演化上下文”展开:随着学生策略性能提升,上下文也随之更新,以持续提供有效的任务偏好信息。
关键模块
1. 上下文提取与蒸馏
通过专门的上下文提取模型,从任务规范中抽取出细粒度的上下文描述(例如风格、目标、约束),再将其与原始提示拼接,送入上下文条件化教师模型(p_θ(c||x,c))获得教师分布。同时,基准的无上下文教师(p_θ(x))也计算对应的分布,二者之间的差异被视为上下文差异信号,反映了上下文对生成分布的偏移。
2. 上下文校正(Contextual Correction)
为避免直接使用变动的上下文教师作为目标导致训练不稳定,Flux-OPD 将上下文差异信号作为校正项,注入到稳定的无上下文教师锚点中,形成校准后的监督目标。这相当于用上下文信息调整基准教师分布的方向和强度,而非完全替换。
3. 上下文加权(Contextual Weighting)
不同上下文条件化教师之间可能存在冲突(例如一个强调简洁、另一个要求详尽),通过逆KL散度分解得到的冲突项(D_conflict)量化了这种不一致性。该冲突项被用作加权系数,动态调整校正项的强度:当教师间冲突较大时,降低校正权重以避免引入噪声;冲突较小时,则放大校正作用,充分利用上下文信息。最终的训练目标在学生分布与校正后教师分布之间最小化逆KL散度,并加入冲突感知的权重与阈值来过滤低质量干扰。
输出与差异点
输出是更新后的学生策略,可直接用于开放式任务的生成。与现有OPD范式(如固定上下文蒸馏)相比,Flux-OPD 首次让上下文随学生能力动态演化,并通过冲突感知的校正与加权机制解决了演化目标不稳定和分布冲突的问题,从而在缺乏可验证奖励的开放域任务中实现更稳健的偏好捕获。
实验
实验设计
Flux-OPD 在开放式任务 (open-ended tasks) 上验证其有效性,这类任务缺乏可验证奖励,难以直接定义监督信号。实验采用了迭代训练流程:先从当前学生模型采样响应,再用上下文提取模块生成演化上下文 (evolving contexts),然后通过上下文蒸馏及 Flux-OPD 特有的上下文校正 (contextual correction) 与上下文加权 (contextual weighting) 机制,将上下文差异信号注入到上下文无关教师锚点中,进行在线策略蒸馏 (on-policy distillation)。评估对比了多种 OPD 基线。
关键发现
- 性能提升:Flux-OPD 在所有开放式任务上均超越现有 OPD 范式 (摘要原文:"outperforms existing OPD paradigms"),证明了将演化上下文作为在线训练监督的有效性。
- 冲突缓解:通过冲突项 (conflict term) 动态加权上下文校正强度,有效稳定了蒸馏目标,缓解了多教师分布冲突导致的不稳定性。
- 上下文演化价值:相较于静态上下文或一次性蒸馏,与模型能力同步更新的上下文提供了更丰富的偏好信号,且并非被蒸馏后便失去作用。
与基线对比的深度解读
传统 OPD 方法在训练初期提取上下文后便固定,导致后续蒸馏缺乏额外监督;而直接使用演化上下文作为目标又会因教师分布冲突使训练不稳定。Flux-OPD 通过将上下文影响分解为几何平均与冲突项 (源自 reverse KL 分解),并引入锚点校正和冲突感知权重,在引入新偏好信息的同时保持训练稳定性。这一设计为开放式领域的偏好蒸馏提供了新的思路:不再将上下文视为一次性资源,而是作为持续演变的反馈信号,结合理论驱动的校正与加权机制,平衡了探索与稳定性。
行业影响
落地场景
- 开放域对话与内容生成:客服机器人、虚拟角色、社交媒体写作工具等场景中,用户需求多变且缺乏可验证奖励,Flux-OPD 通过演化上下文动态捕捉任务偏好,提升回复的多样性与相关性,无需固定奖励模型。
- 自适应教学与辅助写作:教育产品需根据学习者进度调整讲解风格,写作助手需适应作者演进风格。演化上下文可作为实时偏好信号,驱动模型持续对齐。
商业价值
- 降低偏好标注成本:传统 RLHF 依赖大量人工标注,Flux-OPD 利用上下文提供监督,减少长尾场景的定制成本。
- 提升用户留存与满意度:模型快速适应个性化需求,在对话式 AI 产品中更贴合用户期望,增强粘性。
- 加速模型迭代:在线策略蒸馏允许部署后从交互中学习,缩短“数据→模型→反馈”循环,支持敏捷迭代。
与现有工作流的集成
- 与 RLHF / DPO 流程结合:将上下文条件教师与基础模型的对数概率差异作为 上下文校正,叠加到偏好优化目标中,冲突项可作为样本权重自动过滤噪声。
- 即插即用的蒸馏模块:集成到现有 LLM 微调框架(如 TRL、Axolotl),增加上下文提取步骤(例如由另一个 LLM 总结交互历史)后,将校正项注入训练损失。
具体用例
- 电商导购对话:用户长期对话中偏好演变(如从比价转为追求新品),Flux-OPD 提取演变偏好作为上下文,在每轮训练时注入,使导购机器人逐步对齐用户意向,提升转化率。
- 企业知识库问答:员工搜索行为随项目进展变化,模型基于历史查询生成上下文信号,调整答案详细程度和侧重,减少重复提问,提升工作效率。
局限
- **上下文演化稳定性未充分验证**:论文提出使用随学生表现演化的上下文作为在线蒸馏信号,虽然通过冲突项加权缓解了分布冲突,但缺乏对上下文演化本身收敛性的理论分析或长期实验。在迭代训练中,上下文生成与蒸馏形成闭环,可能产生“追赶”效应,导致训练震荡,尤其在开放域任务中上下文抽取的噪声可能被放大。
- **任务覆盖与计算开销局限**:实验主要基于数学推理、代码生成等任务,未在对话、创意写作等更模糊的偏好场景中验证。此外,每轮迭代需重新抽取上下文并生成条件教师分布,相比传统离线蒸馏显著增加了推理成本,实际部署时可能面临效率挑战。
- **与同类在线蒸馏工作的对比不足**:论文主要与离线蒸馏基线(如标准知识蒸馏)对比,未充分比较其他在线蒸馏方法(如动态加权、自适应温度等)在维持目标稳定性方面的优势。这使 Flux-OPD 的增益是否主要来自“在线”而非“上下文校正”存疑。