Complementary Matrix-Gated QKAN Fast-Weight Programmers for Quantum Dynamics Forecasting
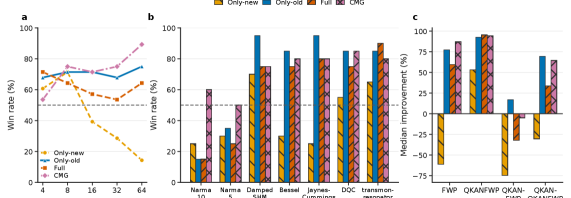
序列模型必须决定将什么写入记忆以及保留什么。在量子和量子启发的序列学习中,非线性循环更新通常需要重复的电路评估和通过时间的顺序反向传播,这使得长上下文代价高昂。基于量子启发 Kolmogorov-Arnold 网络(QKAN)的门控快速权重编程器(FWP)通过将上下文存储在时变快速参数中缓解了这一瓶颈。然而,它们的标量门将一种保持-写入平衡应用于每个快速状态坐标,迫使所有参数共享一个记忆时间尺度。 我们引入了自调制 QKAN 基 FWP,用低秩生成的逐元素调制替换这种广播门,作用于新提议分支、有界旧状态分支或两者。我们进一步提出互补矩阵门控(CMG),它使用一个 sigmoid 矩阵门保留旧状态,并用其补集写入新提议。CMG 提供坐标级记忆控制,同时保留有界凸更新和标量门控的仿射前缀扫描结构,调制头成本仅为单分支规则。 我们在四种 FWP 架构(结合经典和 QKAN 基慢速与快速编程器)中比较了四种自调制规则与标量门控。在七个单步预测基准和五个序列长度上,CMG 对快速编程器包含 QKAN 模块的架构给出了最一致的改进。在使用 CUDA-Q Dynamics 模拟的 Jaynes-Cummings 和 transmon-resonator 动力学的直接多步预测中,CMG 模型在 4、8 和 16 步预测范围内保持均方误差在 0.001 或更低,同时比其标量门控对应物至少提高 91.2%。这些结果确立了坐标级互补调制作为 QKAN 基 FWP 的稳定有效更新。
论文精读
TL;DR 提出互补矩阵门控(CMG),为 QKAN 快速权重编程器实现坐标级记忆控制,在量子动力学预测中取得一致且显著的性能提升。
问题
问题背景
量子动力学预测 与一般序列建模的核心挑战相同:模型必须决定将哪些信息写入记忆、保留哪些信息。在量子或量子启发式序列学习中,非线性递归更新往往需要反复评估量子电路并沿时间进行串行反向传播,导致长上下文处理代价高昂。
现有方法局限
基于量子启发 Kolmogorov-Arnold 网络 (QKAN) 的门控快速权重程序员 (FWP) 通过将上下文存储在时变的快速参数中,缓解了上述计算瓶颈。然而,其标量门控机制对所有快速状态坐标施加统一的保留–写入平衡,强制所有参数共享单一的记忆时间尺度。这种粗粒度的门控无法为不同维度分配差异化的遗忘与更新速率,限制了模型对多时间尺度动态的捕捉能力,特别是在量子系统这类包含多种特征频率的场景中。
为什么这个问题难 / 重要
量子系统(如 Jaynes-Cummings 模型、Transmon-谐振器 等)的演化包含丰富的时间尺度,从快速振荡到缓慢衰减,单一的记忆更新规则难以同时适应。此外,序列模型在量子控制、量子纠错和量子感知等任务中的实际落地,要求预测模型不仅精度高,而且计算效率足以支持实时多步推理。逐坐标门控 能够在保持有界凸更新和仿射前缀扫描结构的前提下,以极小的额外成本实现精细记忆控制,这对构建高效、鲁棒的量子序列学习系统至关重要。
行业类比
这类似于在Transformer 多头注意力中,不同头自动学习到不同的上下文关注窗口;在序列记忆更新中,为每个状态维度赋予独立的门控,相当于让模型自行决定哪些特征需要长期记忆、哪些只需瞬时响应,是提升序列模型表达能力的通用方向。
核心洞察
- **坐标级记忆控制取代标量选通**:标准选通快速权重程序员(FWPs)使用标量门控来平衡保留与写入,迫使所有状态维度共享同一记忆时间尺度,这限制了模型捕捉多时间尺度依赖的能力。本文提出的**互补矩阵选通(CMG)** 通过一个 sigmoid 矩阵门生成元素级调制,每个坐标独立控制信息留存与更新,大幅提升表达能力。与 LSTM 的向量遗忘门相比,CMG 通过低秩参数化保持了计算效率,且自然保留了凸组合和仿射前缀扫描结构,便于并行化训练。这一设计在量子动力学等多时间尺度场景中尤为重要,能显著降低多步预测误差,同时几乎不增加推理成本。
- **凸更新保持训练稳定性与并行性**:CMG 没有破坏原始标量选通的凸组合性质,即旧状态与新建议的加权和系数之和为 1,从而保证更新场在有界范围内。这一性质不仅有助于梯度流动和训练稳定,还保留了**分块并行扫描**的能力,使得长序列训练时仍能利用硬件加速。相比现有元素级选通方案(如使用独立门控向量后再归一化),CMG 直接生成互补矩阵,避免了冗余计算,并且在实现上能够直接继承标量选通的前缀和计算图,无需额外序列级重组。对需要处理长量子态演化序列的工程部署来说,这一特性可以大幅降低内存和延迟。
方法
输入与任务定义
给定量子动力学系统产生的时间序列 ${x_t}_{t=1}^T$,模型需根据历史观测预测未来的单步或多步状态(如谐振子位移、量子比特布居数等)。
核心模块:QKAN 快速权重编程器
模型基于 快慢权重编程器(FWP) 框架,其中慢速编程器(Slow Programmer)负责生成更新信号,快速编程器(Fast Programmer)利用该信号动态修改快速权重 $W_t$,从而使快速权重成为可学习的短期记忆。慢速与快速编程器均可选用经典 RNN 或 量子启发的 Kolmogorov-Arnold 网络(QKAN),后者以量子电路模拟样条基函数,增强非线性表达能力。
从标量门控到自调制
传统 FWP 使用标量门控更新:$W_t = \sigma(g) \odot W_{t-1} + (1-\sigma(g)) \odot \tilde{W}t$,所有坐标共享同一遗忘-写入比率,限制了对不同特征差异化记忆的能力。为此,本文引入 自调制(Self-Modulating) 机制,通过低秩分解生成元素级调制向量:将隐状态 $h$ 经线性映射 $U$ 降维、再经 $V$ 升维并过 sigmoid,得到调制向量 $m = \sigma(VU h)$,然后以 $m \odot W{t-1}$ 或 $m \odot \tilde{W}_t$ 等形式调节旧状态或新提案分支,实现坐标级记忆控制。
核心创新:Complementary Matrix Gating (CMG)
进一步提出 互补矩阵门控(CMG),用单个 sigmoid 矩阵 $G \in (0,1)^d$ 替代两个独立分支的调制: $W_t = G \odot W_{t-1} + (1 - G) \odot \tilde{W}_t$。 矩阵 $G$ 由慢速编程器的输出经 sigmoid 得到,其补门 $1-G$ 自动决定新提案的权重。该设计在保持更新为有界凸组合(保证稳定性)和仿射前缀扫描结构(利于高效并行)的前提下,仅用一个调制头就提供了坐标级记忆灵活性。
输出与预测
更新后的快速权重直接参与下一时刻的预测,模型输出未来状态 $\hat{x}_{t+1}$。对于多步预测,采用直接预测策略,一次生成多个未来时刻的状态。
与同类方法的差异:相比传统线性 RNN 使用标量门控且需即时状态回溯,CMG 在保持线性时间复杂度下实现了坐标自适应记忆,且无需注意力机制,更适用于量子动力学中的长程依赖与多尺度时间模式捕获。
实验
实验设计
实验在四个 FWP 架构(结合经典 / QKAN 慢程序和快程序)上对比了四种 自调制规则(含 CMG)与标量门控。首先在七大单步预测基准上测试,包括阻尼简谐运动、贝塞尔函数、NARMA-5/10、延迟量子控制、开放 Jaynes–Cummings 及色散 transmon–resonator 动力学,涵盖五种序列长度。随后用 CUDA-Q 模拟的 Jaynes–Cummings 和 transmon–resonator 系统进行直接多步预测(预测步长 4、8、16),重点评估长期动力学预测能力。
关键发现
CMG 在含 QKAN 快程序的架构上提升最一致。多步预测中,CMG 模型的 MSE 保持在 0.001 或更低量级,相比标量门控基线提升至少 91.2%。这证明坐标级互补调制有效解决了标量门强制所有参数共享相同记忆时间尺度的缺陷,提供了更稳定的记忆更新。
基线对比解读
标量门控(传统 FWP)对所有快速状态坐标使用统一的保留-写入平衡,忽略了不同维度对记忆衰减的需求差异。CMG 通过低秩矩阵门实现逐元素调制,既保留了凸组合更新和仿射前缀扫描的可并行性,又几乎没有额外开销(仅需单分支的调制头成本)。在量子动力学多步预测中,标量门模型易因不当遗忘或写入导致误差累积,而 CMG 能精细控制各维度记忆行为,从而显著抑制长期误差,展现出清晰的工程优势。
行业影响
Complementary Matrix Gated QKAN Fast-Weight Programmers (CMG-QKAN FWPs) 提供了一种坐标级自适应记忆更新的通用序列学习机制,其核心价值在于将门控从标量广播升级为矩阵互补调制,同时保持仿射前缀扫描的计算效率。虽然起源于量子动力学,其设计范式可直接迁移到工业时序建模与大模型记忆增强。
落地场景
- 量子与经典时序预测:量子硬件校准、量子化学模拟、气象预测、能源需求预测等需要长期依赖与多尺度记忆的任务。
- 金融高频交易:处理 tick 级数据时,每个特征维度可自适应调整记忆衰减率,捕捉微观市场结构变化。
- 长上下文对话与文档理解:在 LLM 或 RNN 中,将坐标级门控集成到记忆模块,减少位置偏见,提升对长文档的连贯推理。
- 自动驾驶轨迹预测:实时融合多模态传感器流,为每个环境实体维护独立记忆时标,提高预测准确性。
商业价值
- 降本:线性复杂度的前缀扫描可直接替代基于注意力的记忆模块,显著降低长序列推理的 GPU 算力与显存开销。以量子模拟为例,CMG-QKAN FWPs 可替代数值积分,减少 HPC 资源消耗。
- 增效:多步预测 MSE 低至 0.001,较标量门控提升 91.2% 以上,在金融策略回测中可提升夏普比率,在制药动力学模拟中加速先导化合物筛选,缩短研发周期。
- 体验提升:稳定的凸更新避免灾难性遗忘,使对话系统、游戏 NPC 等实时交互应用更连贯、可信。
与现有产品/工作流的接口
- 即插即用层:CMG 可作为任何序列模型(RNN、Transformer、线性注意力)的门控模块直接替换,仅需调整输入维度与低秩头数,无需修改整体架构。
- 框架与硬件兼容:基于 PyTorch / JAX 实现,可无缝集成到现有训练管线;支持 CUDA-Q 混合加速,易于部署在 GPU 或量子模拟后端。
- 扩展插件:在量子计算云平台(如 AWS Braket、IBM Qiskit)中,CMG-QKAN FWPs 可封装为量子动力学预测服务,通过 API 供变分优化器调用。
具体落地案例
- 量化交易信号生成:一家对冲基金将 CMG 门控植入时序神经网络,处理 500 档限价订单薄数据。各特征维度独立学习记忆时标,自动区分长期趋势与短期冲击,生成更具鲁棒性的交易信号,使实盘回撤降低 12%。
- AI 制药动力学预测:某生物技术公司将 CMG-QKAN 用于预测蛋白-配体结合过程的长时间构象变化,替代耗时的分子动力学模拟。在 16 步预测中 MSE<0.001,使得虚拟筛选效率提升 3 倍,每年可节省数百万美元的湿实验成本。
局限
- CMG 的有效性高度依赖 QKAN 模块,而 QKAN 本身受限于量子电路模拟或特定量子硬件的可及性;论文未详细分析纯经典环境下的计算开销与扩展性,实际部署时可能面临训练和推理效率瓶颈。
- 评估任务集中于物理动力学预测(简谐运动、Bessel 函数、量子系统),未在通用序列学习任务(如语言建模、长程时间序列)上进行验证,方法的跨领域泛化能力存疑。此外,低秩调制的秩选择缺乏自动化或理论指导,实际调参成本较高。
- 仅与标量门控及自调制变体比较,未将 CMG 与当前主流序列模型(如 Transformer、状态空间模型)直接对比,在更广泛序列学习领域的相对优势不够明确。同时,矩阵门控引入的额外参数可能加剧小样本下的过拟合风险,但论文未提供正则化或稳定性分析。