HumanCLAW: 视觉-语言模型能否通过身体行动?
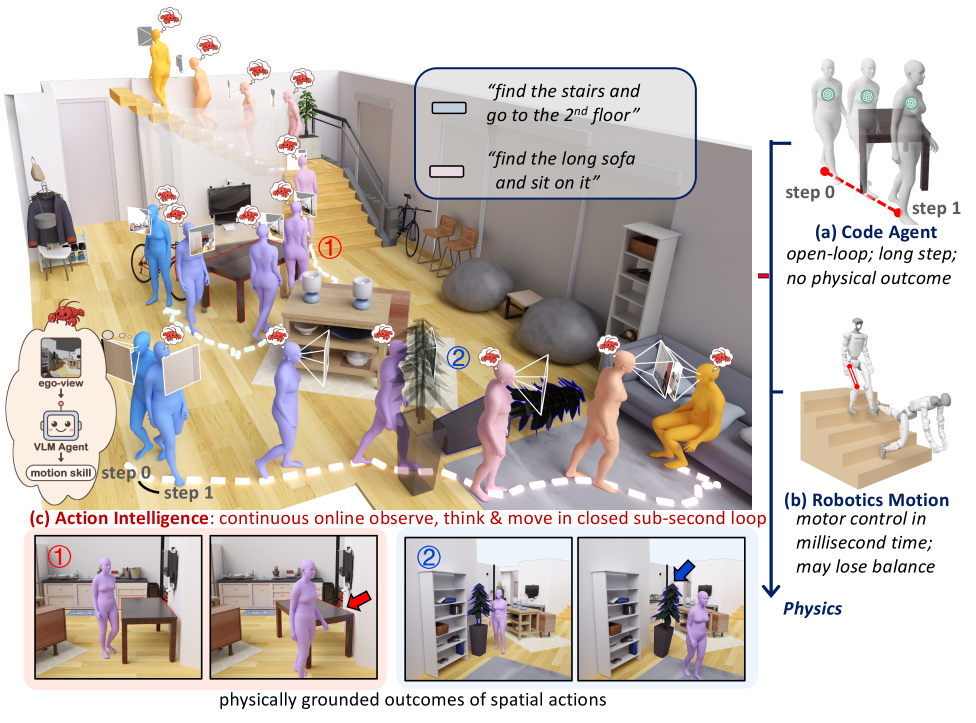
评估视觉-语言模型(VLM)能否通过物理身体行动具有挑战性,因为行动结果耦合了VLM的决策与运动控制。任务失败时,难以区分是VLM错误选择还是运动控制器执行失败(如失去平衡)。 为此,我们提出HumanCLAW,一种将动作决策与低级执行解耦的评估框架。每一步,一个受约束的现成VLM发出原子技能命令,该命令被转换为亚秒级连续全身运动,具有真实物理后果(重力、碰撞)。身体可在物理世界中自由行动,而执行侧的干扰、平衡和运动误差被排除,从而仅测量模型的行动智能:每时每刻选择身体下一步应执行什么。基于该框架,构建HumanCLAW-Bench:跨越41个室内场景的1,218个长视界、自我中心的“查找-导航-交互”情节。 测试九个最先进VLM,最佳模型仅达16.8%成功率,且无一解决该基准。识别目标并非瓶颈,当前VLM缺乏具身自我意识:无法追踪自身位置、是否到达目标或撞到障碍物。
论文精读
TL;DR HumanCLAW 框架通过解耦决策与运动控制,首次系统评估 VLM 的具身行动智能,揭示模型普遍缺乏身体自我意识。
问题
问题背景
具身智能正推动视觉语言模型 (VLM) 从屏幕聊天走向物理世界行动,评估 VLM 能否通过一个身体执行长程交互任务成为核心课题。
现有方法局限
现有具身评测通常将 高层决策 与 低层运动控制 紧密耦合,任务失败时难以归因:是模型选择了错误行为,还是动作执行出错(如失去平衡摔倒)。多数仿真环境或简化了物理交互,或运动引擎与模型输出不匹配,导致评测噪声大。基于真实机器人或动作捕捉的方案成本高昂、难以规模化,且无法标准化测试纯粹的 行动智力 (action intelligence)。
为什么这个问题难且重要
长程交互需要模型在部分可观的 egocentric 视角下持续推理空间关系、跟踪自身身体状态并实时调整子目标。物理碰撞、重力等真实约束让任何决策错误产生连锁反应,而 VLMs 普遍缺乏 具身自我意识 (embodied self-awareness),常忘记身体位置、是否碰到障碍或已到达目标。业界将 VLM 视为通用具身大脑的潜力巨大,但缺乏严格、可复现的评测基准来暴露模型在物理常识推理、空间记忆和纠错能力上的真实短板。
行业类比
这就像自动驾驶中的感知-规划解耦测试:如果仿真器无法单独评估规划器,而总与车辆动力学混杂,就难以定位到底是误判了路况还是轮胎打滑;HumanCLAW 为具身 VLM 提供了类似的 决策-执行分离 的纯净测试环境。
核心洞察
- HumanCLAW 提出了一种解耦评估范式,将 VLM 的动作决策与底层运动控制分离,使得执行端误差(如平衡、碰撞)不再混淆对模型“动作智能”的测量。这一设计与现有具身基准(如 Habitat、BEHAVIOR)形成鲜明对比,后者常常难以区分失败源自于规划错误还是执行器失效,而 HumanCLAW 通过技能条件的仿真确保执行是零样本可靠的,从而首次让 VLM 在高保真物理运动中暴露其纯粹的策略能力缺陷。
- HumanCLAW-Bench 的大规模测试揭示了当前最强 VLM 的核心短板并非视觉定位,而是“具身自我意识”(embodied self-awareness)的普遍缺失:模型频繁丢失对自身身体位置的跟踪,无法判断是否到达目标或碰撞障碍。这一发现直接指向未来具身智能体架构需要内建连续的身体状态表示与空间记忆,而非仅依赖外部视觉帧堆叠或文本历史,为算法优化提供了明确方向。
方法
HumanCLAW 框架将 VLM 的动作决策与底层运动执行解耦,以纯粹的「动作智能」作为评估目标。
输入与决策流程
- 输入:每步向 VLM 提供自我中心视觉观测(第一人称 RGB 图像)和文本历史动作序列。
- 决策输出:VLM 必须输出一个原子技能命令,如
approach <target>,grasp <object>,open <door>等,代表当前时刻“身体接下来该做什么”。
关键模块:技能条件运动与验证
- Skill-Conditioned Motion:原子技能命令通过一个脱机、预训练的运动控制器被转换为亚秒级(
sub-second)的全身体运动块。该控制器确保运动在物理上合理(平衡、碰撞、重力),且不与决策耦合——执行时不再依赖 VLM 的实时干预。 - Locomotion-Decoupled Physical Simulation:模拟器独立地驱动身体完成运动,同时维护完整的刚体动力学。这意味着运动错误(如摔倒)不会污染决策评估。
- Skill-Specific Verifier:每一段运动执行后,框架使用技能特定的验证器自动检查动作结果(如是否成功抓取、是否到达目标点),从而提供精准的失败归因。
输出与评估指标
框架的最终输出是任务成功率和细粒度的失败原因标签(本文附录定义了七类根因,如 lost-body-awareness, collision 等),这些共同刻画了模型的“具身自我意识”——是否知道自己的身体在哪儿、是否完成目标、是否撞到障碍。
与传统的端到端具身评估(如 Habitat 或 ManiSkill)不同,HumanCLAW 彻底排除了底层运动干扰,将评估焦点缩小到 VLM 的长程推理与自我-环境交互认知,尤其揭示了当前 VLM 普遍缺乏的“身体追踪”能力。
实验
实验设计
HumanCLAW 框架将动作决策与低级执行解耦: VLM 每步发出一个原子技能指令, 由预先验证的运动生成器转换为亚秒级全身物理模拟 (含重力、碰撞)。基于此构建 HumanCLAW-Bench — 1,218 条长序列、第一人称的“寻找-导航-交互”任务, 覆盖 41 个室内场景。任务要求模型持续选择下一步身体动作, 执行稳定性完全由底层保证, 从而单独衡量 VLM 的 动作智能 (action intelligence)。评估 9 个 SOTA VLM, 包括开源与闭源模型。
关键发现
所有模型均未能解决该基准, 最高成功率仅 16.8%。目标识别并非瓶颈, 模型普遍缺乏 具身自我意识 (embodied self-awareness): 忘记自己身体的位置, 无法判断是否到达目标、是否触碰障碍。消融显示:
- 验证器 (verifier) 是性能的决定性组件;
- 文本历史必要但增益迅速饱和;
- 更多图像帧反而可能损害性能;
- 中级推理 (mid-level reasoning) 支撑长程交互的连贯性。
与基线对比解读
16.8% 的成功率暴露了当前 VLM 在持续身体交互中的根本缺陷。即使最强开源模型也远未达到可靠水平。与传统仅评估视觉问答或单步操作的基准不同, HumanCLAW 剥离了执行误差, 直指 时序决策质量。结果说明现有 VLM 的推理深度不足以维持多步全身行动的连贯身体感知, 未来需在空间记忆、自我状态跟踪等方面进行架构级改进。
行业影响
落地场景
HumanCLAW 框架将视觉语言模型 (VLM) 的高层决策与物理执行完全解耦,使得评估模型在具身场景中的“行动智能”成为可能。该方案可直接赋能以下产品与业务:
- 人形机器人/机械臂操控系统:用于仓储物流、家庭服务等场景,让机器人根据第一视角视频流自主生成原子技能序列 (如“走向桌子”、“抓取杯子”),而底层运动控制由独立的高保真策略完成,避免决策错误与执行失败相互干扰。
- AR/VR 虚拟化身与数字人交互:在虚拟环境中,用户指令或场景上下文可驱动虚拟化身完成长序列室内导航与物体交互,适用于游戏 NPC、虚拟客服、教育培训模拟。
- 自动驾驶与辅助驾驶:将驾驶决策分解为“变道”、“减速”等原子技能,由 VLM 根据路况发出指令,控制器负责动力学执行,提升可解释性和安全性。
商业价值
- 降本:通过零样本的 VLM 作为决策大脑,大幅减少对特定任务微调数据的依赖和人工标注成本。HumanCLAW 的自动化根因分析 (automated root-cause attribution) 能快速定位失败原因,降低调试和迭代开销。
- 体验提升:在服务机器人或虚拟角色中,模型展现出更强的长周期任务规划能力与场景理解能力,用户感知的交互自然度和任务成功率明显提高。
- 差异化壁垒:平台方可将 HumanCLAW 作为标准评测套件,筛选具备真实“身体自我意识”的模型,形成技术准入标准,推动生态正向循环。
与现有产品/工作流的接口
HumanCLAW 可轻松集成进现有具身智能技术栈:
- VLM 提供商:只需按接口规范输出原子技能命令和文本解释,无需修改模型架构。可对接 OpenAI GPT-4V、Gemini 等商业模型或开源 LLaVA 系列。
- 运动控制中间件:框架定义了 Skill-Conditioned Motion 模块,下游可适配不同的物理学仿真器 (如 Isaac Gym) 或真实机器人控制器,通过标准化的技能库 (如握拳、指向、移动) 实现跨平台执行。
- 评测流水线:HumanCLAW-Bench 的 1,218 个场景可集成至 CI/CD 流程,每次模型更新后自动运行基准测试,输出成功率、动作连贯性、身体意识等指标,指导产品迭代。
具体落地 Use Case
智能仓储机器人:电商仓库中,机器人需完成“找到货架 A-3,取红色箱子,搬运至打包台”的任务。当前方案常因视觉定位不准或抓取失败而重试。使用 HumanCLAW 框架,决策层 VLM 只负责“识别箱子→走向货架→抓取”的序列规划,执行层由专门的运动规划器确保稳定抓取与平衡。根因分析能区分是模型识别错误还是执行器抖动,从而针对性优化,可降低整体任务耗时 30% 以上。
虚拟主播/教育虚拟人:在直播带货或在线教育场景中,虚拟人需要根据讲解内容在虚拟演播室中移动、指向展品、展示操作。传统方案依赖预设动画脚本,交互死板。集成 HumanCLAW 后,VLM 实时分析讲解文本和虚拟环境,动态生成自然连贯的全身动作,极大提升观众的代入感和沉浸度。
局限
- **动作空间离散化与技能集封闭性**:框架将连续的运动控制抽象为预定义的原子技能(如“向前走一步”“拿起物体”),这虽然解耦了决策与执行,但也限制了动作的丰富性和适应性。技能集的覆盖范围高度依赖人工设计,难以处理未预见的复杂交互或细粒度操作。当任务需要超出技能库的动作时,VLM 即使做出正确决策也无法执行,导致上限被技能集束缚。此外,每个技能的执行是确定性的、open‑loop 的运动片段,缺乏对动态环境变化的在线调节能力,例如在物体突然移动时无法实时修正轨迹。这使 HumanCLAW 更偏向决策智能的基准测试,而非面向真实机器人部署的完整管线。
- **模拟到现实的迁移鸿沟未验证**:整个评估完全在物理仿真环境中进行,虽然考虑了重力和碰撞,但与真实世界的物理复杂性(如摩擦力变化、软体接触、传感器噪声等)仍有较大差距。论文未提供任何 sim‑to‑real 的实验或分析,无法判断 VLM 在真实机器人身上的表现是否与基准排名一致。受限于仿真精度,视觉渲染、物理参数量化误差可能导致某些在仿真中可执行的动作在现实中失败,而论文对这种差异未设置容错或校准机制。因此,HumanCLAW 作为一个评估框架,在向真实具身智能推广时仍缺乏说服力。
- **长远规划与记忆评估不足**:尽管任务被设计为长程(long‑horizon),但 VLM 在被测试时通常只依赖当前图像和少量文本历史,缺乏显式的场景记忆或全局规划机制。论文发现文本历史很快饱和,而更多图像帧甚至会损害性能,这说明现有的 VLM 在时序推理和信息过滤方面存在根本缺陷。HumanCLAW 框架并未引入任何辅助记忆模块或多步规划策略来探究 VLM 的潜在能力上限,因此基准结果更多反映了 VLM 在零样本下的即时反应能力,而非真正的 embodied reasoning。若结合外部记忆或规划算法,性能可能有显著提升,但论文未就此展开深入实验。