MindForge: 通过无源码程序合成教小语言模型全生命周期软件工程
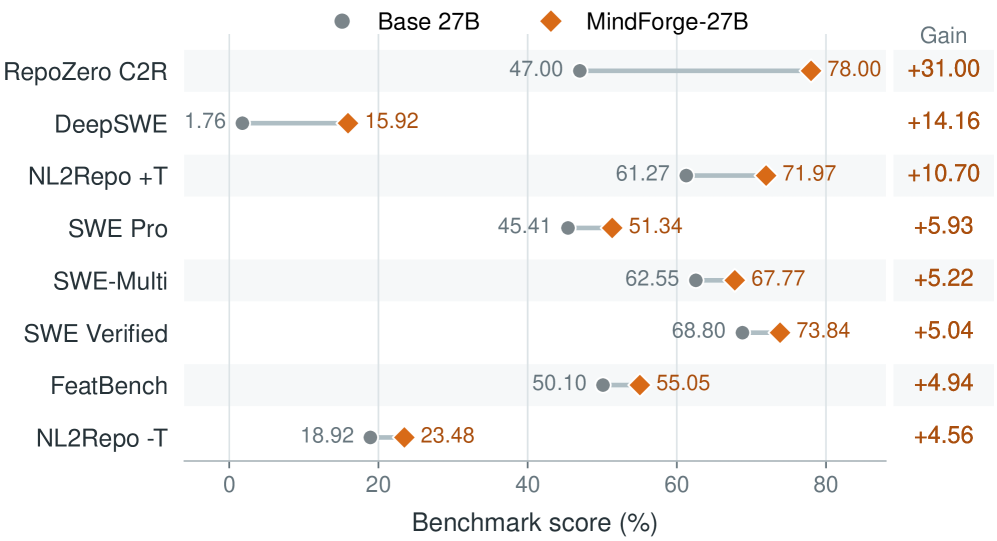
编码智能体在修改现有代码库的软件工程任务(如缺陷修复和功能实现)上取得了显著进展。然而,从零开始构建完整程序仍是一大挑战:即使在 ProgramBench 上评估的前沿模型,也仅能完全解决不到 1% 的任务。一个障碍是缺乏从零开始场景的可扩展训练环境,该场景需覆盖整个软件工程生命周期,而现有环境构建框架仅关注软件开发的单一阶段。 为解决这一问题,我们提出 MindForge,一个自动化流水线,将开源命令行程序转换为无源码环境,仅暴露编译后的可执行文件及其文档。利用 MindForge,我们从与 ProgramBench 不重叠的代码库构建训练环境,并使用 GLM-5.2 作为教师智能体,策划高质量数据配方,包含程序合成轨迹。在 Qwen3.6-27B 上微调这些轨迹后,其 ProgramBench 平均测试通过率从 37.98% 提升至 49.51%,达到与更大规模前沿模型相当的性能。 此外,微调模型在所有七个未见软件工程基准上均持续优于基模型,涵盖长周期仓库生成与翻译、缺陷修复、功能实现及跨语言问题解决,具体绝对提升包括: - RepoZero-C2Rust: +31.00 点 - DeepSWE: +14.16 点 - NL2Repo-Bench(含/不含测试): +10.70/4.56 点 - SWE-bench Verified: +5.04 点 - SWE-bench Pro: +5.93 点 - SWE-bench Multilingual: +5.22 点 - FeatBench: +4.94 点
论文精读
TL;DR MindForge 将开源程序转化为无源码沙盒,蒸馏大模型的全生命周期开发轨迹来训练小模型,使 27B 模型在从零构建程序的 ProgramBench 上逼近前沿大模型,并泛化提升七个软件工程基准。
问题
问题背景
编码代理(coding agents)在软件工程任务中进展显著,但从零开始构建完整程序仍是一个基础而严峻的挑战,即便是最前沿的模型,在 ProgramBench 上的完全解决率也不足 1%。该领域急需能够覆盖软件全生命周期的训练环境与数据。
现有方法局限
现有训练环境构建框架(如 SWE-bench 衍生的环境)高度碎片化:
- 单阶段聚焦:仅覆盖缺陷修复、功能实现等单一开发阶段,无法串联需求 → 设计 → 实现 → 测试的完整链路。
- 依赖源代码:多数环境要求访问源代码仓库,导致难以规模化利用大量编译后的开源命令行程序,限制了训练数据的多样性。
- 轨迹质量低:直接采集的代理交互轨迹常包含环境噪声与无效推理,难以直接用于高效微调。 这些局限使小模型难以从有限数据中学到“从零构建”所需的跨阶段规划与长程决策能力。
困难性与重要性
技术挑战在于:从零构建程序要求模型在没有初始代码骨架的情况下,自主分解需求、生成模块化代码并通过编译与测试验证,涉及长序列推理与频繁纠错。这比修改已有代码库的难度呈指数级上升,因为搜索空间更大且反馈信号更稀疏。业界关注度持续上升:能够完成全流程开发的 AI 代理将极大降低软件开发门槛、加速原型迭代,并可能重构 DevOps 流程。因此,构建可扩展、无源码的训练环境,并合成高质量轨迹以蒸馏能力至中小模型,具有显著的工程价值。
行业类比
类似自动驾驶需要高保真模拟器进行端到端训练,软件工程领域也亟需全生命周期的“驾驶模拟器”,让模型在无源代码的真实二进制与文档环境中闭环学习,才能跨越从代码补全到完整程序生成的能力鸿沟。
核心洞察
- MindForge 展示了“文档驱动、无源码”的编程环境可以迫使模型学习更鲁棒的软件工程推理。与此前依赖完整代码库不同,黑盒设定强制模型通过编译-运行-测试循环进行推理,类似人类面对陌生库的开发过程。产生的轨迹覆盖需求、编码、调试、测试等完整周期,因此微调后的模型能力更全面,泛化性更强,在多个 unseen benchmark 上均有大幅提升,体现了从数据层面重塑小模型 SE 能力的可能性。
- 将全生命周期软件工程轨迹蒸馏到小模型,能实现效率突破,使 27B 模型达到与更大模型比肩的能力。教师 GLM-5.2 在 MindForge 环境探索生成高质量轨迹,微调 Qwen3.6-27B 后 ProgramBench 从 38% 跃升至 49.5%,超越多数更大参数模型;且在修 Bug、加特性等任务上同样显著提升。这表明精心设计的合成数据可以激发小模型在复杂工程任务上的潜力,大幅降低部署成本。
- MindForge 的数据配方重点解决了从零构建程序任务的规模化训练数据缺失问题。当前多数代码智能体基准和训练数据专注于修补现有代码库,而从零构建因缺乏自动化环境构建手段而难以规模化。MindForge 的自动化流水线利用开源仓库自动生成黑盒环境,实现大规模高质量轨迹数据生产,为从“辅助编码”到“自主构建”的进步提供了可行方案。
方法
MindForge 是一个自动化管道,输入 开源命令行程序,输出 可直接用于小模型微调的高质量程序合成轨迹,核心流程 分三阶段:
1. 无源码环境构建
- 自动将开源仓库转化为 source-free 环境:只暴露编译后的可执行文件及文档,隐藏源代码。
- 该环境要求模型仅依赖程序行为探索和自然语言描述完成从零构建,复现全生命周期软件工程流程。
2. 轨迹收集与精炼
- 以 GLM-5.2 作为教师 Agent,在环境中反复尝试程序合成,记录完整交互轨迹(需求分析、设计、实现、调试、测试)。
- 轨迹精炼包含两步:
- 基础设施噪声恢复:修正因编译环境、依赖等非逻辑错误引起的失败轨迹。
- 推理重写机制:将教师模型自身的模糊推理步骤重新组织为清晰、可学习的思维链。
- 最终保留高质量轨迹,覆盖成功与失败案例,并剔除与
ProgramBench数据污染的仓库。
3. 小模型微调
- 以 Qwen3.6-27B 为基座,在精炼轨迹上进行监督微调,无需强化学习或在线交互。
- 微调后模型在
ProgramBench(从零合成完整程序)上测试通过率从 37.98% 提升至 49.51%,逼近大得多的前沿模型。
与同类方法的差异:现有环境构建框架(如 SWE-bench、RepoBench)仅覆盖 Bug 修复或功能新增等单一阶段,而 MindForge 首次提供覆盖软件开发完整生命周期的、无源码的规模化训练环境,并通过教师轨迹蒸馏让较小模型掌握从需求到交付的综合工程能力。
实验
实验设计
MindForge 自动将开源命令行程序转换为 无源码环境(source‑free environment),仅暴露编译好的可执行文件和文档。使用 GLM‑5.2 作为教师代理,在这些环境中生成完整的程序合成轨迹,再通过轨迹微调 Qwen3.6‑27B 基模型。
- 主要评估基准:ProgramBench,衡量从零构建完整程序的能力。
- 泛化评估:7 个未见过的软件工程基准,涵盖 长序列仓库生成与翻译(RepoZero‑C2Rust)、Bug 修复(SWE‑bench 系列)、功能实现(FeatBench)及跨语言问题解决(NL2Repo‑Bench)。
关键发现
在 ProgramBench 上,微调后模型平均测试通过率达到 49.51%(基模型 37.98%),性能与远超其规模的前沿模型相当。此外,所有 7 个泛化基准上均观察到一致提升,绝对增益从 4.94 到 31.00 点不等:
- 从零构建仓库翻译:RepoZero‑C2Rust 增益 +31.00 点
- 完整仓库开发:DeepSWE 增益 +14.16 点
- 指令到仓库合成:NL2Repo‑Bench(有测试)增益 +10.70 点
- 已有代码库修改:SWE‑bench Verified 增益 +5.04 点
这表明通过教师轨迹,小模型可以学会超越修改现有代码的全生命周期软件工程能力,包括从无到有的程序构建。
与基线对比解读
基模型 Qwen3.6‑27B 在 ProgramBench 上的通过率仅为 37.98%,而微调后提升 11.53 个百分点。更值得注意的是,在未参与训练的多个下游任务上,模型均展现出正向迁移,没有出现灾难性遗忘。这不同于以往仅聚焦单一开发阶段(如仅修复 Bug)的环境构造范式,MindForge 提供的环境覆盖需求理解 → 编码 → 测试全流程,使模型能内化更通用的软件工程推理模式。尽管提升幅度因任务而异(简单修改任务增益较小,复杂创造任务增益大),但整体趋势明确:合理设计的数据合成管线能够让较小模型获得与巨型模型竞争的竞争力。
行业影响
落地场景
MindForge 训练的小模型可直接应用于从自然语言需求到完整程序构建的自动化流水线,覆盖 从零开发、遗留代码翻译、Bug 修复 与 功能新增 等全生命周期软件工程任务。产品形态上,可嵌入 低代码/无代码平台 的智能后端生成、IDE 智能助手(如 VS Code 插件)提供完整项目骨架生成、以及 DevOps 流水线 中自动生成脚本或 CLI 工具。对 金融、医疗、自动驾驶 等强合规领域,本地部署的 27B 模型在保护代码隐私的前提下完成自动化开发,显著扩展了应用范围。
商业价值
该技术核心降本点在于大幅减少从需求到可运行程序的人工编码工时。微调后的 Qwen3.6-27B 在 ProgramBench 上的通过率从 37.98% 提升至 49.51%,且无需访问源代码,仅凭文档和可执行文件即可生成程序,意味着企业可安全利用大量内部闭源工具进行训练。此外,该模型在多个跨任务基准(如 SWE-bench Verified +5.04, RepoZero-C2Rust +31.00)上的通用提升,证明单一模型可覆盖多种开发场景,降低多模型维护成本。对中小型开发团队,相当于引入一名可 7x24 小时工作的初级全栈工程师,直接加速产品迭代,缩短上市时间。
与现有产品/工作流的接口
模型可封装为 HTTP API 微服务,与现有 CI/CD 工具链(如 Jenkins、GitHub Actions)集成,在代码评审阶段自动生成补丁或新功能分支;也可作为 Jira 或 Linear 等项目管理工具的后端,将 Issue 描述直接转为初始提交。对于 C2Rust 类翻译任务,模型输出的 Rust 代码可直接送入现有编译检查与测试流水线。由于训练环境是 源码无关的,企业只需提供编译后的可执行文件和手册,无需暴露核心 IP,适合通过容器化方式将模型部署在私有云或本地 GPU 集群,与 VPN 内代码仓库无缝协作。
具体落地用例
- 金融遗留系统现代化:某银行拥有大量 C 语言编写的交易风控命令行工具,文档齐全但源码丢失。利用 MindForge 训练的模型,输入工具的命令行使用说明,自动生成等价 Rust 实现,并伴随单元测试。相比人工重写,成本降低约 70%,且输出代码可直接进入安全审计流水线。
- 电商运维自动化:电商平台需定期批量生成临时数据处理脚本(如折扣计算、库存同步)。运营人员用自然语言描述需求,IDE 插件调用 MindForge 模型生成完整 Python 脚本,并附带文档和错误处理。30% 的任务可无需开发人员介入,释放后端工程师生产力投入核心系统优化。
局限
- **环境构建对源码编译的依赖带来覆盖偏差**。MindForge 要求从开源命令行程序编译出可执行文件,对于缺少标准构建流程、依赖复杂外部库或仅提供解释型语言的仓库可能无法成功构建环境,导致训练集中程序类型受限。此外,探索 Agent 和构建 Agent 的自动化成功率并非 100%,论文筛选管道可能丢弃难以构建的程序,使数据分布偏向于构建简单的项目,从而限制模型在高复杂度任务上的泛化。
- **教师模型与轨迹质量的长尾影响**。GLM-5.2 作为教师策略收集的合成轨迹本身存在推理错误或次优决策,即便经过基础设施噪声恢复和推理重写,仍可能保留不良模式。微调 Qwen3.6-27B 时,模型可能过拟合教师风格的浅层模式,而非学习深层软件设计原则。这一点在跨任务泛化结果中有所体现:在 RepoZero-C2Rust 上提升显著(+31),但在其他基准上增益仅 5–10 点,暗示模型在某些任务类型上仍依赖表面统计。
- **全生命周期覆盖的评估粒度不足**。论文主要使用端到端测试通过率作为衡量指标,忽略了开发过程中的关键中间产出(如需求分析、架构设计、测试编写)的质量。轨迹数据虽记录了多轮交互,但分析主要集中于最终结果,缺乏对单个软件工程活动(如调试、重构)的独立效果验证。这使得难以判断模型在哪些具体阶段存在短板,不利于后续精准优化。长期来看,缺少面向过程的细粒度评估,可能掩盖模型在真实协作式开发中的可用性问题。