OmegaUse-OfficeVal: 对长周期办公套件任务中的LLM智能体进行经济导向的基准测试
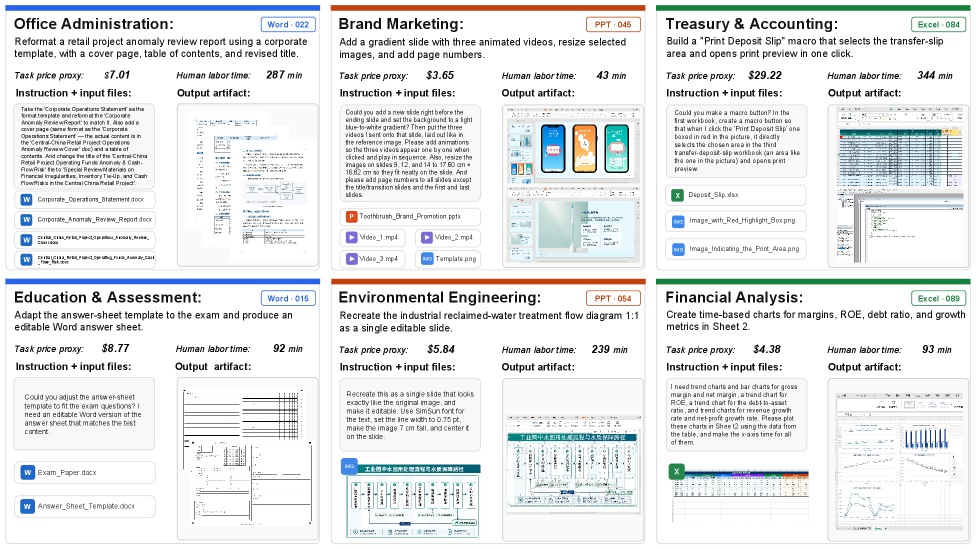
大型语言模型(LLM)智能体日益被期望协助用户完成任务。然而,现有基准在评估智能体能否以合理成本完成办公套件工作流方面支持有限。我们提出 OmegaUse-OfficeVal,一个在长周期办公套件任务上评估 LLM 智能体的基准,并引入任务级经济导向。 该基准包含 100 个任务,来源于从业者提出的办公套件需求,并经过隐私保护流程改编。平均每个任务需要 2.32 小时 的人力劳动。每个任务配有两个经济信号:人工时间和任务价格代理。这些信号可直接比较人力成本与 LLM 推理成本,并支持价值加权评估。 为支持稳定评估,我们基于细粒度评分标准开发了代码验证器。我们评估了多个前沿 LLM 及人类基线。结果表明:尽管所有 LLM 都显著便宜且快于人类,但其交付质量尚未达到人类水平。代码和数据集已完全开源,详见项目网站:https://omegause-officeval.github.io。
论文精读
TL;DR OmegaUse-OfficeVal 首次将经济成本(人工耗时与价格)标注到长周期办公任务基准中,使LLM代理的推理成本与人类成本直接可比,评估显示模型虽快且廉,但交付质量仍不及人类。
问题
LLM agents 正从“vibe coding”迈向“vibe working”,业界呼吁可靠的基准来评估其在真实办公套件任务中的表现与成本。
现有基准如 GDPVal、RLI、ALE 存在明显局限:
- 任务封闭性强,仅发布子集或限制参考输出,难以公平复现;
- 经济信号粗糙,多与宽泛职业类别挂钩,缺乏任务级人类耗时与定价,无法直接对比人力成本与推理开销;
- 侧重短期单一应用,不支持对跨应用、长周期办公工作流的全面评测;
- 缺乏高可靠的代码级验证器,主观评分或简单正则匹配无法准确衡量交付物质量。
长期办公任务涉及文档、表格、幻灯片等多对象操作,步骤多、依赖复杂,且真实场景下质量与成本同等重要。Agent 必须在生成正确结果的同时,将经济成本控制在可接受范围,这要求基准提供细粒度的交付物质量评估与经济参照系,以推动模型在能力与效率间的平衡。
类似自动驾驶需要“每英里成本”评估商用可行性,办公自动化 Agent 也急需一个将交付质量与人类劳动成本直接挂钩的测试框架,才能指导实际部署决策。
核心洞察
- 该基准首次为每项办公任务明确标注人力耗时与价格代理,将评估从“能否完成”推向“完成的质量与成本是否值得”。与仅报告成功率或自动评分的基准(如 GAIA、SWE-bench)不同,OmegaUse-OfficeVal 直接支持经济-质量权衡分析,使决策者能计算任务级成本上限与交付价值,为办公自动化智能体的商用落地提供了可量化的经济锚定。
- 任务源自 100 项真实办公请求(平均需 2.32 小时人力),是首个覆盖长程、跨应用、真实分布的办公套件基准。相较于多数基准依赖课件、短会话或合成用例,该数据集的请求多样性与隐私保护构造流程确保了评估的生态效度,更能反映智能体在持续数小时的文档-表格-演示协同工作中的上下文维护、错误恢复与多步规划能力。
方法
输入与任务定义
OmegaUse-OfficeVal 接收从真实办公场景收集的复杂长周期任务,平均需 2.32 人工小时 完成,涉及文档、电子表格、演示文稿及 PDF 处理。任务源自从业者请求,经隐私保护适应流程脱敏后形成 100 个标准化实例。每个任务附带两重经济信号:
- 人力劳动时间 (human labor time)
- 任务价格代理 (task price proxy)
这两项指标为后续的人机成本对比与价值加权评估提供量化基础。
关键构建流水线
任务采集与适配
从用户真实需求出发,通过众包标注与专家筛选,确保任务覆盖长周期、多步骤工作流,同时删除敏感信息以保障隐私。经济溯源(Economic Grounding)
- 人力劳动时间通过激励相容的标注机制进行估计,反映真实人工耗时。
- 任务价格代理基于市场数据或专家判断,反映任务的社会经济价值,使评估不再局限于正确率,而是将 Agent 产出与人类可交付价值对齐。
细粒度评分与代码验证
- 对每个任务,专家制定细粒度评分标准 (rubric),明确成功交付的必备条件。
- 评分标准经 专家修订 后,自动生成 基于代码的验证器 (code-based verifier)。
- 为消除人码差异,引入 人码分歧解决 步骤,通过人工比对验证器输出与专家判断,迭代优化验证代码,确保评估稳定性。
输出与评估协议
评估时,LLM Agent 在隔离环境中执行任务,交付结果由验证器自动判定。最终任务得分 (task score) 基于评分标准逐条判定后聚合。与经济信号结合,可计算 价值加权得分,从而对比不同模型的性价比。
与同类工作的差异
不同于仅关注功能正确性的基准 (如 GDPVal、RLI),OmegaUse-OfficeVal 通过内建的经济信号使任务价值直接可度量,并将人工与 AI 执行置于同一成本框架下比较,为下一代“自动工作”型智能体提供了更贴近真实部署的评估范式。
实验
实验设计
OmegaUse-OfficeVal 包含 100 个长程办公套件任务,平均人工耗时 2.32 小时。每个任务配备经济接地(人工时间与价格代理)。评估采用代码验证器,基于细粒度评分标准自动计算任务完成质量。基线包括人类工作者,并对比多个前沿 LLM(如 GPT-4、Claude 等),同时比较推理成本与交付质量。
关键发现
所有受测 LLM 在成本与速度上均显著优于人类,但任务交付质量尚未达到人类水平。
模型在长程多步操作、跨应用数据流转及格式保真度方面仍存在明显短板,错误随任务步骤累积,导致最终可交付成果在细节上不可靠。经济信号量化了这种 “便宜但不可用” 的尴尬:即使成本骤降,仍需人工修正才能达到生产级标准。
与基线对比的解读
人类基线展示出稳定的高质量,但耗时、昂贵。LLM 的速度-成本优势在自动化办公场景极具吸引力,然而当前模型的质量瓶颈意味着直接替代并不可行。这一结果提示:实用化路径可能不是单一模型端到端交付,而是人机协同的增量自动化——先由 LLM 出初稿,人类做审校与定稿。OmegaUse-OfficeVal 的经济接地框架为量化此类协同收益提供了量化基础,也为后续研究指明了优化方向:提升长程任务规划的鲁棒性与跨应用状态追踪的准确性。
行业影响
落地场景
OmegaUse-OfficeVal 基准直接服务于智能办公助理、RPA 增强型代理和低代码自动化平台等产品线。其评估的任务覆盖文档撰写、电子表格分析、演示文稿制作与 PDF 处理等高频办公场景,为这些产品提供了可量化的经济价值指标。例如,企业服务软件可以将该基准用于对内部 AI 代理进行回归测试,确保自动化工作流在升级模型后仍能满足交付质量与成本要求;企业级AI 助手(如 Microsoft 365 Copilot、Google Duet AI)亦可将其作为衡量不同底层 LLM 性价比的外部标尺。
商业价值
该基准的核心商业价值在于将 AI 能力直接锚定到经济成本。每个任务都标注了人工劳动时间和任务价格代理,使企业能直接计算 AI 代理替代人工的投入产出比:所有评测的 LLM 在速度和成本上均显著优于人类,但交付质量仍未达到人类水平,这为部署决策提供了清晰的风险收益分析。对于寻求降本增效的团队,可以通过基准筛选出质量可接受的任务类别,先行实现自动化;对于产品厂商,则能以其为卖点向客户证明 AI 功能带来的实际工时节省,辅助定价与营销。
与现有产品/工作流的接口
OmegaUse-OfficeVal 采用基于代码的验证器从细粒度评分标准生成评估,很容易集成到现有 MLOps 流程中。企业可以:
- 将基准套件作为自动化测试集挂载到 CI/CD 管道,在模型或 Agent 脚手架更新时触发评估;
- 透过其开源的数据集和验证代码,将评估逻辑嵌入内部办公自动化平台,自定义类似的经济指标追踪;
- 利用任务经济信号与现有的成本监控系统联动,实时对比不同 Agent 版本的推理费用与人工外包价格,形成动态路由策略(低于阈值自动处理,否则转人工)。
具体落地用例
- 电商运营报表生成:某电商平台的运营团队每周需从大量销售 Excel 中提取数据、制作 PPT 周报。集成该基准可筛选出能在 30 分钟内、以低于 $1 的推理成本完成日报生成的 Agent 方案,替代外包人员,将周报产出周期从天级缩短至分钟级。
- 金融合规文档处理:银行合规部门需将监管政策 PDF 转化为内部分析报告,并填充标准表格。使用 OmegaUse-OfficeVal 可以评测不同 LLM 在理解条款、生成摘要和填写表格上的经济效率,建立质量阈值,自动完成 80% 的常规合规任务,仅将高不确定性案例转交人工复核。
局限
- **任务领域封闭,缺乏开放环境交互**:OmegaUse-OfficeVal 聚焦于文档、电子表格、演示文稿和 PDF 四类办公套件应用,但现实办公场景涉及更广泛的工具(如邮件客户端、会议软件、项目管理平台)以及外部 API 调用。基准中的任务以自包含文件状态为目标,代理无需应对真实世界的网络延迟、权限错误或工具版本迭代,使得评估结果可能高估办公代理的实用鲁棒性。
- **经济信号存在估算偏差与静态假设**:人工工时通过众包工作者完成相同任务并拟合分布得到,但众包样本难以匹配不同地区的薪资差异和技能水平,且任务价格代理仅以固定汇率换算,未考虑动态市场供需。此外,LLM 推理成本高度依赖模型供应商和部署方式,基准给出的成本比较在模型更替或云服务定价变化后可能迅速过时,限制了长期可比性。
- **验证器依赖专家修订,可扩展性受限**:代码验证器从细粒度评分标准生成,但评分标准需领域专家对每个任务逐一设计并修订,对于新任务类型需要重复人工投入。虽然验证器比基于 LLM 的评判更稳定,但这种半自动构建流水线可能难以支持更大规模、更频繁更新的基准,且验证代码本身可能存在与人类判断不一致的角落案例,基准仅通过一轮人工-代码差异解决,未系统化处理持续演化中的评估偏差。