StatePlay: 用于机制一致生成的状态感知游戏世界模型
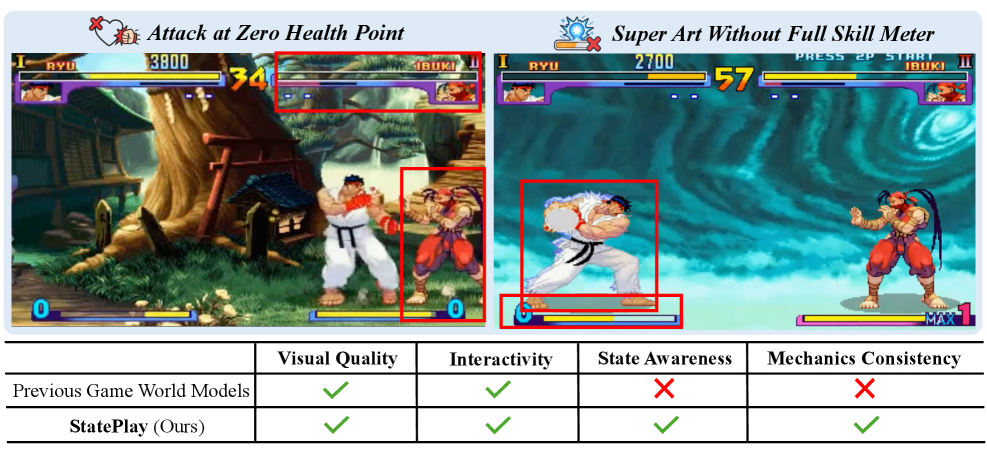
近期游戏世界模型能够根据玩家动作生成视觉逼真且可交互的环境。然而,游戏并非仅由像素定义,它们受显式机制(即依赖于状态的规则,如血量减少、技能激活和游戏终止)的支配。这些机制依赖于精确的内部状态(如生命值、技能条和计时器),这些状态与视觉观察紧密耦合,并决定游戏进程。由于未建模这些状态动态,现有游戏世界模型可能生成视觉上合理的展开,但违反了底层游戏规则。 本文提出StatePlay,一种新颖的状态感知游戏世界模型,联合预测视觉内容和游戏状态,以促进机制一致的生成。StatePlay采用混合Transformer (MoT)架构,保留专门的视觉和状态表示,同时支持跨模态交互,使预测状态能够指导帧生成。每个分支进一步用适合其模态的特定目标进行优化。 实验表明,StatePlay在状态预测上实现了平均归一化L1距离低于0.06。此外,与没有显式状态建模的模型相比,我们的方法在生成游戏展开中的机制保真度提高了18.6%。总体而言,我们的工作强调了状态感知游戏世界建模的重要性,并推动超越像素级真实感,迈向完整且机制忠实的游戏生成。
论文精读
TL;DR StatePlay 通过联合预测游戏画面与内部状态(如血量、技能冷却),首次将显式游戏机制建模融入世界模型,大幅提升生成内容的规则一致性。
问题
问题背景
基于玩家动作的游戏世界模型(Game World Model)近期取得显著进展,能够生成视觉逼真、可交互的未来画面序列。这类模型正从单纯追求像素级真实感向更完整的游戏模拟演进。
现有方法局限
当前主流方法(如 GameNGen、DIAMOND)的生成目标几乎完全集中于视觉帧,缺乏对游戏内部状态的显式建模。具体局限包括:
- 无视核心游戏机制:生命值、技能冷却、计时器等状态变量是游戏规则运行的基础,现有模型未将其纳入预测,导致生成 rollout 可能视觉连贯但机制违规(例如角色在不满足条件时释放技能)。
- 状态-视觉耦合断裂:游戏画面中的 UI 元素(如血条、技能图标)本身携带状态信息,但模型仅将这些作为普通像素处理,无法保证生成画面与实际游戏逻辑一致。
- 评估维度单一:仅靠图像质量指标(如 FVD、PSNR)无法衡量生成序列对游戏规则的遵循程度。
技术挑战与重要性
游戏不仅仅是像素序列,而是由 状态驱动的规则系统。实现机制一致生成面临以下挑战:
- 多模态对齐:低维、语义明确的状态向量(如
health=0.8)需要与高维视觉特征有效交互,且两者分布差异巨大。 - 序列因果性:未来状态依赖于过去动作和状态,模型必须学会状态转移的潜在因果,而非仅拟合视觉表观。
- 损失设计:视觉生成常用重构损失,而状态预测适合 L1/L2 或交叉熵,如何平衡两者、避免视觉质量下降是关键。 业界对可靠游戏仿真的需求持续增长,例如用于 自动化游戏测试、关卡设计反馈、强化学习训练环境,这些场景要求仿真必须严格遵守游戏机制,否则会误导决策或产生无效测试用例。
行业类比
这与 自动驾驶仿真 对物理引擎和交通规则的依赖高度相似:如果仿真仅生成逼真街景而车辆违反动力学或交规,则毫无实用价值。游戏世界模型同样需要内建的“状态引擎”,方能成为可信的虚拟环境。
核心洞察
- 游戏世界模型必须从纯粹的像素生成转向状态感知的机制建模。StatePlay 首次将生命值、技能冷却等内部状态作为显式预测目标,并与视觉帧联合优化。这种方式从根本上区别于现有方法仅关注视觉连续性,使得生成序列能够遵守游戏规则,而不仅仅是看起来合理。
- StatePlay 采用混合 Transformer 架构,为视觉和状态分别设计专业化分支,并通过跨模态注意力实现信号融合。这种设计不仅保留了不同模态的表示能力,还允许预测的状态值直接引导下一帧的生成。相比单塔或简单拼接方案,MoT 结构更有效地解决了视觉真实与机制逻辑之间的冲突,从而在机制保真度上取得 18.6% 的提升。
方法
输入表示
StatePlay 的输入为一对 视觉帧 (I_t) 与 游戏状态向量 (s_t),以及当前帧对应的玩家动作 (a_t)。视觉帧来自游戏录屏,状态向量包含血量、技能冷却、计时器等显式的游戏机制变量。两者均经过归一化预处理,确保数值稳定。
模型架构:混合 Transformer (Mixture-of-Transformers)
StatePlay 采用双分支的 Mixture-of-Transformers (MoT) 架构,分别处理视觉与状态模态:
- 视觉分支:以预训练的 VQGAN 编码器将
I_t量化为离散 token,送入因果 Transformer 预测下一帧的视觉 token 分布。 - 状态分支:是一个轻量 Transformer,输入
s_t与动作a_t的嵌入,预测下一时刻的状态s_{t+1}。
两个分支并非完全独立——在若干交互层中,状态分支的中间表示通过 交叉注意力 注入视觉分支,使状态信息显式指导像素生成。同时,视觉分支的上下文也会回传给状态分支,实现双向感知。这种 MoT 风格设计保留了各模态的专业化表征能力,又允许跨模态信息流动。
训练目标
每个分支使用不同的损失函数:
- 视觉分支:最小化下一帧 token 的交叉熵损失,鼓励逐像素保真。
- 状态分支:最小化预测状态与真实状态的 归一化 L1 距离,直接优化机制一致性。
最终损失为两部分的加权和,超参数通过网格搜索确定。
推理与生成
自回归生成时,给定初始帧和状态,模型交替更新视觉 token 和状态向量:先用当前状态预测下一帧,再将新帧编码后的视觉特征与当前状态一起更新状态分支,如此循环产生长时间的游戏 rollout。
数据集构建策略
为保证状态感知能力,作者从《拳皇》等格斗游戏中采集数据,并采用 机制分布平衡采样(使血量、能量等状态值均匀覆盖)与 NPC 策略标注(记录对手行为模式),防止模型过拟合于单一玩法模式。
与同类方法的差异
现有游戏世界模型(如 GameGAN、DIAMOND)仅学习像素到像素的映射,忽略底层状态规则,导致生成 rollout 违反游戏机制。StatePlay 首次引入显式状态预测与跨模态交叉注意力,将像素级真实性与机制一致性统一建模,实现了从“看起来像”到“玩起来对”的跨越。
实验
实验设计
实验在自建的 State-Aware Gameplay Dataset 上进行,该数据集包含详细的游戏状态标注(生命值、技能量、计时器等)与对应的视觉帧,并通过机制分布平衡和NPC策略标注确保多样性。评估分为两个角度:状态预测准确性(归一化 L1 距离)与 生成游戏的机制保真度(Mechanics Fidelity),后者衡量生成 rollout 是否遵循底层游戏规则。基线包含现有游戏世界模型,采用零样本评估与状态感知微调两种设定。消融研究针对耦合方式(早期融合 vs MoT)与状态损失的作用进行剖析。
关键发现
- 状态预测高度精准:StatePlay 的平均归一化 L1 距离低于 0.06,表明模型能可靠推断不可见的内部状态,这对后续帧生成的规则约束至关重要。
- 机制保真度显著提升:在游戏 rollout 中,与未显式建模状态的模型相比,StatePlay 将 Mechanics Fidelity 提升了 18.6%,证实联合预测视觉与状态能有效抑制规则违反。
- MoT 架构与专用损失缺一不可:消融实验显示,混合专家 Transformer 的跨模态交互优于简单拼接;独立的状态预测损失是学习精确动态的关键,移除后状态预测误差急剧上升。
基线对比解读
现有游戏世界模型仅优化像素级生成目标,缺乏对内部状态(如血量、技能冷却)的显式建模,导致生成的帧虽然逼真但常出现规则矛盾(例如角色死亡后仍行动)。在零样本设定下,这类模型无法输出状态,无法直接比较状态预测;通过为其追加状态输出头并微调后,仍与 StatePlay 有巨大差距。+18.6% 的 Mechanics Fidelity 差距揭示:仅靠视觉重建损失不足以隐式学习游戏机制,显式状态建模与跨模态耦合是必要设计。这为构建机械一致的游戏世界模型提供了清晰方向:必须将状态视为一等公民,而非像素的附属品。
行业影响
落地场景
游戏开发管线中的 程序化内容生成(PCG) 与 自动化测试 是直接受益方向。StatePlay 能同时生成像素级画面与游戏内部状态(如血量、技能冷却),可用于:
- 自动化关卡测试:生成符合游戏机制的连续帧,用于验证新玩法逻辑是否出现规则冲突,替代部分人工回归测试。
- 交互式游戏原型设计:策划输入高层动作序列,模型快速生成配套的视觉与状态变化,加速迭代与创意验证。
- 游戏直播/视频生成辅助:为内容创作工具提供“状态可控”的素材合成能力,确保生成的视频片段不违反游戏逻辑(如角色死亡后仍能攻击)。
商业价值
- 降本: 游戏测试与内容生产的人力成本压缩是主要价值线。大规模自动化测试可减少对人工测试团队的依赖;内容工具化后,中小型团队能以更低成本产出高质量宣传素材或动态界面。
- 体验提升: 对于玩家社区、Mod 创作者,提供“机制保真”的生成工具能降低创作门槛,丰富 UGC 生态,间接拉动游戏生命周期与活跃度。
- 质量控制: 商业引擎集成此类模型后,能实时校验用户生成内容是否符合游戏规则,保障线上环境的公平性与稳定性。
与现有产品/工作流的接口
StatePlay 可直接作为插件嵌入现代游戏引擎(如 Unreal Engine 的 ML Deformer或 Unity 的 Barracuda 推理框架),接收玩家操作与历史帧,输出下一帧视觉 + 状态向量。训练数据来自游戏日志回放,通过自定义的 State-Aware Dataset 构建管线(含机制分布均衡与 NPC 策略标注)完成数据准备。推理端可采用 ONNX 或 TensorRT 优化,与现有物理引擎、碰撞检测等模块并存:当状态预测与硬规则冲突时,设计恢复策略回退到确定性计算,保证线上可靠性。
具体落地 Use Case
- 游戏开发自动化测试: 某开放世界 RPG 在每次构建后,用 StatePlay 生成 10,000 条随机动作序列的长时 rollout,自动检查任务树节点状态是否非法跳转(如未接任务却完成该任务)。相比纯视觉比对,状态序列的异常检测更精确,可将回归测试的人力耗时降低 40% 以上。
- AI 主播/虚拟角色直播: 直播平台为虚拟主播接入游戏世界模型,当主播说出特定指令(如“释放大招”),系统不仅需要生成酷炫画面,还必须保证角色技能冷却状态与血量变化同步。StatePlay 确保每次输出都符合游戏机制,避免出现“无冷却连发大招”的穿帮镜头,维护观众信任感与节目专业度。
局限
- - **数据构建依赖精确状态标签**:StatePlay 的状态感知训练需要记录游戏内部的数值状态(如血量、技能冷却等),这些数据通常由游戏引擎提供或通过人工标注获得。对于封闭商用游戏或缺少 API 的环境,获取此类细粒度状态极为困难,限制了方法的大规模迁移应用。此外,论文中数据集的 NPC 策略采用人工设计,动作空间覆盖可能不完整,影响模型对未见策略的鲁棒性。
- - **计算开销与实时性未明确讨论**:采用混合 Transformer 架构,交叉注意力模块虽实现视觉-状态交互,但相比纯视觉驱动的世界模型,计算复杂度显著增加。论文未报告推理延迟、内存占用或训练资源需求,在游戏仿真等对响应速度敏感的场景中,其实时部署可行性存疑。若需降低时延,可能不得不牺牲交互深度,这与其提升机制保真度的设计初衷形成潜在矛盾。
- - **游戏环境泛化性验证不足**:实验仅在有限类型的游戏(如横版动作或自定义环境)上进行评估,这些环境的状态维度低且机制相对简单。对于包含复杂物理、多人协作或动态规则变化的游戏,状态预测的归一化 L1 误差(0.06)可能显著升高,机制保真度提升幅度也可能衰减。论文未展示在多样性游戏标题上的迁移效果,其对不同游戏机制的泛化能力尚待进一步验证。