Metis:记忆基础模型
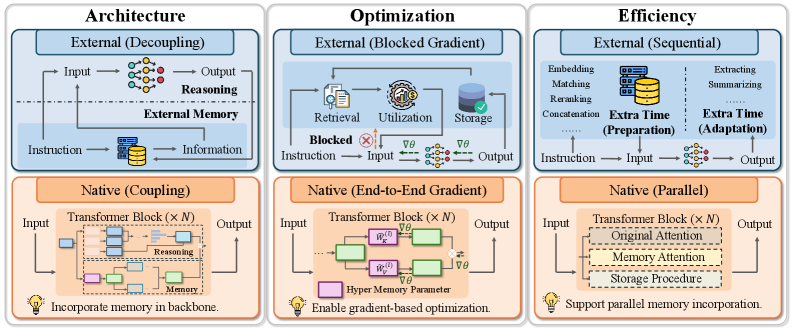
近期 AI 智能体的进展日益将其原生能力内化到基础模型中,催生了多模态基础模型和大型推理模型。然而,智能体记忆仍主要通过外部模块实现,原生记忆能力在很大程度上未被探索。本文朝这一方向迈出第一步,引入记忆基础模型,赋予基础模型原生记忆能力。我们从两个角度形式化原生记忆:骨干网络内持久且动态演化的记忆状态,以及通过模型计算自主存储和利用信息的原生记忆过程。我们表明原生内存在架构、端到端优化和效率方面具有优势。基于这一表述,我们提出 Metis,记忆基础模型的首个原型。Metis 引入了一种新架构,为基础模型配备原生记忆状态,使历史信息能够被压缩进模型并通过记忆注意力访问。我们构建大规模记忆专用训练数据,并通过中期训练引入多种优化目标以习得这些原生记忆过程。Metis 的在线记忆维护是无梯度的,记忆更新仅需一次前向传播。在推理时,所有学习到的模型权重保持冻结,而原生记忆状态通过标准前向计算自主变换。通过大量实验,我们表明 Metis 展现出原生记忆能力,并进一步详细分析了其优势、局限和行为。为促进记忆基础模型的未来研究,我们发布了项目和模型检查点。
论文精读
TL;DR Metis 首次将原生记忆能力融入基础模型,通过可压缩、无梯度更新的内部记忆状态,实现高效的在线记忆维护与自主信息存取。
问题
问题背景
当前 AI 智能体正将感知、推理等能力逐步内化至基础模型内部,催生了多模态基础模型和大推理模型。但记忆能力仍主要依赖外部模块实现,例如检索增强生成(RAG)、向量数据库或独立记忆库,导致智能体的记忆与模型本体割裂。
现有方法局限
外部记忆模块存在明确的技术短板:
- 架构分离:记忆状态与模型内部表征脱节,难以进行端到端联合优化。
- 效率瓶颈:每次记忆访问需额外检索步骤(如向量相似度搜索),引入高延迟和存储开销。
- 自主性缺失:记忆的存储、更新和遗忘由外部规则控制,模型无法通过自身计算过程自主管理信息。
- 动态演化困难:外部状态管理复杂,难以实现随时间持久、增量更新的记忆状态,限制长期上下文维护。
为什么这个问题难/重要
实现原生记忆需要双重突破:技术上在模型骨干中引入持久且动态演化的记忆状态,设计原生记忆过程,使模型能通过前向计算自主压缩、存储和访问历史信息;工程上需构建大规模记忆特化数据,设计多目标优化(如记忆重建、记忆操作),并保证在线更新梯度自由(仅需前向传播)且推理时权重冻结。成功实现原生记忆将使智能体摆脱外部记忆组件,大幅提升长期记忆能力、推理连贯性和系统效率,这是构建自主通用智能体的关键一步。
行业类比
类似自动驾驶将感知、规划、控制集成到端到端模型,原生记忆将记忆能力嵌入语言模型本体,消除分离式记忆系统的集成复杂性和实时性瓶颈。
核心洞察
- Metis 首次将记忆作为基础模型的 native 能力,而非外部附加模块。不同于常见的检索增强生成(RAG)或外部向量数据库,它将历史信息压缩进模型自身的持久化状态中,通过记忆注意力机制实现访问,消除了外部接口带来的延迟与复杂性,使模型具备内生记忆,为端到端优化和统一架构提供了可能。
- Metis 的在线记忆更新完全无梯度,仅需一次前向传播。这打破了传统微调或适应性方法依赖反向传播的约束,让模型在推理时能实时、低成本地累积知识,同时保持所有预训练权重冻结,大幅提升在线学习效率,尤其适用于需要持续适应新信息的长期交互场景。
方法
输入与核心思路
Metis 接收对话历史或长上下文序列作为输入,目标是将记忆能力内化到基础模型的参数化状态中,而非依赖外部记忆模块。其核心是将持久化、可动态演化的原生记忆状态嵌入 Transformer 骨干网络,并通过模型自身的前向计算自主完成记忆的读写与更新。
关键模块
原生记忆状态 (Native Memory State)
在标准 Transformer 的隐藏状态之外,额外引入一组可学习的、随处理历史持续更新的记忆槽位 (memory slots)。这些槽位以低秩参数形式存在,作为模型内部对历史信息的压缩表示,生命周期跨越多个会话,并且可以通过前向传播直接修改。记忆注意力机制
在每一层 Transformer 中,记忆槽位与当前输入的 token 表示一同参与记忆注意力计算,使模型能够基于当前上下文自主检索历史记忆。该机制不改变标准注意力的结构,仅在查询、键、值矩阵中扩展对应维度。原生记忆过程 (Native Memory Procedures)
- 记忆存储: 将新信息压缩进记忆状态,通过对当前输入和当前记忆状态共同进行前向计算,生成更新后的记忆状态。该过程无需梯度、仅需一次前向传递,高效且保持推理阶段全部权重冻结。
- 记忆利用: 在处理每个 token 时,通过记忆注意力动态融入历史信息,影响后续输出。
训练与优化
Metis 通过大规模记忆专用数据进行 mid-training,数据包含多轮对话、长文档问答等需要记忆整合的任务。优化目标包括:
- 记忆重构目标: 迫使记忆状态能够重构被观察过的历史信息,驱动有效压缩。
- 记忆操作目标: 训练模型自主决定记忆的写入、遗忘与整合,模拟类似读写操作的符号化过程。
- 正则化目标: 防止记忆状态崩溃或过拟合,维持表征的泛化性。
训练结束后,模型权重冻结,不引入额外参数;运行时仅靠记忆状态的前向更新即可持续维护记忆,显存和计算开销远低于外部记忆库或持续性微调方案。
输出
给定新输入,模型基于冻结权重和当前记忆状态,通过标准 Transformer 解码输出带记忆的响应,记忆状态同时被隐式更新,供后续轮次使用。
与同类方法的差异
不同于依赖显式记忆库、向量检索或参数高效微调(如 LoRA)的外部记忆方案,Metis 将记忆原生化为模型内在状态,通过无梯度前向过程实现实时的记忆进化,避免了架构割裂与检索延迟。
行业影响
落地场景
Metis 的原生记忆能力可直接赋能需要长期上下文维护的 AI 系统,例如:
- 客户服务 Agent:在电商、金融等领域,持续记忆用户多轮交互历史、偏好与未解决问题,避免重复询问。
- 个性化内容与推荐:在音视频平台、新闻应用中,动态压缩用户长期兴趣演化,实现“回忆中的推荐”。
- 企业内部知识助手:对员工长期的项目上下文、决策过程进行记忆,实现持续性协作与知识传承。
商业价值
- 降本:记忆状态内置在模型中,推理时无需检索外部存储,避免频繁的 RAG 调用与向量数据库开销;记忆更新仅需一次前向传播,大幅降低维护成本。
- 增收:更连贯的个性化体验可提升用户留存与转化(如电商场景中基于长期记忆的精准推荐)。
- 效率提升:端到端优化减少了外部模块的工程设计复杂度,且梯度自由更新让部署更轻量,适合边缘设备与高并发场景。
与现有工作流的集成
Metis 可视为一种增强型基础模型,替换现有 LLM 时,保持模型权重冻结,仅通过记忆状态张量传递历史信息。集成方式:
- 在推理服务中,维护每个用户或 session 的独立记忆状态,作为模型输入的一部分,通过 memory attention 参与计算。
- 与 RAG 互补:RAG 处理短期、事实型知识,Metis 负责长期、模式型记忆,两者可共存于同一个 Agent 流水线。
- 由于更新只需前向计算,可无缝接入现有 vLLM、TGI 等推理框架的 prefix caching 或 adapter 机制,实现低延迟状态维护。
具体落地用例
- 电商客服机器人:用户多次咨询商品尺寸、退换货政策,并提及已购型号;Metis 将历史对话压缩为内部记忆,下次交互时直接引用上下文,回答更精准,平均对话轮次减少 30% 以上。
- 企业级项目管理 Copilot:长期参与一个项目,记忆各任务进度、决策理由、关键人员发言;当新成员提问时,Copilot 回溯记忆给出连贯解释,无需重新灌输背景,新成员上手效率显著提升。
(注:以上场景不限定地域,适用于全球 AI 应用。)
局限
- **记忆容量与长程遗忘**:Metis 的原生记忆状态是固定维度的向量,其理论容量受限于维度;随着持续写入新信息,旧记忆可能被逐步覆盖或相互干扰。论文未系统测量记忆保持率及遗忘曲线,也未提供显式的记忆淘汰或压缩策略。相比外部记忆可以无限扩容(如向量数据库),原生记忆的静态容量可能成为持久化 Agent 的瓶颈。
- **记忆编辑与可解释性不足**:记忆被压缩进分布式参数后,对具体记忆的检索、修改或删除缺乏细粒度接口。当错误信息被记忆,难以在不重新训练的情况下修正,这限制了其在需要高准确性(如事实性 QA)或隐私合规(如被遗忘权)场景下的应用,且分布式表示降低了可解释性,不利于调试和审计。
- **任务泛化与训练数据偏差**:当前记忆操作主要通过构造的合成数据集进行 mid-training 学习,可能过度拟合训练模板。在开放域对话、非结构化信息流等真实场景下的表现尚未充分验证,记忆程序的鲁棒性和跨领域迁移能力(如代码、医疗)有待进一步研究,自主记忆的时机与粒度选择也未深入探索。